
Contenido duplicado y canibalización SEO en 2026: cómo detectarlos y solucionarlos
Por Daniele Forciniti
El contenido duplicado y la canibalización SEO son dos problemas distintos que casi siempre se meten en el mismo saco. Hay contenido duplicado cuando la misma página, o casi la misma, se puede abrir desde varias direcciones: Google elige una e ignora las demás. Hay canibalización cuando dos páginas distintas de la misma web responden a la misma búsqueda y compiten entre sí. Ninguno de los dos provoca una penalización, pero los dos pueden hacerte perder posiciones, porque Google muestra la página equivocada o reparte la fuerza de la web entre varias páginas. Se detectan con Search Console y se solucionan con una redirección 301, una etiqueta canonical o fusionando contenidos.
En esta guía tienes la diferencia entre los dos problemas explicada de forma sencilla, qué hace de verdad Google cuando encuentra páginas parecidas, las causas más habituales (con un apartado dedicado a WordPress), cómo encontrarlos paso a paso en Search Console, cuándo dos páginas con la misma palabra clave no son un problema y qué solución usar en cada caso, con los errores que conviene evitar.
Por qué este tema es importante
Las páginas que compiten entre sí son uno de los problemas más habituales que encuentro cuando analizo una web, y casi nunca el propietario sabe que lo tiene. La web crece, se escriben artículos, se añaden páginas de servicio, se cambia de plantilla, se añade un filtro a la tienda. Al cabo de unos años hay tres páginas que hablan de lo mismo y ninguna de las tres posiciona bien.
Es también uno de los puntos de la gestión SEO de la web que se arregla una vez y luego hay que vigilar, porque vuelve a aparecer cada vez que se publica algo nuevo sin mirar lo que ya existe. Y con las respuestas de las inteligencias artificiales cuenta todavía más: cuando un sistema tiene que elegir una sola página para citar, es mejor que la elección esté clara, y que sea la correcta.
Contenido duplicado y canibalización: no son lo mismo
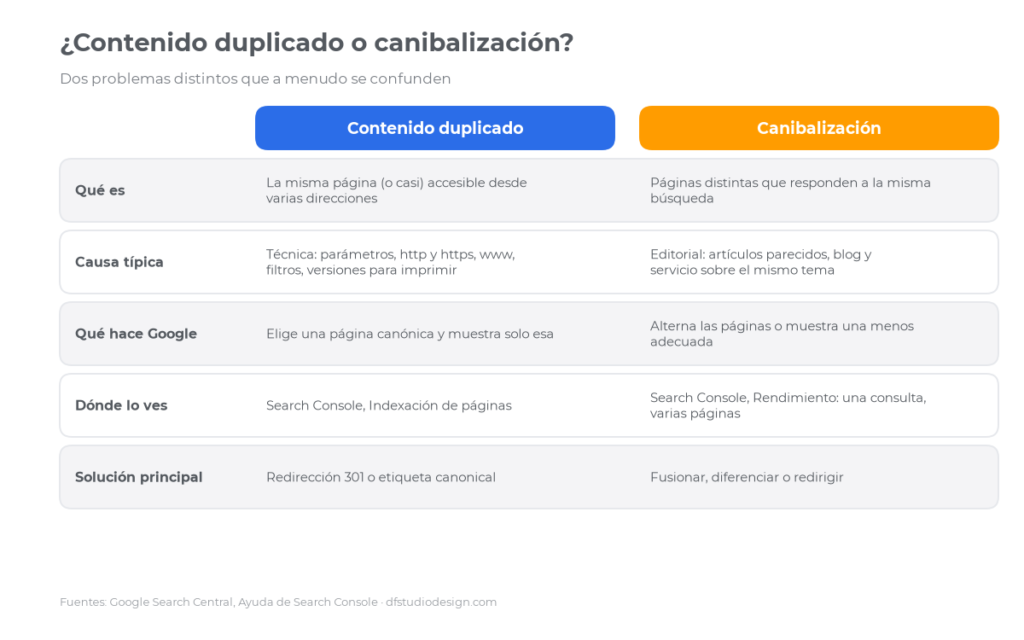
La diferencia es sencilla, pero cambia la solución:
- Contenido duplicado: es la misma página, o una casi idéntica, accesible desde varias direcciones. Por ejemplo, la versión con y sin www, la de http y la de https, o la página de una categoría ordenada por precio o por nombre. El contenido es el mismo, solo cambia la URL. Normalmente la causa es técnica.
- Canibalización: son páginas distintas, escritas en momentos distintos, que responden a la misma pregunta. Por ejemplo, un artículo «Cuánto cuesta una página web», otro «Precios de una web en 2025» y la página de servicio «Diseño web: precios». Los textos son diferentes, pero para Google responden a la misma búsqueda. Normalmente la causa es editorial.
Un detalle que explica muchas cosas: la palabra «canibalización» no aparece en la documentación de Google. Google habla de contenido duplicado y de canonicalización, es decir, de la elección de la página «canónica», la que representa a un grupo de páginas parecidas. La canibalización es un término que nació entre quienes hacemos SEO para describir el efecto práctico: dos páginas tuyas que se quitan espacio la una a la otra.
¿Google penaliza el contenido duplicado?
No. Lo dice la propia Google en su guía sobre la canonicalización: tener algo de contenido duplicado en una web es normal y no infringe sus políticas contra el spam. Lo repite desde 2008, cuando publicó en su blog oficial un artículo titulado precisamente Demystifying the duplicate content penalty, para desmontar el miedo a una penalización que no existe.
Las cosas cambian cuando la duplicación se hace a propósito para engañar. Las políticas de Google contra el spam prohíben copiar contenido de otras webs para posicionar (el scraping) y generar páginas en masa con el único objetivo de manipular la búsqueda. Son prácticas muy distintas de una web que, sin querer, tiene dos direcciones para la misma página.
Así que no hay que temer un castigo. Pero hay que saber que el contenido duplicado y la canibalización te hacen perder algo aunque no haya penalización, y es lo que vemos ahora.
Qué pasa de verdad cuando dos páginas compiten
Esto es lo que hace Google, según su documentación, y lo que significa en la práctica:
- Elige una sola página. Google agrupa las páginas que tienen el mismo contenido principal, o casi, y elige una como canónica: la que considera más completa y útil. Las demás no aparecen en los resultados y además su rastreador las visita con menos frecuencia. La guía aclara que tu preferencia es una sugerencia, no una norma: Google puede elegir una página distinta de la que indicas.
- Muestra como mucho dos resultados de la misma web. En la guía de sistemas de clasificación Google explica el sistema de diversidad de sitios: en general no muestra más de dos páginas de la misma web entre los primeros resultados. Tener cinco artículos sobre el mismo tema no te da cinco posiciones.
- Puede alternar las páginas. Es la señal más típica de la canibalización: para la misma búsqueda, un día aparece el artículo, al día siguiente la página de servicio, luego otra vez el artículo, y ninguna de las dos se queda estable arriba.
- Reparte la fuerza de la web. Si los enlaces externos e internos llegan un poco a una página y un poco a la otra, ninguna de las dos recoge todo el valor que podría tener.
- Puede mostrar la página equivocada. Pasa a menudo que, para una búsqueda comercial como «presupuesto página web», Google elija un artículo antiguo del blog en lugar de la página de servicio con el formulario. La visita llega, pero a la página que convierte menos.
Las causas más habituales
Estas son las situaciones que más encuentro cuando analizo una web. Las primeras son técnicas y crean duplicados; las últimas son editoriales y crean canibalización.
| Causa | Ejemplo | Tipo |
|---|---|---|
| Versiones del dominio | http y https, con y sin www, todas accesibles | duplicado |
| Barra final y mayúsculas | /servicios y /servicios/, o /Servicios/ | duplicado |
| Parámetros en las URL | ?utm_source=, ?ref=, ?sessionid= | duplicado |
| Filtros y ordenaciones de la tienda | ?orderby=price, ?color=rojo | duplicado |
| Archivos del blog | la misma lista de artículos en categorías, etiquetas y archivos por fecha | duplicado |
| Versiones para imprimir o en PDF | la misma guía en página y en PDF | duplicado |
| Web de pruebas indexada | staging.miweb.es o una copia de demostración abierta a los buscadores | duplicado |
| Traducciones a medias | páginas en dos idiomas con el texto principal todavía igual | duplicado |
| Artículo actualizado con una URL nueva | «guia-2025» y «guia-2026» las dos online, sin redirección | canibalización |
| Blog y servicio sobre el mismo tema | artículo y página de servicio que responden a la misma búsqueda | canibalización |
| Artículos demasiado parecidos | «cómo elegir» y «guía para elegir» el mismo producto | canibalización |
| Páginas locales calcadas | veinte páginas «servicio + ciudad» con el mismo texto y el nombre cambiado | los dos |
La última fila merece una nota: las páginas por ciudad hechas con el mismo texto no son solo un duplicado. Si son muchas y se crean solo para posicionar, pueden entrar en lo que Google llama abuso de contenido a escala, una de las prácticas prohibidas en sus políticas contra el spam. Una página local tiene sentido cuando cuenta de verdad ese lugar: proyectos hechos allí, dirección, opiniones de clientes de la zona.
El caso de WordPress
Como muchas webs están hechas con WordPress, estos son los puntos que conviene revisar en concreto:
- Categorías y etiquetas: si cada artículo tiene cinco etiquetas y cada etiqueta tiene su página, se crean decenas de páginas con la misma lista de artículos. En general conviene usar pocas etiquetas o excluir sus páginas del índice desde el plugin de SEO, y mantener indexadas las categorías que tienen un texto de introducción.
- Archivos de autor y por fecha: en una web con un solo autor, el archivo de autor es idéntico al blog. Los archivos por fecha casi nunca le sirven a quien busca.
- Páginas de adjuntos: por cada imagen subida, WordPress podía crear una página con solo esa imagen. Desde la versión 6.4 estas páginas están desactivadas por defecto en las webs nuevas, pero en las más antiguas siguen activas hasta que las apagas.
- Paginación de comentarios y parámetros: direcciones como ?replytocom= crean copias del mismo artículo.
- Plugins de SEO: casi todos añaden solos la etiqueta canonical a cada página. El problema aparece cuando dos plugins la añaden a la vez, o cuando la plantilla la escribe a mano, y en la misma página hay dos canonical distintas.
Cómo encontrarlos con Search Console
No hacen falta herramientas de pago para empezar. Search Console te da casi todo, si sabes dónde mirar.
1. Las consultas con varias páginas (canibalización)
- Abre Rendimiento y selecciona los últimos 3 o 6 meses.
- En la pestaña Consultas elige una búsqueda importante para ti y haz clic en ella: se convierte en un filtro.
- Abre la pestaña Páginas. Si ves dos o más páginas de tu web con impresiones para esa búsqueda, has encontrado una posible canibalización.
- Compara las fechas: si las páginas se van turnando con el tiempo, la canibalización es real.
Ojo con un detalle que explica muchos números raros. Según la ayuda de Search Console, cuando los datos se agrupan por propiedad, es decir, en la pestaña Consultas, varios enlaces de tu web en el mismo resultado cuentan como una sola impresión. Cuando los miras por página, cada página tiene las suyas. Por eso la suma de las páginas no cuadra con el total de la consulta: no es un error, es la forma en que cuenta Google.
2. Los duplicados en el informe Indexación de páginas
En el informe Indexación de páginas tienes los motivos por los que algunas páginas no están indexadas. Los que tienen que ver con duplicados son tres, y la ayuda oficial explica qué significan:
| Estado en el informe | Qué significa | Qué hacer |
|---|---|---|
| Página alternativa con etiqueta canónica adecuada | La página apunta correctamente a la versión principal, que está indexada | Nada: funciona como debe |
| Duplicada: el usuario no ha indicado ninguna versión canónica | Google la ha considerado un duplicado y ha elegido por su cuenta otra página | Comprueba cuál ha elegido. Si es la equivocada, indica tú la canónica |
| Duplicada: Google ha elegido una versión canónica diferente a la del usuario | Has indicado una canónica, pero Google ha preferido otra página | Compara las páginas: si no son parecidas, corrige la canonical o diferencia los contenidos |
3. La herramienta de inspección de URLs
Pega una dirección en el campo de arriba. En el apartado de indexación, la herramienta de inspección de URLs te muestra dos líneas: la canónica declarada por ti y la elegida por Google. Si coinciden, bien. Si son distintas, ahí es donde tienes que trabajar.
4. La comprobación rápida en Google
Busca en Google site:tuweb.es «palabra clave», cambiando tu dominio y la búsqueda que te interesa. Si aparecen muchas páginas tuyas que hablan de lo mismo, es una señal de alarma. No es un dato preciso como Search Console, pero en treinta segundos te da una idea.
Cuándo dos páginas con la misma palabra clave no son un problema
Aquí se equivoca mucha gente, y es la razón por la que se hacen daños intentando arreglar un problema que no existe. Dos páginas pueden aparecer para la misma búsqueda sin competir, si responden a necesidades distintas:
- Una guía y una página de servicio: «cómo elegir un hosting» (quien quiere entender) y «hosting para WordPress» (quien quiere contratar). Si Google muestra una para las búsquedas informativas y la otra para las comerciales, todo va bien.
- Una categoría y un producto: la página «zapatillas de trail» y la ficha de un modelo concreto.
- Idiomas distintos: la misma página en español y en italiano no es un duplicado si el texto principal está traducido. Eso sí, hay que conectarlas con hreflang, como explico en la guía sobre las webs multilingües.
- Dos resultados en primera página: si tus dos páginas ocupan juntas la primera y la segunda posición y se mantienen estables, no las toques. Es un buen resultado, no un problema.
La pregunta correcta no es «¿dos páginas tienen la misma palabra clave?», sino «¿responden a la misma pregunta de la misma persona?». Si la respuesta es no, basta con aclarar los títulos y los textos de las dos páginas.
Cómo solucionarlos: la solución adecuada para cada caso
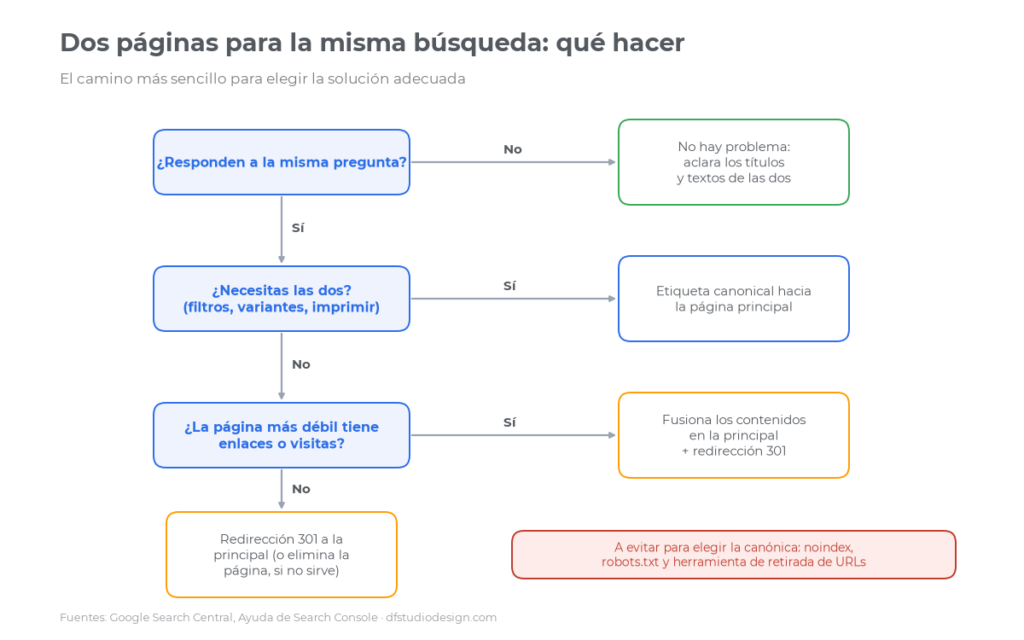
Google, en su guía para indicar la URL canónica, ordena los métodos según la fuerza de la señal: la redirección es una señal fuerte, la etiqueta canonical es una señal fuerte y el sitemap es una señal débil. Así se elige:
| Situación | Solución | Por qué |
|---|---|---|
| http/https, www, barra final | Redirección 301 de toda la web hacia una sola versión | Las variantes no le sirven a nadie |
| Filtros, ordenaciones, parámetros de seguimiento | Etiqueta canonical hacia la página sin parámetros | Las páginas sirven para navegar, pero no hay que indexarlas |
| Dos artículos sobre el mismo tema | Lleva lo mejor al más fuerte y redirige el otro con un 301 | Una página completa vale más que dos a medias |
| Guía antigua de 2025 y nueva de 2026 | Actualiza la antigua, o redirección 301 de la antigua a la nueva | Así también pasa el valor de los enlaces que ya tenía |
| Artículo que le quita la búsqueda a la página de servicio | Reescribe el artículo con un enfoque informativo y enlaza la página de servicio | Cada una responde a una intención distinta |
| Página inútil, sin visitas ni enlaces | Elimínala (responderá 404 o 410), o redirige si tiene un equivalente | Menos páginas débiles, web más clara |
Fusionar y redirigir
Es la solución más eficaz para la canibalización real. Elige la página más fuerte (la que tiene más visitas, enlaces y posiciones), lleva a ella las partes útiles de la otra y configura una redirección 301 de la página débil a la fuerte. Después actualiza los enlaces internos para que apunten directamente a la página correcta. Es el mismo trabajo que se hace, a lo grande, cuando se cambia de web: lo explico paso a paso en la guía para migrar una web sin perder posiciones.
Usar la etiqueta canonical
La canonical sirve cuando las páginas tienen que seguir siendo accesibles, como los filtros de la tienda. Se pone en la cabecera de la página duplicada e indica la principal:
<link rel="canonical" href="https://www.tuweb.es/zapatillas-trail/" />Las reglas que hay que respetar, siempre según la documentación de Google:
- pon la canonical también en la página principal, apuntando a sí misma;
- usa la dirección completa, con https y dominio, no una ruta relativa;
- en los enlaces internos usa siempre la dirección canónica, no las variantes;
- no indiques canonical distintas para la misma página en sitios distintos (en el código y en el sitemap, por ejemplo);
- la canónica tiene que estar en el mismo idioma: para las traducciones se usa hreflang, no canonical.
Diferenciar la intención
Cuando necesitas las dos páginas, la solución es que respondan a preguntas distintas: el título, el primer párrafo y la estructura dejan claro a quién se dirige cada una. El artículo explica y compara; la página de servicio presenta la oferta y pide el contacto. Y el artículo enlaza la página de servicio con un texto claro, para que también Google entienda cuál de las dos es la comercial.
Lo que no hay que hacer
- No uses el robots.txt para ocultar duplicados. Google explica que una página bloqueada se puede indexar igualmente, sin contenido, y además no puede leer la canonical.
- No uses noindex para elegir la canónica. Saca la página de la búsqueda por completo. Sirve para páginas que no deben aparecer nunca, no para indicar qué versión prefieres.
- No uses la herramienta de retirada de URLs. Oculta todas las versiones de la dirección, incluida la buena.
- No pongas redirección y canonical en conflicto. Una página que redirige a A y declara como canónica B confunde a Google.
- No borres una página con visitas y enlaces sin redirección. Pierdes el valor que había acumulado durante años.
- No juzgues después de una semana. Tras una redirección o una fusión, las posiciones pueden moverse unas semanas antes de estabilizarse.
Cómo prevenirla: el mapa de palabras clave
La mejor forma de no tener canibalización es decidir antes qué página responde a qué búsqueda. Basta una hoja de cálculo con cuatro columnas, que se actualiza cada vez que publicas:
| Búsqueda principal | Intención | Página asignada | Tipo de página |
|---|---|---|---|
| diseño web | comercial | /servicios/diseno-web/ | servicio |
| cuánto cuesta una página web | informativa con interés de compra | /blog/cuanto-cuesta-una-pagina-web/ | artículo |
| cómo elegir un hosting | informativa | /blog/como-elegir-hosting/ | artículo |
| hosting para WordPress | comercial | /servicios/hosting-wordpress/ | servicio |
Antes de escribir un artículo nuevo, busca en el mapa: si la búsqueda ya está asignada, actualiza esa página en lugar de crear otra. Es una costumbre de cinco minutos que evita meses de trabajo después.
Mi experiencia
En más de diez años trabajando con webs y SEO, la canibalización es uno de los problemas que más encuentro en los análisis, sobre todo en webs con un blog activo desde hace años. El caso típico es este: un negocio escribe tres o cuatro artículos sobre el mismo tema con meses de diferencia, porque cada vez parece una idea nueva, y mientras tanto tiene también una página de servicio sobre ese tema. Google no sabe cuál elegir, alterna las páginas y ninguna llega arriba.
La solución, casi siempre, no es escribir más, sino tener menos páginas y hacerlas mejor. Fusionar tres artículos flojos en una guía completa, con las redirecciones correctas, es una de las intervenciones que dan resultados más claros. Y después hace falta la disciplina del mapa de palabras clave, porque el problema vuelve en cuanto se publica sin comprobar.
Si no sabes por dónde empezar, el análisis de las páginas que compiten entre sí es una de las revisiones que hago en mis servicios de SEO, junto con la comprobación de cómo elige Google las páginas canónicas de la web.
Conclusión
El contenido duplicado y la canibalización no provocan penalizaciones, pero hacen perder posiciones en silencio: Google elige una página por ti, a veces la equivocada, y reparte la fuerza de la web entre varias direcciones. Los duplicados son casi siempre un problema técnico y se arreglan con redirecciones 301 y etiquetas canonical. La canibalización es un problema editorial y se arregla fusionando, diferenciando o redirigiendo.
El punto de partida es siempre el mismo: Search Console, una consulta cada vez, para ver qué páginas aparecen. Y a partir de ahí, una regla sencilla: una búsqueda, una página.
Preguntas frecuentes
¿Cuál es la diferencia entre contenido duplicado y canibalización?
El contenido duplicado es la misma página, o una casi idéntica, accesible desde varias direcciones, normalmente por un motivo técnico. La canibalización se da entre páginas distintas de la misma web que responden a la misma búsqueda y compiten entre sí. El primero se soluciona con redirecciones y canonical; la segunda, fusionando o diferenciando las páginas.
¿Google penaliza el contenido duplicado?
No. Google explica que algo de contenido duplicado en una web es normal y no infringe sus políticas contra el spam. Lo que sí está prohibido es copiar contenido de otras webs y generar páginas en masa para manipular la búsqueda. Los duplicados normales te hacen perder algo, pero no provocan una penalización.
¿Cómo sé si dos páginas mías compiten entre sí?
En Search Console abre Rendimiento, haz clic en una consulta importante y pasa a la pestaña Páginas. Si hay varias páginas tuyas con impresiones para esa búsqueda, y se van alternando con el tiempo, hay canibalización. Una comprobación rápida también se puede hacer buscando en Google site:tuweb.es seguido de la palabra clave.
¿Mejor la etiqueta canonical o la redirección 301?
La redirección 301 cuando la página duplicada ya no le sirve a nadie: quien la abre llega directamente a la correcta. La canonical cuando la página tiene que seguir siendo accesible, como los filtros y las ordenaciones de una tienda online. Las dos son señales fuertes para Google.
¿Puedo usar noindex para solucionar la canibalización?
Google lo desaconseja para elegir la página canónica, porque el noindex saca la página de la búsqueda por completo. Sirve para páginas que no deben aparecer nunca, como los resultados del buscador interno, pero para dos páginas parecidas es mejor fusionarlas con una redirección o usar la canonical.
¿Dos páginas en idiomas distintos son duplicados?
No, si el texto principal está traducido. Solo son duplicados si cambia el idioma del menú y del pie de página pero el contenido sigue igual. Las versiones en distintos idiomas se conectan con hreflang, no con canonical.
¿Cuánto se tarda en ver resultados después de fusionar dos páginas?
Normalmente unas semanas. Google tiene que volver a visitar las páginas, ver la redirección y pasar las señales a la página principal. En los primeros días las posiciones pueden moverse: conviene valorar el resultado pasado al menos un mes.
Lee también:
Search Console: los informes que revisar cada mes en 2026 ·
Datos estructurados en 2026: cuáles siguen sirviendo (y cuáles ya no) ·
SEO, AEO, GEO, AIO y SXO: las 5 siglas del SEO moderno
Fuentes
- Google Search Central, Qué es la canonicalización: cómo elige Google la página canónica y por qué los duplicados no son spam.
- Google Search Central, Cómo especificar una URL canónica: redirecciones, canonical, sitemap y errores a evitar.
- Google Search Central, Guía de sistemas de clasificación: el sistema de diversidad de sitios y la deduplicación.
- Google Search Central, Políticas de spam: contenido copiado y abuso de contenido a escala.
- Ayuda de Search Console, Informe de indexación de páginas: los estados de los duplicados y qué hacer.
- Ayuda de Search Console, Qué son las impresiones, la posición y los clics: cómo se cuentan las impresiones por propiedad y por página.
- Google Search Central Blog, Demystifying the duplicate content penalty: por qué la penalización por duplicados no existe.
- WordPress, Changes to attachment pages: las páginas de adjuntos desactivadas desde WordPress 6.4.

Claude Duet: qué es y para qué usarlo
Claude Duet: qué es y para qué usarlo Por Daniele Forciniti Claude Duet es la nueva app de Anthropic en la que…

MiniMax M3.1 Flash: novedades, precios y benchmarks del modelo chino
MiniMax M3.1 Flash: novedades, precios y benchmarks del modelo chino para agentes de IA Por Daniele Forciniti MiniMax M3.1 Flash es el…
Datos estructurados en 2026: cuáles siguen sirviendo (y cuáles ya
Datos estructurados en 2026: cuáles siguen sirviendo (y cuáles ya no) Por Daniele Forciniti Los datos estructurados en 2026 siguen sirviendo, pero…
Migrar una web sin perder posiciones en Google: la guía
Migrar una web sin perder posiciones en Google: la guía 2026 Por Daniele Forciniti Migrar una web sin perder posiciones en Google…
Search Console: los informes que revisar cada mes en 2026
Search Console: los informes que revisar cada mes en 2026 Por Daniele Forciniti Los informes de Search Console que revisar cada mes…
Claude Haiku 5.5 vs Gemini 4: precios, benchmarks y cuál
Claude Haiku 5.5 vs Gemini 4: precios, benchmarks y cuál conviene de verdad Por Daniele Forciniti Claude Haiku 5.5 vs Gemini 4…