
Claude Haiku 5.5 vs Gemini 4: precios, benchmarks y cuál conviene de verdad
Por Daniele Forciniti
Claude Haiku 5.5 vs Gemini 4 es una comparación entre dos modelos de categorías distintas. Haiku 5.5 es el modelo pequeño de Anthropic, lanzado el 7 de octubre de 2026: cuesta 0,10 dólares por millón de tokens de entrada y 0,50 de salida, y está pensado para trabajos rápidos y repetitivos. Gemini 4 Argon es el modelo estrella de Google: en las pruebas independientes es mucho más inteligente (53 puntos frente a 38 con el mismo nivel de razonamiento), pero cuesta unas 25 veces más por tarea y hoy solo lo usan los socios del programa Fairwind. El verdadero rival de Haiku 5.5 dentro de Google es Gemini 3.8 Flash, y fuera de Google es GPT-6 Luna de OpenAI.
En este artículo tienes las dos fichas comparadas, los benchmarks independientes (también los que pierde Haiku), los precios reales con el límite de los 100.000 tokens que casi nadie explica, la comparación con Gemini 3.8 Flash y GPT-6 Luna, y tres cálculos hechos sobre trabajos reales. Al final hay una guía práctica para saber qué modelo usar en cada caso.
Por qué importa esta comparación
Quien busca «Haiku contra Gemini» normalmente quiere saber una sola cosa: cuál sale más barato por el mismo trabajo. La pregunta es buena, pero hay que hacerla con los modelos adecuados. Gemini 4 Argon y Haiku 5.5 salieron con una semana de diferencia y por eso aparecen a menudo en el mismo titular, pero juegan partidos distintos: Argon está pensado para proyectos largos y difíciles, Haiku para hacer miles de tareas pequeñas por minuto sin disparar la factura.
La noticia de verdad es otra. Con Haiku 5.5, Anthropic ha puesto su modelo pequeño al mismo precio que GPT-6 Luna, y lo ha hecho recortando un 90% la tarifa de Haiku 4.5 en las peticiones de hasta 100.000 tokens. Según Artificial Analysis, Haiku 5.5 con el razonamiento al máximo es hoy el modelo más capaz de su franja de precio, un poco por encima de Gemini 3.8 Flash y GPT-6 Luna. Para quien monta chatbots, automatizaciones o agentes de IA, es la franja donde de verdad se gasta, porque es la que más se usa.
Las dos fichas, cara a cara
Antes de mirar los números, estas son las características básicas, sacadas de las páginas oficiales de Anthropic y Google.
| Característica | Claude Haiku 5.5 | Gemini 4 Argon |
|---|---|---|
| Lanzamiento | 7 de octubre de 2026 | 30 de septiembre de 2026 |
| Categoría | modelo pequeño, el más rápido de Anthropic | modelo estrella de Google DeepMind |
| Precio de entrada (por millón de tokens) | 0,10 $ hasta 100.000 tokens, 0,50 $ por encima | 2 $ de lanzamiento, luego 4 $ |
| Precio de salida (por millón de tokens) | 0,50 $ hasta 100.000 tokens, 2,50 $ por encima | 10 $ de lanzamiento, luego 20 $ |
| Memoria de trabajo (contexto) | 1 millón de tokens | 1 millón de tokens |
| Respuesta máxima | 128.000 tokens | 1 millón de tokens |
| Qué lee | texto e imágenes | texto, imágenes, documentos y vídeo |
| Razonamiento ajustable | sí, de low a max (por defecto medium) | high, el nivel más alto disponible |
| Quién puede usarlo hoy | todo el mundo: apps de Claude (también gratis), API, AWS, Google Cloud, Microsoft | solo el programa Fairwind y equipos internos de Google |
La última fila es la que más pesa. Haiku 5.5 lo puedes probar ahora mismo en Claude.ai, incluso con el plan gratuito, mientras que Argon de momento solo llega a los defensores informáticos del programa Fairwind. Hoy, 12 de octubre, he revisado la tabla de precios de la API de Gemini: Argon todavía no aparece. Para quien trabaja con Google, la alternativa real a Haiku 5.5 sigue siendo Gemini 3.8 Flash.
Qué trae de nuevo Haiku 5.5
Haiku 4.5 salió hace un año y desde entonces el mercado de modelos pequeños ha cambiado mucho. Estas son las novedades, explicadas de forma sencilla, a partir del anuncio oficial y de la documentación para desarrolladores.
- Precio recortado un 90% por debajo de 100.000 tokens: se pasa de 1 y 5 dólares a 0,10 y 0,50. Anthropic dice que el 90% de las peticiones a Haiku 4.5 estaban por debajo de ese límite. Por encima de 100.000 tokens el recorte es del 50% (0,50 y 2,50 dólares).
- El ahorro medio es del 75%, no del 90%: el motivo es el nuevo tokenizador, es decir, el sistema que divide el texto en trocitos que se pagan. Según la documentación, el mismo texto cuenta alrededor de un 30% más de tokens que en Haiku 4.5. Anthropic ya ha hecho la cuenta y habla de un ahorro medio de alrededor del 75%.
- Nivel de razonamiento ajustable: es el primer Haiku con el parámetro effort. Puedes pedirle que piense poco (más rápido y barato) o mucho (más preciso). El valor por defecto es medium.
- Memoria de 1 millón de tokens: Haiku 4.5 se quedaba en 200.000. Significa que puede leer documentos muy largos, o el mismo material que lee un modelo más grande cuando trabaja como su ayudante.
- Uso del ordenador y del navegador: junto con el modelo, Anthropic ha actualizado los SDK de Python y TypeScript con soporte en beta para el uso del ordenador y del navegador. Haiku 5.5 está pensado también para rellenar formularios, introducir datos y mover información de una aplicación a otra.
- El modelo más rápido de Anthropic: lo es a velocidad estándar; solo Opus en modo Fast va más deprisa. Artificial Analysis mide 235 tokens por segundo con el razonamiento al máximo.
- Normas de seguridad más estrictas: según el anuncio, las protecciones en ciberseguridad son más restrictivas que en Haiku 4.5 y bloquean, por ejemplo, las pruebas de penetración. Los detalles están en la ficha de seguridad oficial.
Hay también una novedad que no afecta a Haiku sino a quien lo paga: desde la semana del lanzamiento, los suscriptores de Max y Team reciben un crédito mensual para la API (100 dólares con Max 5x, 200 con Max 20x y hasta 500 compartidos en los equipos), que sirve para cualquier modelo de Claude.
Benchmarks: Haiku 5.5 frente a Gemini 4 Argon
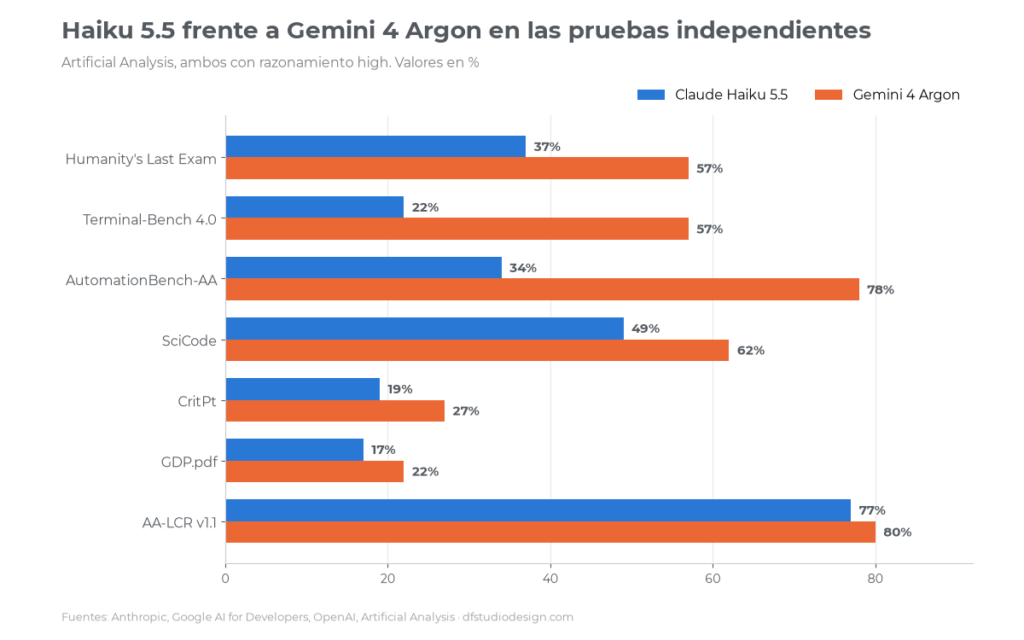
Los números que siguen son de Artificial Analysis, un laboratorio independiente que repite las mismas pruebas con todos los modelos. Para que la comparación sea justa, los he cogido con el mismo nivel de razonamiento, high, para los dos.
| Prueba | Qué mide | Haiku 5.5 (high) | Gemini 4 Argon (high) |
|---|---|---|---|
| Intelligence Index v4.3.2 | media de 10 pruebas | 38 | 53 |
| Humanity’s Last Exam | preguntas de expertos en muchas materias | 37% | 57% |
| Terminal-Bench 4.0 | trabajos de programación desde el terminal | 22% | 57% |
| AutomationBench-AA | procesos de empresa completos en software online | 34% | 78% |
| SciCode | código para problemas científicos | 49% | 62% |
| GDPval-AA v2.1 | trabajos profesionales reales (puntuación Elo) | 1418 | 1624 |
| AA-Briefcase v1.1 | trabajo de oficina como agente (puntuación Elo) | 1442 | 1488 |
| GDP.pdf | razonamiento sobre documentos profesionales | 17% | 22% |
| AA-LCR v1.1 | razonamiento sobre textos muy largos | 77% | 80% |
| AA-Omniscience | conocimiento de datos, descontando las respuestas inventadas | 6 | 42 |
| Coste por tarea | media del índice | 0,08 $ | 1,99 $ |
| Coste del índice completo | las 10 pruebas | 94 $ | 2.407 $ |
Argon gana todas las pruebas, y no es ninguna sorpresa: es un modelo de otra categoría. Lo interesante es dónde la distancia es pequeña y dónde es enorme.
Donde Haiku se queda cerca
En los textos muy largos (AA-LCR) Haiku pierde por solo 3 puntos, y en el trabajo de oficina como agente (AA-Briefcase) la distancia es de 46 puntos Elo, muy poco para dos modelos con precios tan distintos. También en los documentos profesionales (GDP.pdf) están cerca, con puntuaciones bajas para los dos. Traducido: para leer, resumir y sacar información de documentos largos, Haiku hace un trabajo parecido gastando mucho menos.
Lo confirma también Vals AI en otra prueba: en el Vibe Code Bench, donde los modelos tienen que crear desde cero una aplicación web completa a partir de una descripción escrita, Haiku 5.5 queda tercero de 110 con un 90,44%, solo por detrás de Sonnet 5.5 (92,39%) y precisamente de Gemini 4 Argon (91,91%).
Donde Argon se escapa
En los procesos de empresa completos (AutomationBench), en la programación desde el terminal y en las preguntas de expertos la diferencia es de 20 a 45 puntos. Son trabajos largos, con muchos pasos, donde un error al principio estropea todo lo demás: justo el terreno para el que se ha construido Argon.
Dos aclaraciones importantes. La primera: según Artificial Analysis, el resultado de Haiku en AutomationBench probablemente está infravalorado, porque durante las pruebas previas al lanzamiento un problema en los filtros de seguridad le hacía rechazar demasiadas peticiones; Anthropic lo está corrigiendo y la prueba se repetirá. La segunda: en AA-Omniscience Haiku sabe menos datos de memoria, pero está más dispuesto a admitir cuando no sabe algo, y en los trabajos reales eso cuenta.
Los costes: aquí Haiku no tiene rival
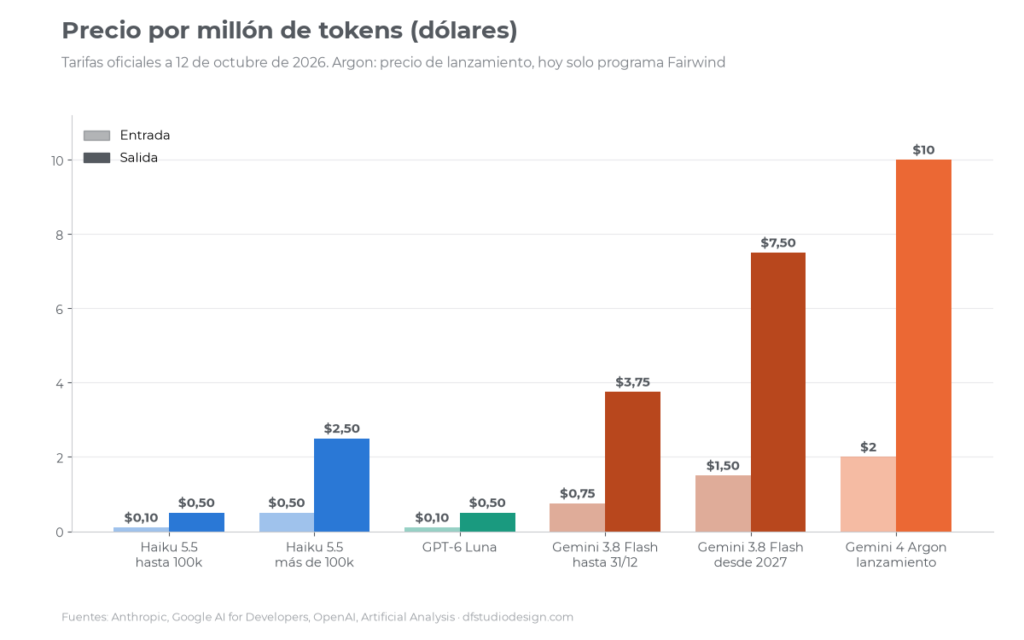
Si Argon gana en inteligencia, Haiku gana en el bolsillo, y con un margen mucho mayor. Con el mismo nivel de razonamiento, una tarea media del índice cuesta 0,08 dólares con Haiku y 1,99 con Argon: unas 25 veces más. Para pasar las 10 pruebas completas hacen falta 94 dólares con Haiku y 2.407 con Argon.
| Modelo | Entrada (por millón) | Salida (por millón) | Notas |
|---|---|---|---|
| Claude Haiku 5.5 | 0,10 $ | 0,50 $ | peticiones de hasta 100.000 tokens |
| Claude Haiku 5.5 | 0,50 $ | 2,50 $ | peticiones de más de 100.000 tokens |
| GPT-6 Luna | 0,10 $ | 0,50 $ | precio base |
| Gemini 3.8 Flash | 0,75 $ | 3,75 $ | hasta el 31 de diciembre de 2026 |
| Gemini 3.8 Flash | 1,50 $ | 7,50 $ | desde el 1 de enero de 2027 |
| Gemini 4 Argon | 2 $ | 10 $ | precio de lanzamiento, luego 4 y 20 $ |
El precio de Haiku baja todavía más con dos descuentos oficiales: hasta un 90% en el texto ya leído y guardado en memoria (la caché, 0,01 dólares por millón de tokens) y un 50% con el procesamiento diferido (Batch API), útil cuando la respuesta no hace falta al momento. Aparecen en la página de Haiku.
Ojo, eso sí, a un detalle que Artificial Analysis señala de forma explícita: sus costes por tarea de Haiku son provisionales, porque la web todavía no aplica el precio más alto por encima de los 100.000 tokens. En las peticiones cortas las cuentas cuadran; en las largas el gasto real será algo mayor.
El verdadero rival: Gemini 3.8 Flash (y GPT-6 Luna)
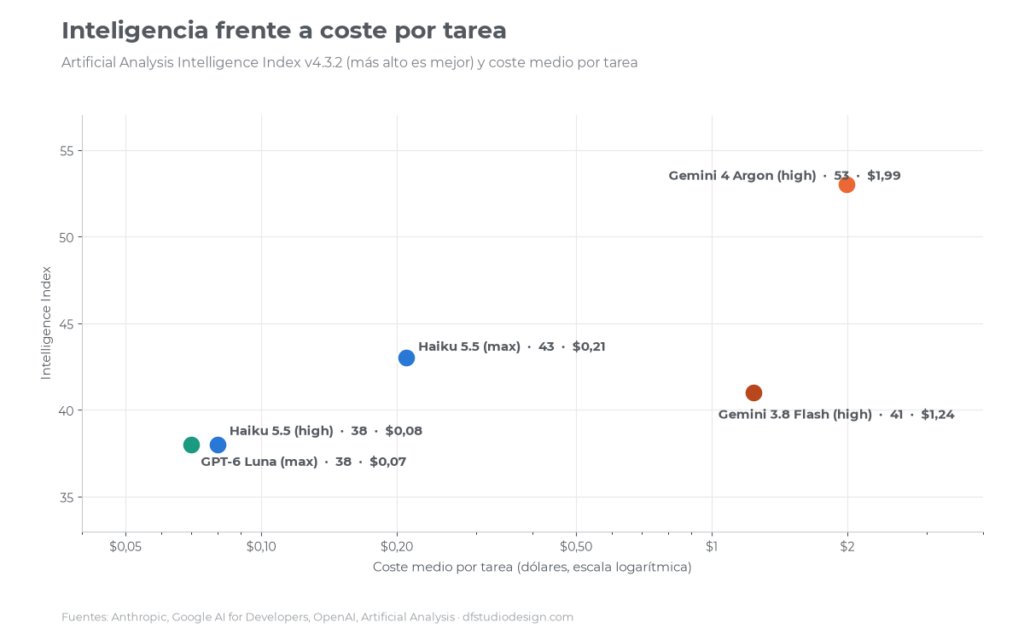
Si quieres comparar Haiku 5.5 con un modelo de su misma categoría, los nombres correctos son Gemini 3.8 Flash, el modelo rápido de Google, y GPT-6 Luna, el modelo pequeño de OpenAI, que cuesta exactamente lo mismo que Haiku. Aquí la comparación está mucho más reñida. Los datos son de Artificial Analysis, con cada modelo en su mejor nivel de razonamiento (Haiku frente a Flash, Haiku frente a Luna).
| Prueba | Haiku 5.5 (max) | Gemini 3.8 Flash (high) | GPT-6 Luna (max) |
|---|---|---|---|
| Intelligence Index | 43 | 41 | 38 |
| AA-Briefcase v1.1 (Elo) | 1577 | 1203 | 1336 |
| GDPval-AA v2.1 (Elo) | 1618 | 1436 | 1432 |
| Terminal-Bench 4.0 | 33% | 20% | 13% |
| AutomationBench-AA | 35% | 60% | 53% |
| Humanity’s Last Exam | 44% | 48% | 39% |
| SciCode | 55% | 57% | 55% |
| AA-LCR v1.1 (textos largos) | 83% | 81% | 83% |
| AA-Omniscience | 11 | 30 | 1 |
| Precio entrada / salida | 0,10 / 0,50 $ | 0,75 / 3,75 $ | 0,10 / 0,50 $ |
| Coste por tarea | 0,21 $ | 1,24 $ | 0,07 $ |
| Tokens de salida por tarea | 162.000 | 71.000 | 50.000 |
| Velocidad | 235 tokens/s | 132 tokens/s | 138 tokens/s |
Haiku 5.5 frente a Gemini 3.8 Flash
En inteligencia general están casi empatados (43 frente a 41), pero ganan en cosas distintas. Haiku es claramente mejor en el trabajo de oficina como agente y en la programación desde el terminal. Flash va mejor en los procesos de empresa completos, en las preguntas de expertos y sobre todo en el conocimiento de datos, donde casi triplica la puntuación.
También Vals AI los ve igualados: en su índice de trabajo profesional Haiku 5.5 saca un 54,31% y Gemini 3.8 Flash un 54,83%, medio punto de diferencia. Lo que marca la diferencia es el precio y lo que saben leer. Flash cuesta 7,5 veces más por token y casi 6 veces más por tarea, pero lee también audio, vídeo y PDF, mientras que Haiku se queda en texto e imágenes. A cambio, Haiku escribe respuestas de hasta 128.000 tokens y Flash de hasta 65.536.
Una última cosa sobre Flash: el precio actual es una promoción. Desde el 1 de enero de 2027 Google lo duplica, a 1,50 y 7,50 dólares. Si estás haciendo un presupuesto para un proyecto de un año, es un detalle que conviene meter en la cuenta.
Haiku 5.5 frente a GPT-6 Luna
Aquí la tarifa es idéntica hasta el céntimo, también en la caché. En la tabla oficial de Anthropic Haiku gana a Luna en todas las pruebas que comparten: 72,4% frente a 48,9% en el uso del ordenador (OSWorld 2.1), 39,2% frente a 16,4% en Terminal-Bench 4.0 y 46,4% frente a 29,1% en la lectura de gráficos. Eso sí, son cifras declaradas por Anthropic.
Las pruebas independientes confirman la ventaja en inteligencia (43 frente a 38), pero también enseñan la otra cara: Haiku con el razonamiento al máximo usa unos 162.000 tokens de salida por tarea, más del triple que Luna. Como los tokens de razonamiento se pagan igual que los de la respuesta, el coste por tarea de Haiku (0,21 dólares) es el triple que el de Luna (0,07). Con el mismo nivel de inteligencia, es decir, Haiku en high frente a Luna en max, los dos sacan 38 puntos y cuestan casi lo mismo: 0,08 frente a 0,07 dólares.
En resumen, el precio por token importa menos que los tokens que un modelo gasta para terminar el trabajo. Pasa también con los modelos grandes como Claude Opus 5.5 y GPT-6 Sol, y con Haiku 5.5 se nota todavía más.
Cuánto cuesta de verdad: tres cálculos sobre trabajos reales
Los benchmarks dicen quién es mejor; la factura dice quién conviene. He rehecho las cuentas con las tarifas oficiales para tres trabajos típicos. Son estimaciones: cada empresa divide el texto en tokens a su manera y los modelos que razonan más gastan más tokens de salida, así que los números hay que tomarlos como orden de magnitud.
1. Clasificar 100.000 correos o reseñas al mes
Supuesto: cada mensaje ocupa unos 1.500 tokens de entrada (el texto más las instrucciones) y la respuesta unos 300 tokens. En un mes son 150 millones de tokens de entrada y 30 millones de salida.
| Modelo | Coste mensual estimado |
|---|---|
| Claude Haiku 5.5 | 30 $ |
| GPT-6 Luna | 30 $ |
| Gemini 3.8 Flash | 225 $ (450 $ desde 2027) |
| Gemini 4 Argon | 600 $ de lanzamiento (1.200 $ a precio completo) |
Es el trabajo perfecto para un modelo pequeño: tareas cortas, todas iguales y muchas. Usar Argon aquí sería como coger un camión para llevar una carta.
2. Leer un contrato de 300.000 tokens
Supuesto: un documento muy largo (cientos de páginas) y una respuesta de 5.000 tokens. Aquí Haiku supera el límite de los 100.000 tokens y paga la tarifa alta.
| Modelo | Coste por documento |
|---|---|
| Claude Haiku 5.5 (tarifa de más de 100.000 tokens) | unos 0,16 $ |
| Gemini 3.8 Flash | unos 0,24 $ |
| Gemini 4 Argon | unos 0,65 $ de lanzamiento |
Haiku sigue siendo el más barato, pero su ventaja sobre Flash baja de 7,5 veces a más o menos 1,5. Si el trabajo lo permite, hay un truco sencillo: dividir el documento en tres partes de algo menos de 100.000 tokens. Así cada petición queda por debajo del límite y el gasto con Haiku baja a unos 0,04 dólares, cuatro veces menos. No sirve cuando el modelo tiene que ver todo el documento a la vez (por ejemplo, para encontrar contradicciones entre un capítulo y otro).
3. El nivel de razonamiento cambia la cuenta
El mismo modelo puede costar el triple según cuánto le hagas pensar. Haiku 5.5 con el razonamiento al máximo saca 43 puntos y cuesta 0,21 dólares por tarea; en high saca 38 y cuesta 0,08. Y los tiempos cambian todavía más: al máximo, en las pruebas de Artificial Analysis, el primer trozo de respuesta llega tras unos 5 minutos de razonamiento; en high, tras unos 25 segundos.
Según VentureBeat, que ha leído los gráficos oficiales, en Terminal-Bench Haiku llega al 39% solo al máximo, mientras que en el nivel por defecto (medium) se queda alrededor del 20%. Para un chat con clientes hace falta una respuesta en pocos segundos, así que mejor low o medium. Para un trabajo nocturno sobre miles de documentos, donde la precisión importa más que el tiempo, tiene sentido subirlo.
Cuál elegir: la guía práctica
- Clasificar, extraer datos y resumir en grandes cantidades: Haiku 5.5 o GPT-6 Luna. Cuestan lo mismo; Haiku es mejor en el trabajo de oficina, Luna gasta menos tokens.
- Ayudante de un modelo más grande (subagente): Haiku 5.5. Es el papel para el que Anthropic lo ha pensado: Opus 5.5 o Sonnet 5.5 planifican, y Haiku hace las búsquedas y las partes más sencillas del trabajo. Si montas agentes de IA para un cliente, es la forma más sencilla de recortar gastos.
- Automatizar el navegador o el ordenador (formularios, introducción de datos): Haiku 5.5, que en las pruebas de Anthropic va mucho mejor que Luna en el uso del ordenador.
- Chat y atención al cliente en tiempo real: Haiku 5.5 con razonamiento bajo o medio. Es el más rápido de los tres.
- Audio, vídeo o PDF para analizar directamente: Gemini 3.8 Flash, que los lee todos. Haiku solo lee texto e imágenes.
- Preguntas sobre datos sin buscar en internet: Gemini 3.8 Flash, que en las pruebas sabe muchas más cosas. Si el modelo trabaja sobre tus propios documentos, esta diferencia pesa poco.
- Proyectos largos y complejos, código difícil, finanzas y legal: Gemini 4 Argon cuando llegue para todos. Hoy, entre los modelos que se pueden usar, Claude Opus 5.5 o Sonnet 5.5. Tienes todos los detalles de Argon en mi artículo sobre las novedades, precios y benchmarks de Gemini 4 Argon.
- Probar gratis antes de pagar: Haiku 5.5 está en el plan gratuito de Claude; Gemini 3.8 Flash tiene un nivel gratuito en la API y se puede probar también en Google AI Studio.
Qué revisar antes de cambiar de modelo
Si hoy usas Haiku 4.5 u otro modelo pequeño y estás pensando en pasar a Haiku 5.5, estas son las comprobaciones que haría antes de tocar un sistema que funciona.
- Lo largas que son tus peticiones: si a menudo pasan de 100.000 tokens, rehaz las cuentas con la tarifa alta (0,50 y 2,50 dólares).
- El nuevo tokenizador: el mismo texto cuenta alrededor de un 30% más de tokens. Si tienes límites de gasto o de longitud, hay que reajustarlos.
- Algunos parámetros ya no se usan: la documentación pide no enviar temperature, top_p ni top_k, que con valores distintos de los predeterminados dan error. El razonamiento se ajusta con effort. La lista completa está en la guía oficial de Haiku 5.5.
- El nivel de razonamiento por defecto es medium: si no lo fijas tú, pagas y esperas como en medium. Pruébalo en low para las tareas más sencillas.
- Los rechazos: los filtros de seguridad son más estrictos que en Haiku 4.5 y al principio rechazaban demasiadas peticiones. Prueba tus casos reales antes de llevarlo a producción.
- Si eliges Gemini 3.8 Flash: recuerda que a partir del 1 de enero de 2027 el precio se duplica.
Mi opinión
Llevo más de diez años trabajando con webs, SEO y contenidos, y en los dos últimos años gran parte de los proyectos que me piden llevan dentro una parte de IA: un asistente que responde a los clientes en la web, un sistema que reparte las peticiones del formulario de contacto, fichas de producto que hay que reescribir por cientos. En estos trabajos el modelo más inteligente casi nunca es la elección correcta. Hace falta un modelo fiable, rápido y lo bastante barato como para llamarlo todo el día sin pensarlo.
Por eso Haiku 5.5 me parece más interesante de lo que dicen los titulares. No gana a Argon y no tiene por qué. Llega al mismo precio que Luna con más capacidad en el trabajo de oficina, y aguanta el tipo frente a Gemini 3.8 Flash costando mucho menos. El punto débil hay que decirlo claro: si lo dejas razonar al máximo gasta muchísimos tokens y se vuelve lento, así que hay que ajustarlo, no usarlo con la configuración de serie.
Sobre Gemini 4 Argon mi opinión sigue siendo la de hace diez días: los números son los mejores que hay, pero hasta que no llegue a la API sigue siendo una promesa. Mientras tanto, hay algo que vale para todos estos modelos: las IA responden con lo que encuentran en internet. Si quieres que citen tu empresa cuando alguien pide una recomendación, cuenta cómo está escrita tu web, y es el trabajo que hago en mis servicios de SEO.
Conclusión
Haiku 5.5 y Gemini 4 Argon no compiten entre sí: Argon es más inteligente en todas las pruebas independientes, Haiku cuesta unas 25 veces menos por tarea y lo puede usar cualquiera, hoy. La comparación que de verdad importa es con Gemini 3.8 Flash, con el que está casi empatado en inteligencia pero sale mucho más barato, y con GPT-6 Luna, que tiene la misma tarifa, es algo menos capaz y gasta menos tokens.
El consejo práctico es siempre el mismo: elige el modelo según el trabajo, no según la clasificación. Para tareas cortas y repetidas, un modelo pequeño bien ajustado cuesta una fracción y hace casi lo mismo. Para proyectos largos y difíciles hace falta un modelo grande. Y antes de decidir, prueba tus casos reales y mira la factura, no solo la tarifa.
Preguntas frecuentes
¿Qué diferencia hay entre Claude Haiku 5.5 y Gemini 4 Argon?
Haiku 5.5 es el modelo pequeño y barato de Anthropic, pensado para trabajos rápidos y repetitivos. Gemini 4 Argon es el modelo estrella de Google, pensado para proyectos largos y complejos. Argon es más inteligente en todas las pruebas independientes; Haiku cuesta unas 25 veces menos por tarea.
¿Cuánto cuesta Claude Haiku 5.5?
En la API cuesta 0,10 dólares por millón de tokens de entrada y 0,50 de salida en las peticiones de hasta 100.000 tokens. Por encima de ese límite cuesta 0,50 y 2,50 dólares. Con la caché se ahorra hasta un 90% en el texto ya leído y con la Batch API un 50%. En la app de Claude se puede usar también con el plan gratuito.
¿Puedo usar ya Gemini 4 Argon?
No, salvo que tu organización forme parte del programa Fairwind de Google. Después llegará a los clientes de pago de la API de Gemini y a los suscriptores de Google AI Ultra, pero Google no ha dado fechas. A 12 de octubre de 2026 no aparece en la tabla de precios de la API.
¿Es mejor Haiku 5.5 que Gemini 3.8 Flash?
En inteligencia general están casi empatados: 43 puntos frente a 41 en el índice de Artificial Analysis. Haiku es mejor en el trabajo de oficina como agente y en la programación desde el terminal; Flash, en las preguntas sobre datos y en los procesos de empresa completos. Haiku cuesta 7,5 veces menos por token; Flash lee también audio, vídeo y PDF.
¿Haiku 5.5 o GPT-6 Luna?
Tienen el mismo precio. Haiku es más capaz en las pruebas (43 frente a 38 con el razonamiento al máximo), pero gasta más tokens, así que al máximo cuesta unas tres veces más por tarea. Con el mismo nivel de inteligencia cuestan casi lo mismo. Para el uso del ordenador y el trabajo de oficina Haiku va por delante; para gastar lo mínimo posible, Luna es una muy buena opción.
¿Por qué Haiku 5.5 cuesta un 75% menos y no un 90%?
La tarifa baja un 90% por debajo de 100.000 tokens, pero el nuevo tokenizador cuenta el mismo texto con alrededor de un 30% más de tokens, y por encima del límite el recorte es solo del 50%. Haciendo la media sobre las peticiones reales, Anthropic calcula un ahorro de alrededor del 75% respecto a Haiku 4.5.
¿Qué nivel de razonamiento conviene usar con Haiku 5.5?
Depende del trabajo. Para chat y atención en tiempo real conviene low o medium, que responden en pocos segundos. Para trabajos diferidos donde importa la precisión se puede subir a high o max, sabiendo que al máximo el modelo gasta alrededor del triple de tokens y puede tardar minutos en responder.
Lee también:
GPT-6 Astra y Gemini 3.8 Flash: benchmarks oficiales, precios reales y cuál conviene ·
Gemini 4 Pro en pruebas en Arena bajo el nombre Gemini 3.8 Flash: lo que sabemos de verdad ·
Claude Fable 5.1 y Mythos 5.1: benchmarks, precios y recorte del 75%
Fuentes
- Anthropic, Introducing Claude Haiku 5.5, 7 de octubre de 2026: precios, benchmarks oficiales y comparación con GPT-6 Luna.
- Claude Platform Docs, Claude Haiku 5.5: ficha técnica, tarifas por encima de 100.000 tokens, tokenizador y parámetros.
- Artificial Analysis, análisis de Claude Haiku 5.5: pruebas independientes, consumo de tokens y notas sobre los costes provisionales.
- Artificial Analysis, Haiku 5.5 frente a Gemini 4 Argon: la comparación con el mismo nivel de razonamiento.
- Google AI for Developers, precios de la API de Gemini: tarifa de Gemini 3.8 Flash y subida desde 2027.
- Google, Gemini 4 Argon: novedades y disponibilidad del modelo estrella.
- Vals AI, Claude Haiku 5.5: Vals Index y Vibe Code Bench.
- Notebookcheck, Claude Haiku 5.5: el lanzamiento contado en español, con el plan gratuito y la comparación con Luna.

7 recursos gratuitos para desarrolladores: API de IA, bases de
7 recursos gratuitos para desarrolladores: API de IA, bases de datos, email y monitorización Por Daniele Forciniti Estos son 7 recursos gratuitos…

Gemini 4 Argon: todas las novedades, precios y benchmarks
Gemini 4 Argon: todas las novedades, precios y benchmarks Por Daniele Forciniti Gemini 4 Argon es el nuevo modelo insignia de Google,…
GPT-6.1 Sol: novedades, benchmarks y precios
GPT-6.1 Sol: novedades, benchmarks y precios Por Daniele Forciniti GPT-6.1 Sol es el nuevo modelo de OpenAI presentado ayer, 29 de septiembre…
Gemini 4 Pro en pruebas en Arena bajo el nombre
Gemini 4 Pro en pruebas en Arena bajo el nombre Gemini 3.8 Flash: lo que sabemos de verdad Por Daniele Forciniti Según…
Búsqueda multimodal: ahora Search Console muestra quién te encuentra con
Búsqueda multimodal: ahora Search Console muestra quién te encuentra con una foto Por Daniele Forciniti Desde el 24 de septiembre de 2026…
SEO, AEO, GEO, AIO y SXO: las 5 siglas del
SEO, AEO, GEO, AIO y SXO: las 5 siglas del SEO moderno explicadas de forma sencilla Por Daniele Forciniti SEO, AEO, GEO,…