
MiniMax M3.1 Flash: novedades, precios y benchmarks del modelo chino para agentes de IA
Por Daniele Forciniti
MiniMax M3.1 Flash es el nuevo modelo de inteligencia artificial de la empresa china MiniMax, pensado para los agentes de IA: programas que trabajan solos en varios pasos, escriben código, usan el ordenador y mueven datos de una aplicación a otra. Salió el 19 de octubre de 2026, cuesta 0,15 dólares por millón de tokens de entrada y 0,60 de salida, lee hasta 1 millón de tokens y, según MiniMax, es casi tres veces más rápido que el modelo anterior. Antes del lanzamiento circuló de forma anónima con el nombre en clave «Space Bunny», y desde hoy, 23 de octubre, sus pesos se pueden descargar en Hugging Face.
En este artículo tienes la ficha técnica explicada de forma sencilla, los precios con una cuenta sobre un trabajo real, todos los benchmarks oficiales (también los que pierde), las pruebas independientes que MiniMax no destaca, empezando por las alucinaciones, y lo que dice de verdad la licencia, que no es de código abierto como se está leyendo por ahí. Al final te digo para quién tiene sentido y para quién no.
Por qué esta noticia es importante
Por tres motivos. El primero es el precio: con M3.1 Flash, MiniMax ha reducido a la mitad la tarifa de su modelo principal, M3, y en los trabajos de agente declara un coste de uso un 70% menor. La web alemana The Decoder lo resumía bien: entre los laboratorios chinos, la carrera por bajar precios no parece tener suelo.
El segundo es el tipo de modelo. No es un chatbot para charlar, es un modelo hecho para trabajar: automatizaciones entre programas de empresa, programación, uso del ordenador y ciberseguridad. Es la franja donde de verdad se gasta, porque un agente hace decenas o cientos de peticiones para terminar un solo trabajo, y ahí cada céntimo por millón de tokens se multiplica.
El tercero es cómo ha llegado. Durante semanas, un modelo sin nombre, Space Bunny, lo usaron miles de desarrolladores sin saber quién lo había hecho. Solo después MiniMax confirmó que era una primera versión de M3.1 Flash. Es una forma cada vez más habitual de lanzar un modelo: primero se prueba a ciegas y después se revela la marca.
La historia de Space Bunny
Space Bunny apareció como modelo anónimo en plataformas muy usadas por los desarrolladores, como OpenRouter (un servicio que da acceso a cientos de modelos con una sola cuenta) y OpenCode (un asistente de programación de código abierto). Nadie sabía quién estaba detrás y en la red se apostaba por distintos laboratorios, chinos y no chinos.
El 19 de octubre MiniMax cerró el misterio en su anuncio oficial: Space Bunny era una primera versión de M3.1 Flash y, mientras funcionaba de forma anónima, procesó más de 200 billones de tokens. Para hacerse una idea: un token es un trozo de palabra, y una novela entera tiene unos 150.000. Quiere decir que el modelo se usó mucho, y en serio, por personas que lo eligieron sin conocer su nombre.
La ficha técnica, explicada de forma sencilla
Estos son los datos oficiales, sacados de la ficha del modelo en Hugging Face, de la documentación de MiniMax y de la tarifa de la API.
| Característica | MiniMax M3.1 Flash |
|---|---|
| Lanzamiento | 19 de octubre de 2026 (pesos en Hugging Face desde el 23 de octubre) |
| Tipo de modelo | multimodal «mixture of experts» |
| Parámetros | unos 428.000 millones en total, 23.000 millones activos por token |
| Qué lee | texto, imágenes y vídeo |
| Qué genera | solo texto |
| Memoria de trabajo (contexto) | hasta 1 millón de tokens |
| Niveles de razonamiento | cinco: low, medium, high, xhigh y max |
| Precio de entrada | 0,15 $ por millón de tokens |
| Precio de salida | 0,60 $ por millón de tokens |
| Entrada ya en caché | 0,015 $ por millón de tokens |
| Velocidad declarada | más de 200 tokens por segundo, mediana por encima de 170 |
| Licencia | MiniMax Community License (gratis para uso no comercial, con condiciones para el comercial) |
Tres conceptos de la tabla merecen una explicación:
- Mixture of experts: el modelo está dividido en muchos «expertos» y, para cada trozo de texto, solo enciende algunos. Por eso, aunque tiene 428.000 millones de parámetros, usa 23.000 millones cada vez: es grande en conocimiento, pero rápido y barato como un modelo mucho más pequeño.
- Contexto de 1 millón de tokens: es la cantidad de texto que el modelo tiene presente en una sola petición. Un millón de tokens equivale a un repositorio de código entero o a unos miles de páginas de documentos.
- Niveles de razonamiento: puedes pedirle que piense poco (responde antes y cuesta menos) o mucho (es más preciso pero usa más tokens). Es el mismo principio que ya tienen los modelos de Anthropic, OpenAI y Google.
Una nota para quien vaya a comprobarlo: en la página de Hugging Face, junto al nombre del modelo, aparece «220B params». Es un cálculo automático de la plataforma a partir de los archivos subidos, no el dato del fabricante. La ficha escrita por MiniMax dice claramente 428.000 millones en total y 23.000 millones activos.
Qué cambia respecto a MiniMax M3
M3.1 Flash mantiene la arquitectura de M3, pero según la ficha del modelo cambia tres cosas. Te las explico sin jerga:
- Atención «dispersa» en todo el modelo: para entender una frase, un modelo mira las palabras que ha leído antes. Con la atención completa las mira todas; con la dispersa, solo las que hacen falta. MiniMax ha sustituido también las tres primeras capas que todavía usaban la atención completa. El resultado es que los textos larguísimos cuestan menos de procesar. La técnica está descrita en el paper de MiniMax en arXiv.
- Entrenamiento ya «comprimido»: los números de un modelo se pueden guardar en un formato más ligero para ahorrar memoria, pero normalmente se pierde algo de calidad. MiniMax lo ha entrenado sabiendo desde el principio que se iba a comprimir (se llama quantization-aware training), así que la pérdida es menor y el modelo ocupa menos memoria en los servidores.
- Decodificación especulativa DSpark: un modelo pequeño de apoyo intenta adivinar las palabras siguientes y el grande solo tiene que confirmarlas o corregirlas. Cuando acierta, el texto sale mucho más rápido. Es una de las razones de la velocidad casi triplicada.
En la práctica, frente a M3 cambian tres números:
- Precio: la mitad. M3 cuesta 0,30 dólares de entrada y 1,20 de salida, y el doble por encima de 512.000 tokens por petición. M3.1 Flash cuesta 0,15 y 0,60, con el mismo precio en todo el millón de tokens.
- Coste de uso en agentes: un 70% menos según MiniMax, porque al precio más bajo se suma que el modelo termina los trabajos en menos pasos.
- Inteligencia medida por terceros: en el índice de Artificial Analysis, que combina diez pruebas distintas, M3 estaba en 29 puntos y M3.1 Flash está en 43. Es un salto muy grande para una actualización de medio punto.
MiniMax también ha anunciado una versión Pro, más potente, pero sin fecha. Flash es el modelo rápido y barato de la nueva familia, no el principal.
Cuánto cuesta MiniMax M3.1 Flash, con un ejemplo real
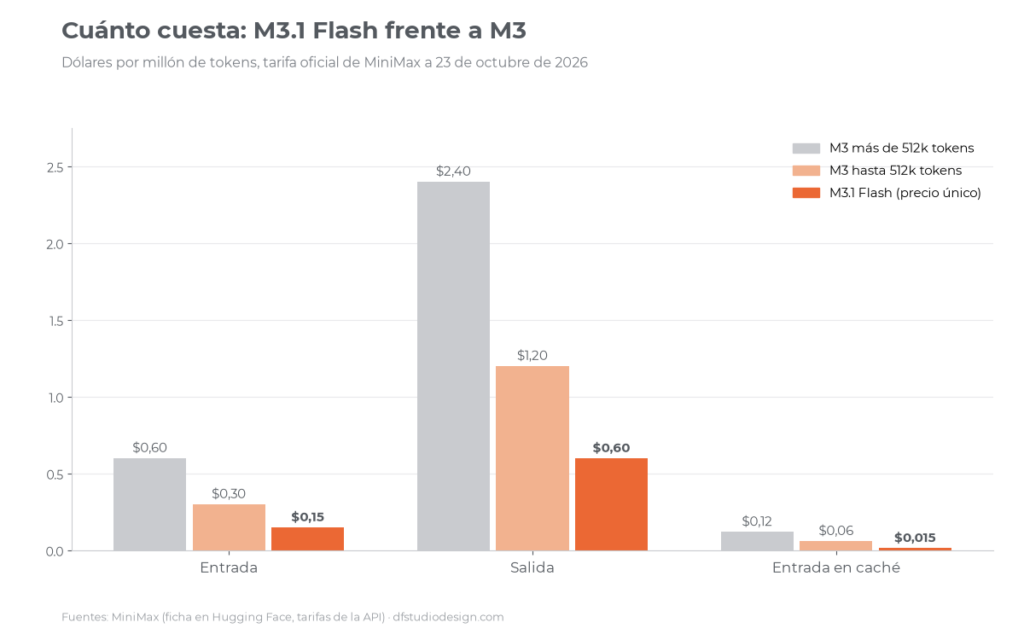
La tarifa oficial es sencilla: 0,15 dólares por millón de tokens leídos, 0,60 por millón de tokens escritos y 0,015 por los tokens que el modelo ya ha leído y guarda en caché. No hay tramos según la longitud de la petición, como sí ocurre con M3 y con muchos modelos de la competencia.
El dato que más cuenta es el último. Un agente de programación vuelve a leer una y otra vez los mismos archivos: la primera vez los paga a precio completo y las siguientes, a una décima parte. Hagamos la cuenta de una sesión de trabajo realista, en la que el agente lee 5 millones de tokens (4 de ellos ya en caché) y escribe 300.000:
| Concepto | M3.1 Flash | M3 (hasta 512k) |
|---|---|---|
| 1 millón de tokens nuevos de entrada | 0,15 $ | 0,30 $ |
| 4 millones de tokens en caché | 0,06 $ | 0,24 $ |
| 300.000 tokens de salida | 0,18 $ | 0,36 $ |
| Total de la sesión | 0,39 $ | 0,90 $ |
Menos de 40 céntimos por una sesión de trabajo completa. Hay, eso sí, un detalle que la tarifa no cuenta: M3.1 Flash es un modelo que habla mucho. Artificial Analysis contó unos 180 millones de tokens escritos para completar su índice, frente a una mediana de 100 millones en modelos parecidos. El coste medio por tarea sigue siendo bajo (unos 0,22 dólares, frente a 0,51 de M3), pero si lo usas con el razonamiento al máximo la factura sube más de lo que hace pensar el precio por token.
Los benchmarks oficiales, uno a uno
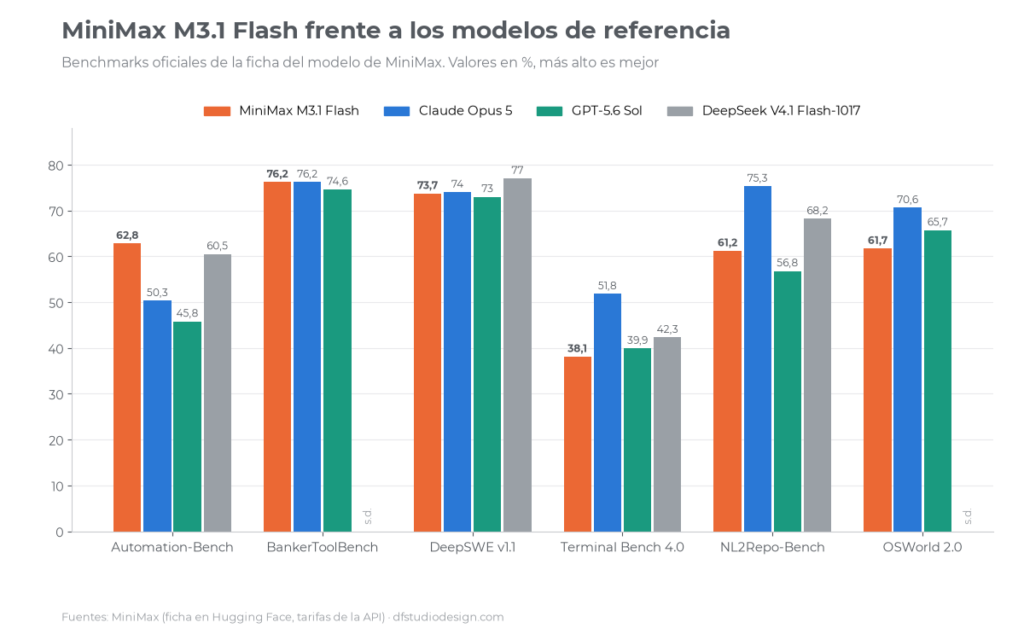
MiniMax ha comparado M3.1 Flash con DeepSeek V4.1 Flash (en dos versiones), Kimi K3, GLM-5.3, GPT-5.6 Sol y Claude Opus 5. Son cifras declaradas por el fabricante, con configuraciones elegidas por él: hay que leerlas como un punto de partida, no como un veredicto. Aquí las tienes por áreas, con una explicación de lo que mide cada prueba.
Trabajo de oficina y automatizaciones (CoWork)
- Automation-Bench v1.0.6: 62,8. Mide cuánto consigue completar un agente en procesos de empresa entre varios programas (ventas, marketing, atención al cliente, finanzas). Es el mejor resultado de la tabla, por delante de DeepSeek V4.1 Flash-1017 (60,5) y muy por delante de Opus 5 (50,3). En la tabla del lanzamiento el valor era 62,2: la ficha actualizada marca 62,8.
- BankerToolBench: 76,2. Trabajos de analista financiero con herramientas reales. Empata con Claude Opus 5 y supera a GPT-5.6 Sol (74,6).
- LOCA-Bench 256K: 60,3. Trabajos con contextos muy largos, de 256.000 tokens. Primer puesto, justo por encima de GPT-5.6 Sol (60,0).
- OSWorld 2.0: 61,7. Uso del ordenador: abrir programas, hacer clic, rellenar formularios. Aquí Opus 5 (70,6) y GPT-5.6 Sol (65,7) van por delante.
- Agents’ Last Exam: 29,6. Tareas de agente muy difíciles. Opus 5 llega a 32,2 y GPT-5.6 Sol a 30,6.
- Terminal Bench 4.0: 38,1. Trabajo desde el terminal, es decir, desde la línea de comandos. Es uno de sus puntos débiles: Opus 5 hace 51,8 y también DeepSeek V4.1 Flash-1017 va por delante (42,3).
- GDP.pdf AA: 20,8. Trabajo con documentos PDF complejos. GPT-5.6 Sol es el mejor con 27,2.
Programación
- DeepSWE v1.1: 73,7. Resolver problemas reales en proyectos de software. Prácticamente empata con Opus 5 (74,0) y GPT-5.6 Sol (73,0), pero DeepSeek V4.1 Flash-1017 lo hace mejor (77,0).
- NL2Repo-Bench: 61,2. Construir un proyecto entero a partir de una descripción. Opus 5 va muy por delante (75,3) y también las dos versiones de DeepSeek superan a M3.1 Flash.
- SWE Refactor Bench: 23,0. Reorganizar código existente sin romperlo. Opus 5 31,0 y GPT-5.6 Sol 28,5.
- PostTrain Bench v1.1: 39,3. Tareas de entrenamiento de modelos. Segundo puesto, detrás de Opus 5 (40,4).
Ciberseguridad y capacidades generales
- CyberGym: 82,2. Encontrar y comprobar vulnerabilidades en el software. Muy cerca de GPT-5.6 Sol (83,6) y GLM-5.3 (84,5).
- BabyVision con herramientas: 91,0. Razonamiento visual. Opus 5 es el mejor con 94,1.
- HLE sin herramientas: 43,4. Preguntas dificilísimas de todas las materias. Aquí se ve la distancia con los modelos más potentes: Opus 5 llega a 55,6 y GPT-5.6 Sol a 49,5.
- CharXiv RQ: 82,5. Leer y entender gráficos científicos. GPT-5.6 Sol 85,2.
La imagen es clara: M3.1 Flash gana o empata en el trabajo de oficina de agente, que es donde MiniMax ha puesto el foco, y está cerca de los mejores en la programación del día a día. Se queda atrás en las tareas más difíciles, en el terminal y en el conocimiento general. Y es un modelo Flash: se compara con los modelos más potentes, pero cuesta una fracción de lo que cuestan ellos.
Lo que dicen las pruebas independientes
Los benchmarks del fabricante sirven para saber en qué ha trabajado. Los de terceros, para saber cuánto fiarse. Sobre M3.1 Flash he encontrado tres, y no dicen todos lo mismo.
- Inteligencia: Artificial Analysis le da 43 puntos en su Intelligence Index, frente a 29 de M3. En el lanzamiento, según VentureBeat, estaba en 42, empatado con GLM-5.3 Flash y algo por debajo de DeepSeek V4.1 Flash-1017 (45).
- Velocidad: MiniMax declara más de 200 tokens por segundo y Artificial Analysis mide unos 96, por debajo de la mediana de modelos parecidos. La diferencia se explica así: MiniMax habla de sus servidores en las mejores condiciones, y Artificial Analysis mide lo que le llega de verdad a quien lo usa, a distintas horas del día. Es rápido, pero no esperes el triple en todo.
- Alucinaciones: es el punto más delicado. En la prueba AA-Omniscience, que mide cuánto sabe un modelo sobre hechos y cuánto se inventa, M3.1 Flash responde bien al 56% de las preguntas, más que los competidores chinos de su franja. Pero, de las respuestas que no son correctas, el 93% son errores dichos con seguridad, en lugar de un «no lo sé». Lo publicó VentureBeat a partir de los datos de Artificial Analysis.
- Trabajo profesional: Vals AI, que prueba los modelos en finanzas, derecho, impuestos y programación, le da un 53,78% en su índice, en el puesto 16 de 26 modelos. En su propio Terminal-Bench 4.0 se queda en el 25,25%, frente al 38,1 que declara MiniMax con otra configuración.
El tercer punto es el que hay que tener en cuenta. Un modelo que se inventa cosas con seguridad funciona bien para escribir código, porque el código se prueba y, si está mal, no funciona. Funciona mucho peor para responder preguntas sobre hechos, escribir textos para publicar o dar información a clientes sin revisión.
Pesos en Hugging Face y licencia: qué puedes hacer de verdad
MiniMax había prometido los pesos para el 23 de octubre y los ha publicado: desde hoy el modelo se puede descargar desde la página oficial en Hugging Face. Los pesos son los archivos que contienen todo lo que ha aprendido el modelo: tenerlos quiere decir poder ejecutarlo en tus propios servidores, sin pasar por la API de MiniMax.
Mucha gente ya lo llama «código abierto», pero la licencia dice otra cosa. Es la MiniMax Community License y funciona así:
- Uso no comercial: libre y gratuito. Puedes estudiarlo, modificarlo y compartirlo.
- Uso comercial: tienes que poner de forma visible «Built with MiniMax M3.1-Flash» en la web, la aplicación o la documentación del producto, y enviar un aviso a MiniMax por email.
- Empresas con más de 20 millones de dólares de facturación anual: necesitan una autorización por escrito de MiniMax antes de usarlo.
- Usos prohibidos: entre otros, fines militares, desinformación y discriminación.
Para un autónomo o una pequeña agencia que lo use para sus clientes, por tanto, se puede, pero con la mención y el aviso. Una empresa grande necesita un acuerdo. Es un modelo de pesos abiertos con condiciones, no de código abierto en el sentido clásico.
¿Y en tu ordenador? No, no es un modelo para un PC. Con 428.000 millones de parámetros, aunque esté comprimido, hace falta un servidor con varias tarjetas gráficas profesionales. MiniMax recomienda vLLM y SGLang, dos programas pensados para servir modelos en producción. Si quieres probar la IA en local en tu ordenador, necesitas modelos mucho más pequeños, como los que se instalan con Ollama, para los que tienes una guía paso a paso.
Cómo probarlo hoy
- MiniMax Agent: la aplicación web de MiniMax, la forma más sencilla de verlo en acción sin escribir código.
- API de MiniMax: desde la plataforma para desarrolladores, con el nombre de modelo MiniMax-M3.1-Flash. La API también es compatible con el formato de la de Anthropic, así que muchas herramientas ya preparadas funcionan cambiando solo la dirección y la clave.
- M Plan y MiniMax Code: la suscripción de MiniMax y su aplicación de escritorio para programar.
- OpenRouter: disponible al mismo precio que la tarifa oficial. La versión gratuita de los primeros días terminó el 22 de octubre.
Una nota para quien trabaja con datos de clientes europeos: en OpenRouter el modelo no está disponible con el enrutamiento dentro de la Unión Europea, y la API de MiniMax pasa por los servidores de la empresa. Si tratas datos personales, es algo que hay que valorar antes, no después.
Para quién es útil de verdad
Tiene sentido para:
- quien construye agentes que trabajan entre varios programas de empresa (CRM, hojas de cálculo, email, programas de gestión), donde es el mejor de la tabla;
- quien usa agentes de programación todo el día y quiere bajar la factura, aceptando quedar algo por debajo de los modelos más potentes en las tareas más difíciles;
- quien trabaja con documentos o repositorios de código muy largos, gracias al millón de tokens a precio único;
- quien quiere un modelo potente para ejecutar en sus propios servidores, con una licencia que lo permite también para trabajar.
No es la mejor opción para:
- respuestas sobre hechos, atención al cliente o textos para publicar sin revisión humana, por su tasa de alucinaciones;
- las tareas más difíciles de programación y de terminal, donde Claude Opus 5 sigue muy por delante;
- las empresas con más de 20 millones de facturación que quieran usar los pesos sin pasar por un acuerdo con MiniMax;
- quien tenga que mantener los datos dentro de la Unión Europea y no tenga infraestructura propia.
Mi opinión sobre M3.1 Flash
Llevo más de diez años trabajando con webs, SEO y contenidos, y desde que uso agentes de IA a diario he aprendido una cosa: para la mayor parte del trabajo no hace falta el modelo más inteligente, hace falta el adecuado para cada tarea. Es el mismo razonamiento que sigo al elegir los tres modelos que uso yo: uno barato y rápido para los trabajos repetitivos, y uno de los grandes solo donde de verdad hace falta.
M3.1 Flash encaja bien en ese esquema. Para automatizaciones entre programas, trabajos con documentos largos y programación del día a día, a 39 céntimos por sesión de trabajo, es difícil de ignorar. Y que miles de desarrolladores lo eligieran como Space Bunny, sin saber de quién era, dice más que cualquier tabla.
El límite, en cambio, es serio. En mi trabajo, del SEO a la GEO para que te citen las inteligencias artificiales, una información equivocada dicha con seguridad es el peor daño que se le puede hacer a un cliente. Un modelo que, cuando no sabe, casi siempre se inventa la respuesta en lugar de pararse, no lo usaría para escribir textos ni para responder sobre hechos sin revisión. Para el código, que se prueba y se corrige, es otra historia.
Todavía no lo he probado en un proyecto real: las cifras de este artículo son las oficiales y las de las pruebas independientes. Mi consejo es el de siempre: prueba el modelo con tus casos reales durante una semana y mira la factura, no solo la tarifa.
Conclusión
MiniMax M3.1 Flash es uno de los modelos más interesantes de este mes en la franja económica: cuesta la mitad que M3, es mucho más capaz, lee un millón de tokens a precio único y es el mejor de la tabla en automatizaciones de empresa. Los pesos están disponibles desde hoy, con una licencia que permite el uso comercial, pero con condiciones claras.
Tiene dos límites que conviene conocer antes de elegirlo: en las tareas más difíciles se queda detrás de los modelos más potentes, como Claude Opus 5, y cuando no sabe algo tiende a inventárselo. Usado para el trabajo adecuado, y revisando los resultados, es hoy una de las formas más baratas de poner a trabajar a un agente de IA.
Preguntas frecuentes
¿Qué es MiniMax M3.1 Flash?
Es un modelo de inteligencia artificial de la empresa china MiniMax, lanzado el 19 de octubre de 2026 y pensado para agentes de IA: automatizaciones entre programas de empresa, programación, uso del ordenador y ciberseguridad. Lee texto, imágenes y vídeo, escribe texto y tiene una memoria de trabajo de 1 millón de tokens.
¿Cuánto cuesta MiniMax M3.1 Flash?
En la API cuesta 0,15 dólares por millón de tokens de entrada, 0,60 de salida y 0,015 por los tokens ya en caché, con el mismo precio en todo el millón de tokens. Es la mitad de la tarifa de MiniMax M3. En los trabajos de agente, MiniMax declara un coste de uso un 70% menor.
¿Qué era Space Bunny?
Era el nombre en clave con el que una primera versión de M3.1 Flash se usó de forma anónima en plataformas como OpenRouter y OpenCode antes del lanzamiento. Según MiniMax, en ese periodo procesó más de 200 billones de tokens. La empresa reveló su identidad el 19 de octubre de 2026.
¿MiniMax M3.1 Flash es de código abierto?
No en el sentido clásico. Los pesos se pueden descargar en Hugging Face desde el 23 de octubre de 2026 con la MiniMax Community License: el uso no comercial es libre, el comercial exige la mención «Built with MiniMax M3.1-Flash» y un aviso a MiniMax, y por encima de 20 millones de dólares de facturación hace falta una autorización por escrito.
¿Es mejor que Claude Opus 5?
En automatizaciones de empresa sí (62,8 frente a 50,3 en Automation-Bench) y en BankerToolBench empatan. En las tareas más difíciles, en la programación desde el terminal y en conocimiento general, Opus 5 sigue muy por delante. La diferencia real es el precio: M3.1 Flash cuesta una pequeña fracción.
¿Puedo usarlo en mi ordenador?
En un PC normal no: tiene unos 428.000 millones de parámetros y hace falta un servidor con varias tarjetas gráficas profesionales, con programas como vLLM o SGLang. Quien no tenga esa infraestructura lo puede usar desde la API de MiniMax, la aplicación MiniMax Agent u OpenRouter.
¿Me puedo fiar de sus respuestas?
Para el código y los trabajos que se pueden comprobar, sí. Para preguntas sobre hechos, menos: en la prueba AA-Omniscience de Artificial Analysis, el 93% de sus respuestas no correctas son errores dichos con seguridad, en lugar de un «no lo sé». Para textos que se van a publicar o información a clientes, siempre hace falta una revisión humana.
Lee también:
Claude Haiku 5.5 vs Gemini 4: precios, benchmarks y cuál conviene de verdad ·
GPT-6.1 Sol: novedades, benchmarks y precios ·
Muse Code de Meta: precios, costes y novedades de la alternativa a Claude Code
Fuentes
- MiniMax, anuncio de M3.1 Flash, 19 de octubre de 2026: velocidad, coste de uso, precio, Space Bunny y versión Pro.
- Hugging Face, ficha de MiniMax-M3.1-Flash: arquitectura, parámetros, benchmarks completos y configuración de las pruebas.
- MiniMax Community License: condiciones para el uso comercial y usos prohibidos.
- MiniMax, tarifas de la API: precios de M3.1 Flash y de M3.
- Artificial Analysis, MiniMax-M3.1-Flash: Intelligence Index, velocidad medida, consumo de tokens y coste por tarea.
- VentureBeat, 19 de octubre de 2026: comparación con DeepSeek y Opus 5 y tasa de alucinaciones.
- Vals AI, MiniMax-M3.1-Flash: Vals Index y pruebas de finanzas, derecho y programación.
- The Decoder: la carrera de precios entre los laboratorios chinos.

Datos estructurados en 2026: cuáles siguen sirviendo (y cuáles ya
Datos estructurados en 2026: cuáles siguen sirviendo (y cuáles ya no) Por Daniele Forciniti Los datos estructurados en 2026 siguen sirviendo, pero…

Migrar una web sin perder posiciones en Google: la guía
Migrar una web sin perder posiciones en Google: la guía 2026 Por Daniele Forciniti Migrar una web sin perder posiciones en Google…
Search Console: los informes que revisar cada mes en 2026
Search Console: los informes que revisar cada mes en 2026 Por Daniele Forciniti Los informes de Search Console que revisar cada mes…
Claude Haiku 5.5 vs Gemini 4: precios, benchmarks y cuál
Claude Haiku 5.5 vs Gemini 4: precios, benchmarks y cuál conviene de verdad Por Daniele Forciniti Claude Haiku 5.5 vs Gemini 4…
7 recursos gratuitos para desarrolladores: API de IA, bases de
7 recursos gratuitos para desarrolladores: API de IA, bases de datos, email y monitorización Por Daniele Forciniti Estos son 7 recursos gratuitos…
Gemini 4 Argon: todas las novedades, precios y benchmarks
Gemini 4 Argon: todas las novedades, precios y benchmarks Por Daniele Forciniti Gemini 4 Argon es el nuevo modelo insignia de Google,…