
Gemini 4 Argon: todas las novedades, precios y benchmarks
Por Daniele Forciniti
Gemini 4 Argon es el nuevo modelo insignia de Google, presentado el 30 de septiembre de 2026. Está pensado para trabajos largos y complicados (programación, finanzas, documentos legales y ciberseguridad), puede escribir hasta 1 millón de tokens en una sola respuesta y en el lanzamiento cuesta 2 dólares por millón de tokens de entrada y 10 de salida, un precio que después se duplica. Por ahora, eso sí, solo lo usan los equipos de ciberdefensa seleccionados por Google en el programa Fairwind: la API de pago y los suscriptores de Google AI Ultra llegarán después, sin fecha.
En este artículo tienes todas las novedades explicadas de forma sencilla, la tabla oficial de Google con los 19 benchmarks (también los que pierde), la comparativa con GPT-6.1 Sol y Claude Opus 5.5 y los costes reales. Como casi nadie puede usarlo todavía, lo he puesto a prueba de la única forma seria que hay hoy: he puesto los números de Google al lado de las pruebas independientes de Artificial Analysis y Vals AI, y he rehecho las cuentas con un trabajo real de agente.
Por qué esta noticia es importante
Durante casi un año Google se quedó un paso por detrás en la gama alta. Sacó un modelo Flash tras otro, es decir, la gama rápida y barata, mientras OpenAI y Anthropic presentaban sus modelos insignia. Según Artificial Analysis, Argon es el primer modelo de Google por encima de la gama Flash en más de siete meses, y en su índice saca 23 puntos más que Gemini 3.1 Pro.
Con Argon, Google vuelve a estar entre los tres laboratorios con los modelos más capaces, junto a OpenAI y Anthropic. Para quien usa la IA para trabajar significa más opciones y más competencia en precios: el precio de lanzamiento de Argon es idéntico al de GPT-6.1 Sol, que salió el día antes.
Hay también un detalle que quien sigue este blog reconocerá. A finales de septiembre conté lo del modelo misterioso que se probaba en Arena bajo el nombre Gemini 3.8 Flash, y entre los rumores había un nombre en clave: «argon». El nombre era correcto y se ha convertido en el oficial. Que el modelo de Arena fuera precisamente Argon, en cambio, Google nunca lo ha confirmado. Y en el nombre no aparece ni «Pro» ni «Flash»: Google no ha explicado la elección y de momento no ha anunciado otras versiones de Gemini 4.
Qué es Argon y quién puede usarlo hoy
Argon es un modelo «de frontera», es decir, de la gama más alta, desarrollado por Google DeepMind. Google lo describe como un modelo creado para razonar durante mucho tiempo en trabajos de muchos pasos: no para responder mejor a una pregunta, sino para terminar un proyecto entero.
| Característica | Gemini 4 Argon |
|---|---|
| Presentado | 30 de septiembre de 2026 |
| Respuesta máxima | 1 millón de tokens (los Gemini anteriores se quedaban en 64.000) |
| Memoria de trabajo | 1 millón de tokens, según Artificial Analysis |
| Qué lee | texto, imágenes, gráficos, documentos y vídeo; responde con texto |
| Razonamiento | high, el nivel más alto disponible |
| Precio de lanzamiento | 2 $ de entrada y 10 $ de salida por millón de tokens |
| Precio completo | 4 $ de entrada y 20 $ de salida, cuando acabe la promoción |
| Texto ya en caché | descuento del 95% sobre el precio de entrada |
| Disponibilidad | solo programa Fairwind y equipos internos de Google |
Quién puede usarlo hoy
Argon solo llega a los socios del Fairwind Program, el canal con el que Google DeepMind da acceso anticipado a sus modelos más potentes a quienes defienden redes e infraestructuras. En la página oficial Google habla de más de 650 socios en todo el mundo: gobiernos y autoridades nacionales de ciberseguridad, quienes gestionan servicios esenciales como sanidad, telecomunicaciones, energía y finanzas, y las grandes plataformas tecnológicas.
Las reglas son estrictas. Google revisa el historial de las organizaciones que lo solicitan, exige acceso con autenticación de varios factores y solo permite usar Argon a los equipos internos de seguridad, respuesta a incidentes y pruebas de penetración. Para ellos el modelo llega sin los bloqueos en temas de ciberseguridad, para que puedan aprovecharlo al máximo y defenderse. Pueden usarlo solo o dentro de CodeMender, el agente de Google que encuentra y corrige fallos en el código.
Cuándo llega para todos los demás
El calendario que ha anunciado Google es este, sin fechas:
- primero los equipos de ciberdefensa del programa Fairwind y los equipos internos de Google;
- después un grupo de testers seleccionados, que ayudan a pulir las protecciones;
- luego los clientes de pago de la API de Gemini y los suscriptores de Google AI Ultra;
- por último desarrolladores, empresas y usuarios en general, «lo antes posible».
Mientras tanto, Google participa en el proceso voluntario del Gobierno de Estados Unidos que prevé el acceso a los modelos antes del lanzamiento. He revisado también la documentación de la API de Gemini: hoy, 2 de octubre, Argon todavía no aparece ni entre los modelos ni en la lista de precios. Si abres la app de Gemini o Google AI Studio, el modelo de Google más capaz que puedes usar sigue siendo Gemini 3.8 Flash.
Las novedades de Argon explicadas de forma sencilla
1. Hasta 1 millón de tokens en una sola respuesta
Es la novedad más visible. Los tokens son los trocitos de palabras con los que la IA lee y escribe. Los modelos Gemini anteriores podían escribir como máximo 64.000 tokens por respuesta; Argon llega a 1 millón, casi dieciséis veces más. Para que te hagas una idea del tamaño, Artificial Analysis calcula que 1 millón de tokens equivale a unas 1.500 páginas A4 escritas en Arial 12.
No significa que te vaya a escribir una novela en cada pregunta. Significa que puede razonar mucho más tiempo antes de responder y producir de una sola vez trabajos enormes, como miles de líneas de código o un documento largo con todas sus partes. Según Google, cuando el modelo tiene espacio para generar cientos de miles de tokens, consigue resolver problemas difíciles de una sola tacada.
Para manejar respuestas tan largas, la API de Gemini tiene una función nueva que Artificial Analysis ha usado en sus pruebas: la respuesta se pausa y continúa en las llamadas siguientes, así no se corta por los límites de tiempo.
La otra cara de la moneda es el consumo. Cuanto más escribe y razona el modelo, más tokens pagas. En las pruebas de Artificial Analysis, Argon usa de media 62.000 tokens de salida por tarea, frente a los 27.000 de GPT-6 Astra. Vuelvo a ello en la parte de costes, porque es el detalle que cambia la cuenta final.
2. Programación en proyectos largos y reales
Google dice que sus ingenieros usan Argon cada día, desde corregir errores hasta grandes migraciones de código. El resultado más fuerte está en DeepSWE v1.1, la prueba que pone a la IA a trabajar en tareas de desarrollo largas y con código real: 77,9%, la mejor puntuación publicada hasta ahora.
El ejemplo más concreto es el paso de C y C++ a Rust, un lenguaje que protege mejor de los errores en la gestión de la memoria, una de las causas más frecuentes de fallos de seguridad. Los agentes de Argon están trabajando en código que va desde las decenas de miles de líneas de bibliotecas como re2 y libgav1 hasta las más de 800.000 líneas del kernel Zircon de Fuchsia.
En libgav1, el decodificador de vídeo de código abierto de Google, los agentes han sustituido 32.000 líneas de código optimizado a mano por Rust seguro: el resultado es 2,7 veces más rápido que la versión en Rust de partida, con un vídeo idéntico a la salida. Google aclara que estas reescrituras pasan por controles automáticos y manuales, pruebas y revisiones antes de llegar a producción.
3. Trabajo de oficina: finanzas, legal y automatizaciones
Fuera del código, Google apuesta por el trabajo profesional. Argon es el primero en el Vals Index, un índice independiente que mide los modelos en tareas de finanzas, programación, derecho y fiscalidad, dando a cada sector un peso según lo que vale en la economía de Estados Unidos. También destaca en la investigación financiera de varios pasos (Vals Finance Agent v2) y en la investigación y redacción legal (Harvey’s Legal Agent Benchmark).
En AutomationBench, la prueba de Zapier que mide si un agente completa procesos de empresa enteros (ventas, marketing, atención al cliente, finanzas, recursos humanos), es el primero con un 51,3%. Leído al revés, significa que casi la mitad de los procesos no sale bien ni siquiera con el mejor modelo: la automatización completa del trabajo de oficina todavía queda lejos, y conviene saberlo antes de dejar un proceso entero en manos de un agente.
4. Gráficos, documentos y vídeos largos
Argon también lee bien lo que se ve: analiza gráficos profesionales, encuentra detalles dentro de vídeos largos y trabaja con una serie de documentos. En LVBench, que mide la comprensión de vídeos largos, saca un 91,7%, el mejor resultado registrado. En Chartography, una prueba de lectura de gráficos, saca un 71,6% frente al 66,3% de Claude Opus 5.5.
5. Ciberseguridad
Es la razón por la que el lanzamiento empieza por los equipos de ciberdefensa. Google ha entrenado Argon para encontrar, verificar y corregir por sí solo vulnerabilidades graves en el software. En CWE-bench v1, que mide la capacidad de corregir fallos de seguridad, es el primero empatado con GPT-6 Astra con un 68%. En la prueba interna de Google encontró vulnerabilidades en proyectos escritos en 20 lenguajes de programación distintos. En la prueba de Wiz con webs en funcionamiento, sin acceso al código fuente, supera a Gemini 3.8 Flash Cyber, el modelo de Google especializado en seguridad que salió antes.
El caso concreto lo cuenta Wiz, que usa Argon en su iniciativa Scan for Good para proteger gratis infraestructuras públicas críticas: en una de las primeras pruebas, el modelo encontró un fallo grave en un software sanitario usado por hospitales de todo el mundo, que exponía datos personales sensibles. Según Google, los modelos anteriores no lo habían detectado.
6. Ya trabaja dentro de Google
Google dice que miles de empleados ya lo usan, sobre todo para programar, investigar a fondo y escribir. Dos ejemplos:
- Centros de datos: un grupo de agentes de Argon analizó los datos de funcionamiento de los servidores y aplicó por su cuenta optimizaciones que liberan más de 300 TiB de memoria, con un ahorro total estimado de entre 500 TiB y 1 PiB.
- Computación cuántica: ayudó a los investigadores a reducir los recursos necesarios para algunas partes de algoritmos importantes, superando en pocos minutos en un 40% el mejor resultado publicado.
Son resultados comunicados por Google y no verificados por terceros, pero dan una idea del tipo de trabajo para el que está pensado el modelo.
7. Las protecciones antes del lanzamiento para todos
Antes de abrirlo a todo el mundo, Google está reforzando cuatro protecciones:
- Contra el mal uso: el modelo rechaza las peticiones que sirvan para ciberataques o para armas químicas, biológicas, radiológicas y nucleares, pero deja pasar la investigación científica legítima. Google también vigila la actividad interna del modelo para detectar usos sospechosos.
- Contra las instrucciones ocultas: son órdenes maliciosas escondidas dentro de una web o un documento para que la IA haga cosas que el usuario no ha pedido (en la jerga, inyección indirecta de prompts). Según Google, Argon es su modelo más resistente y lidera la prueba de Gray Swan sobre este tipo de ataques.
- Contra las iniciativas no pedidas: un sistema vigila el razonamiento y las acciones del modelo y lo detiene si intenta hacer más de lo que el usuario quería.
- Entornos sellados: las pruebas más arriesgadas se hacen en entornos aislados y cerrados.
Para quien gestiona una web o una empresa, el punto más práctico es el segundo: un agente que navega y lee documentos por ti está expuesto precisamente a este tipo de trampas.
Los benchmarks oficiales de Google, explicados uno a uno
Google ha publicado una tabla con 19 resultados, comparando Argon con GPT-6 Astra, Claude Fable 5.1 y Claude Opus 5.5. Los números de Argon los ha calculado Google con el razonamiento al máximo; los de los demás salen de las clasificaciones públicas o de los datos que han declarado las propias empresas, como explica la nota oficial sobre el método. GPT-6.1 Sol no aparece porque salió el día antes: lo comparo más abajo con las pruebas independientes. En negrita, el mejor de cada fila.
| Área | Prueba | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|---|
| Trabajo de oficina | Vals Index | 68,9% | 63,1% | 65,8% | 67,0% |
| Trabajo de oficina | AutomationBench | 51,3% | 41,4% | 31,4% | 42,5% |
| Trabajo de oficina | Vals Finance Agent v2 | 65,4% | 53,5% | 58,9% | 58,6% |
| Trabajo de oficina | Harvey’s Legal Agent | 19,6% | 5,4% | 6,7% | 3,8% |
| Programación | DeepSWE v1.1 | 77,9% | 74,1% | 67,4% | 74,2% |
| Programación | FrontierSWE v2 | 55,0% | 65,5% | 56,3% | 62,3% |
| Programación | Vibe Code Bench | 91,9% | 89,6% | 90,3% | 90,3% |
| Programación | Terminal-bench 4.0 | 57,4% | 58,2% | 57,9% | 66,4% |
| Machine learning | PostTrainBench | 45,3% | 44,3% | 40,2% | 49,3% |
| Ciencia | Terminal-Bench Science 0.1 | 57,6% | 68,1% | 52,6% | 63,3% |
| Ciencia | LABBench 2 | 88,8% | 85,4% | 68,6% | 73,1% |
| Matemáticas | RiemannBench | 76,0% | 72,0% | 65,6% | 69,6% |
| Textos largos | GraphWalks hasta 128.000 tokens | 99,7% | 98,7% | 91,4% | 90,6% |
| Textos largos | GraphWalks de 256.000 a 1 millón | 84,2% | 71,8% | 65,0% | 66,8% |
| Uso del ordenador | Agent’s Last Exam | 39,5% | 34,2% | n. d. | 38,2% |
| Uso del ordenador | OSWorld-2.0 (parte offline) | 69,2% | 72,6% | n. d. | n. d. |
| Imágenes y vídeo | Chartography | 71,6% | 71,0% | 46,2% | 66,3% |
| Imágenes y vídeo | LVBench | 91,7% | 87,5% | 79,7% | 83,7% |
| Seguridad | CWE-bench v1 | 68,0% | 68,0% | 58,0% | 67,0% |
El balance final: Argon es el primero en solitario en 13 de las 19 pruebas, primero empatado en una (CWE-bench) y queda por detrás en 5. Veamos qué mide cada una, en palabras sencillas.
Dónde gana
- Trabajo de oficina: además del Vals Index y de AutomationBench, gana en investigación financiera (65,4%) y sobre todo en la prueba legal de Harvey, que pide investigar y redactar documentos como en un despacho de abogados: 19,6% frente al 6,7% del segundo, Fable 5.1. Las puntuaciones son bajas para todos, pero es la diferencia más clara de la tabla.
- Programación: DeepSWE v1.1 (77,9% frente al 74,2% de Opus) y Vibe Code Bench, que mide si la IA sabe construir una aplicación que funcione a partir de una descripción (91,9%).
- Ciencia y matemáticas: LABBench 2, investigación en biología con herramientas reales y acceso a internet (88,8%), y RiemannBench, matemáticas avanzadas (76,0%).
- Textos larguísimos: GraphWalks comprueba si el modelo es capaz de seguir las conexiones dentro de textos enormes. Hasta 128.000 tokens todos lo hacen bien; entre 256.000 y 1 millón de tokens Argon saca un 84,2% y el segundo, Astra, se queda en el 71,8%.
- Uso del ordenador: Agent’s Last Exam, una serie de trabajos largos que hay que terminar con el ordenador (39,5% frente al 38,2% de Opus).
- Imágenes y vídeo: Chartography, sobre la lectura de gráficos (71,6%), y LVBench, sobre vídeos largos (91,7%).
Dónde pierde
- FrontierSWE v2 (programación muy difícil): 55,0% frente al 65,5% de Astra y el 62,3% de Opus. Es la derrota más clara, diez puntos y medio.
- Terminal-bench 4.0 (trabajar desde el terminal, es decir, escribiendo comandos en lugar de hacer clic): 57,4% frente al 66,4% de Opus.
- PostTrainBench (entrenar y mejorar otros modelos de IA): 45,3% frente al 49,3% de Opus.
- Terminal-Bench Science (investigación científica desde el terminal): 57,6% frente al 68,1% de Astra.
- OSWorld-2.0 (usar el ordenador como una persona, entre programas y ventanas): 69,2% frente al 72,6% de Astra.
Puesto en fila, el panorama está claro: Argon es el más fuerte en trabajo de oficina, textos larguísimos y vídeo, mientras que en la programación más dura y en el trabajo desde el terminal Opus 5.5 y Astra siguen por delante.
Gemini 4 Argon frente a GPT-6.1 Sol y Claude Opus 5.5
Para comparar modelos de empresas distintas me fío poco de las tablas de las propias empresas: cada una elige las pruebas y la configuración. Por eso aquí uso solo pruebas independientes, hechas por terceros con el mismo método para todos. Los dos rivales son GPT-6.1 Sol, el modelo de gama media que OpenAI presentó el 29 de septiembre, casi al nivel de Astra por una quinta parte del precio, y Claude Opus 5.5 de Anthropic, hoy el primero en el índice de Artificial Analysis. Argon está medido con razonamiento high, el máximo disponible; GPT-6.1 Sol y Opus 5.5, al máximo.
Las mismas pruebas, con el mismo método
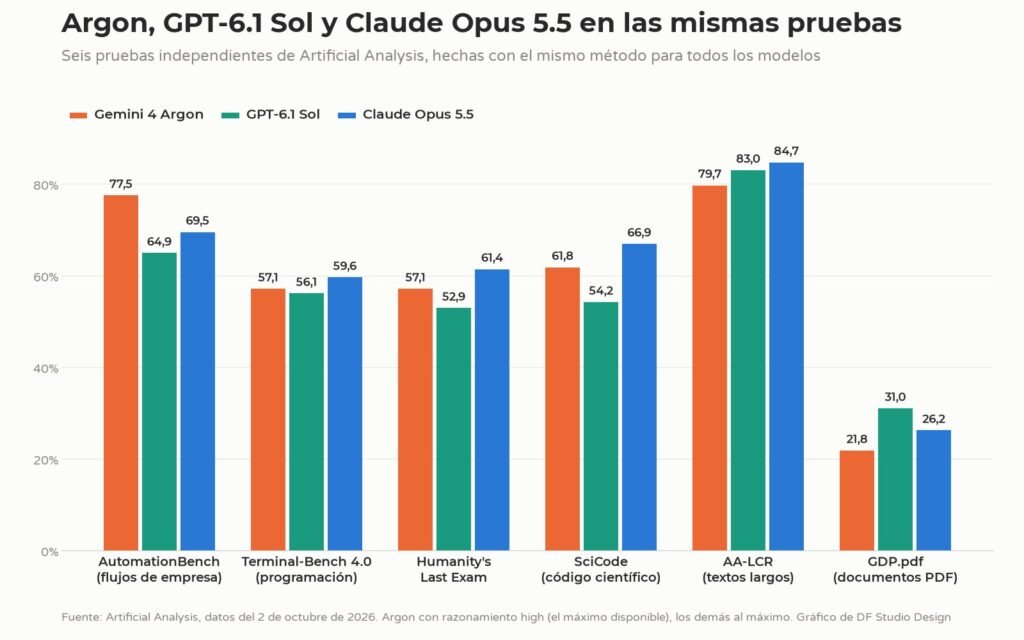
| Prueba | Qué mide | Gemini 4 Argon | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|---|---|
| AutomationBench | procesos de empresa completos entre varias aplicaciones | 77,5% | 64,9% | 69,5% |
| Terminal-Bench 4.0 | programación desde el terminal | 57,1% | 56,1% | 59,6% |
| Humanity’s Last Exam | preguntas dificilísimas de razonamiento y conocimiento | 57,1% | 52,9% | 61,4% |
| SciCode | código para investigación científica | 61,8% | 54,2% | 66,9% |
| AA-LCR | razonar sobre documentos muy largos | 79,7% | 83,0% | 84,7% |
| GDP.pdf | preguntas de trabajo sobre PDF complejos | 21,8% | 31,0% | 26,2% |
| Intelligence Index | media de 10 pruebas | 53 | 52 | 58 |
- Argon frente a GPT-6.1 Sol: Argon gana en 4 de 6 pruebas, con la mayor diferencia en las automatizaciones de empresa (casi 13 puntos). Sol gana en documentos largos y, sobre todo, en PDF complejos. En el índice general están prácticamente empatados: 53 a 52.
- Argon frente a Opus 5.5: Opus gana en 5 de 6 pruebas y sigue siendo el más capaz del índice, con 58 puntos. Argon solo le supera en las automatizaciones de empresa, donde la diferencia, eso sí, es clara: 8 puntos.
Una nota para quien compare las dos tablas: en Terminal-Bench 4.0 Google da a Opus 5.5 un 66,4% y Artificial Analysis un 59,6%. No es un error: Google recoge el mejor resultado de la clasificación oficial y Artificial Analysis repite la prueba con sus propias condiciones. Por eso los números siempre hay que leerlos junto a quien los ha producido.
La prueba de trabajo profesional: Vals Index
Vals AI mide los modelos en tareas de finanzas, programación, derecho y fiscalidad, con pruebas en gran parte privadas. Aquí Argon es el primero de 41 modelos. En segundo lugar está Claude Sonnet 5.5 con un 67,04%; en la tabla pongo los modelos de los que hablamos en este artículo:
| Modelo | Puntuación | Coste por prueba | Duración |
|---|---|---|---|
| Gemini 4 Argon | 68,90% | 15,68 $ | 46 minutos |
| Claude Opus 5.5 | 66,97% | 32,14 $ | 1 hora y 19 minutos |
| GPT-6 Astra | 63,13% | 18,46 $ | 28 minutos |
| GPT-6.1 Sol | 61,15% | 3,24 $ | 43 minutos |
Vals calcula el coste de Argon con el precio completo (4 y 20 dólares), no con el de lanzamiento. Aun así cuesta menos de la mitad que Opus 5.5 con una puntuación más alta. GPT-6.1 Sol es otra historia en precio: cuesta casi cinco veces menos que Argon, con 7,75 puntos menos.
Inteligencia y coste por tarea
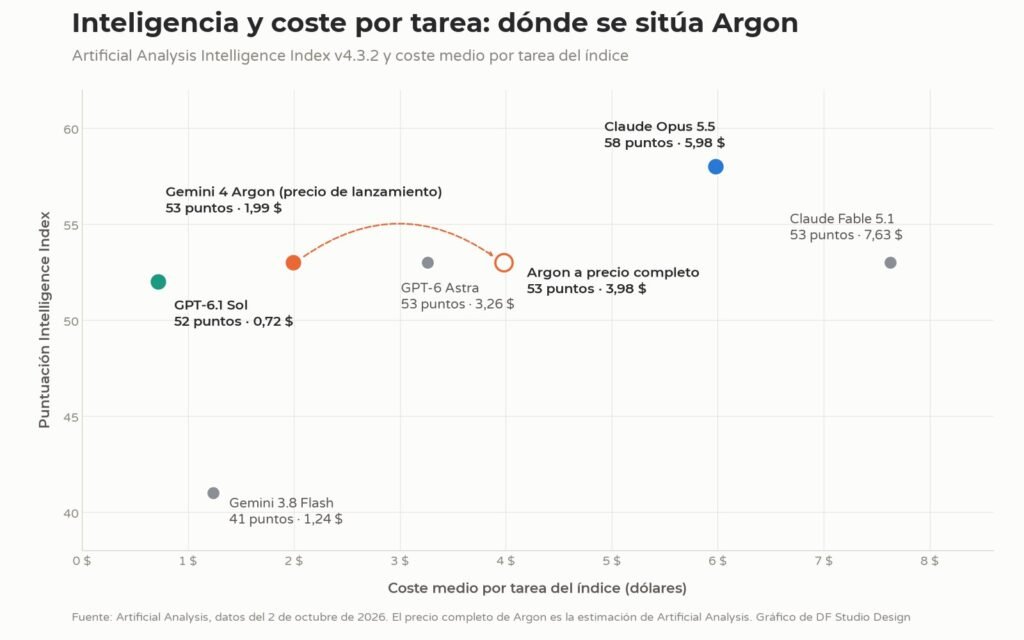
Artificial Analysis resume 10 pruebas en un solo índice y mide cuánto cuesta, de media, que el modelo haga cada tarea. Argon saca 53 puntos, igual que GPT-6 Astra y uno más que GPT-6.1 Sol. Opus 5.5 sigue por delante con 58.
En el coste el panorama cambia. A precio de lanzamiento, Argon cuesta 1,99 dólares por tarea: el 60% de Astra, pero 2,7 veces GPT-6.1 Sol, que cuesta 0,72. Cuando acabe la promoción, según la estimación de Artificial Analysis, subirá a 3,98 dólares: más que Astra y unos dos tercios de Opus 5.5, que cuesta 5,98 dólares.
El dato más interesante: Argon se inventa menos
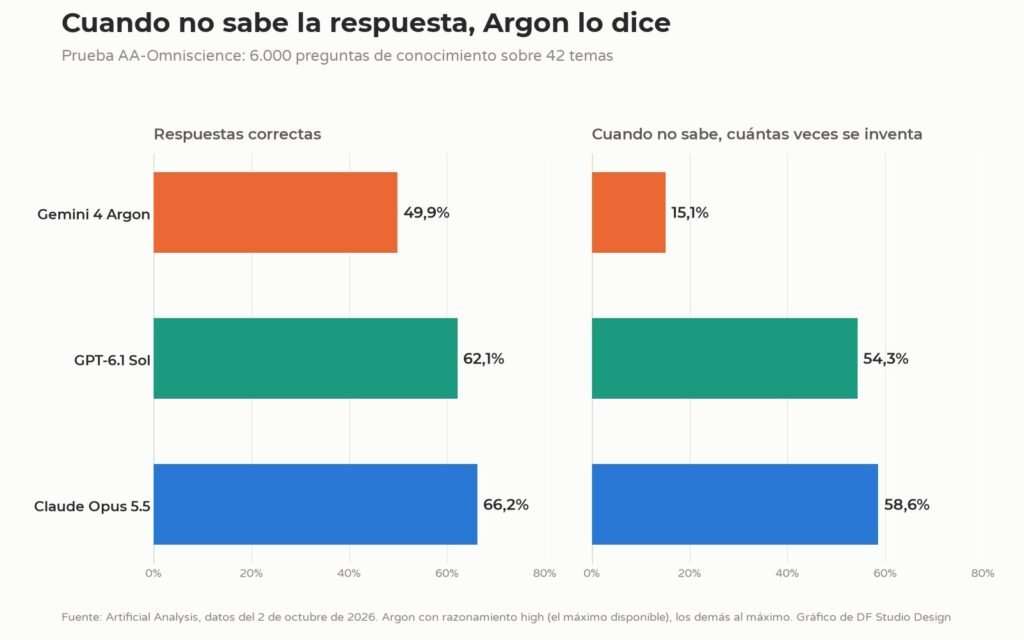
En la prueba AA-Omniscience, 6.000 preguntas de conocimiento sobre 42 temas, Artificial Analysis mide dos cosas: cuántas respuestas son correctas y cuántas veces el modelo, cuando no sabe la respuesta, se inventa una en lugar de decir «no lo sé».
Argon se inventa la respuesta en el 15,1% de los casos, el valor más bajo entre los modelos de este nivel. GPT-6.1 Sol llega al 54,3% y Opus 5.5 al 58,6%.
Eso sí, hay que leerlo bien. Argon acierta solo el 49,9% de las preguntas, frente al 62,1% de Sol y el 66,2% de Opus. La razón es que se lanza mucho menos: responde en el 61% de los casos, los otros por encima del 84%. En la práctica sabe menos cosas de memoria, pero cuando no está seguro lo dice. En la puntuación global de la prueba, que premia las respuestas correctas y penaliza las inventadas, los tres quedan cerca: Opus 46, Argon 42, Sol 42.
Para quien usa la IA para escribir contenidos o investigar es una diferencia práctica: mejor un «no lo sé» que un dato inventado escrito con seguridad. Pero también significa que con Argon conviene investigar con la búsqueda web activada, porque por sí solo recuerda menos cosas que los demás.
Cuánto cuesta de verdad
La lista de precios oficial en la API, en dólares por millón de tokens:
| Concepto | Precio de lanzamiento | Después de la promoción |
|---|---|---|
| Entrada | 2 $ | 4 $ |
| Entrada ya en caché | 0,10 $ | 0,20 $ |
| Salida | 10 $ | 20 $ |
Tres cosas que conviene saber y que en los comunicados apenas se leen:
- No se sabe cuánto dura la promoción. Google no lo ha dicho. Artificial Analysis escribe que el precio rebajado durará «al menos un mes».
- Argon se coloca justo entre sus dos rivales. El precio de lanzamiento es idéntico al de GPT-6.1 Sol y el completo es idéntico al de Claude Opus 5.5.
- Todavía no hay lista de precios completa. En la documentación de la API faltan los conceptos que suelen marcar la diferencia, como posibles precios distintos para peticiones muy largas o los descuentos para trabajos que no corren prisa.
La comparativa de precios
| Modelo | Entrada | Salida |
|---|---|---|
| Gemini 3.8 Flash (hasta el 31 de diciembre) | 0,75 $ | 3,75 $ |
| GPT-6.1 Sol | 2 $ | 10 $ |
| Gemini 4 Argon, precio de lanzamiento | 2 $ | 10 $ |
| Gemini 4 Argon, precio completo | 4 $ | 20 $ |
| Claude Opus 5.5 | 4 $ | 20 $ |
| GPT-6 Astra | 10 $ | 50 $ |
| Claude Fable 5.1 | 10 $ | 50 $ |
Una cuenta con un trabajo real
He rehecho la misma cuenta del artículo sobre GPT-6.1 Sol, para que los números se puedan comparar: un agente que hace 1.000 peticiones de 20.000 tokens de entrada, de los que 16.000 ya están en caché porque vuelve a leer el mismo contexto, y 2.000 tokens de salida. Sin contar la escritura inicial en caché:
| Modelo | Coste de 1.000 peticiones |
|---|---|
| Gemini 4 Argon, precio de lanzamiento | 29,60 $ |
| GPT-6.1 Sol | 29,60 $ |
| Gemini 4 Argon, precio completo | 59,20 $ |
| Claude Opus 5.5 | 59,20 $ |
| GPT-6 Astra | 156,00 $ |
Sobre el papel, por tanto, Argon en el lanzamiento cuesta lo mismo que GPT-6.1 Sol. Pero la cuenta parte de la hipótesis de que todos escriben 2.000 tokens por respuesta, y no es así. Argon es un modelo que razona mucho: para completar el índice de Artificial Analysis produjo 110 millones de tokens de salida, frente a los 67 millones de GPT-6.1 Sol. Opus 5.5, en cambio, produjo 260 millones, más del doble que Argon.
Por eso, en el mismo trabajo, el coste que cuenta es el coste por tarea: 0,72 dólares GPT-6.1 Sol, 1,99 Argon en el lanzamiento, 3,98 Argon a precio completo y 5,98 Opus 5.5. Con la misma tarifa, Argon cuesta casi tres veces lo que GPT-6.1 Sol, porque escribe más.
El consejo práctico para una empresa es sencillo: cuando esté disponible, pruébalo con tus trabajos reales y mira la factura, no la lista de precios.
Lo que todavía no sabemos
- Cuándo llegará a la API, a Google AI Ultra y a la app de Gemini: Google no ha dado fechas.
- Si llegará a quien usa Gemini en España y cuándo, y con qué límites de uso.
- Cuánto durará el precio de lanzamiento.
- Si habrá otras versiones de Gemini 4, por ejemplo más pequeñas y baratas.
- Cómo se comporta en el trabajo real. Bloomberg recogió las dudas de algunos empleados de Google, según los cuales en ciertas tareas de programación el modelo no está a la altura de sus benchmarks; Google respondió que sus equipos lo usan mucho y con buenos resultados, como cuenta también Xataka. Solo lo sabremos cuando podamos probarlo muchos.
Para quién es útil de verdad
Argon tiene sentido sobre todo para:
- Equipos de ciberseguridad: hoy son los únicos que pueden usarlo, y el modelo se ha entrenado precisamente para ellos.
- Empresas con agentes que hacen trabajos largos: automatizaciones entre varias aplicaciones, investigaciones financieras y legales, migraciones de código. Es donde Argon gana también en las pruebas independientes.
- Quien trabaja con vídeos largos, gráficos y documentos enormes: la ventaja en LVBench y GraphWalks es clara.
- Quien necesita respuestas fiables sobre hechos y datos: se inventa mucho menos que los demás, siempre que tenga acceso a la web.
Por ahora, en cambio, no le sirve a:
- Quien usa la IA para escribir, resumir y chatear cada día: hoy no puede usarlo, y para estos trabajos Gemini 3.8 Flash, GPT-6.1 Sol o Claude son suficientes.
- Quien mira antes que nada el presupuesto: GPT-6.1 Sol saca casi la misma puntuación general por un tercio del coste por tarea, más o menos.
- Quien programa proyectos muy difíciles o trabaja mucho desde el terminal: ahí Opus 5.5 y Astra siguen por delante.
Mi opinión después de ponerlo a prueba con los números
Trabajo con webs, SEO y contenidos desde hace más de diez años, y en los dos últimos la IA ha entrado en mi trabajo diario: la uso para escribir código, revisar webs y analizar datos. Sobre Argon no puedo contarte una prueba directa, porque hoy Google solo se lo da a los equipos de ciberdefensa. He hecho lo más honesto que se puede hacer ahora: he cogido los 19 números de Google, los he puesto al lado de las pruebas de quien no tiene intereses en juego y después he rehecho las cuentas de los costes.
Dos cosas me han sorprendido. La primera es el dato de las respuestas inventadas: un modelo que dice «no lo sé» en lugar de inventar es lo que más le pido a una IA cuando la uso para trabajar, y en eso hoy Argon no tiene rival. La segunda es el coste: el precio de lanzamiento es noticia, pero Argon escribe mucho y en el mismo trabajo cuesta casi tres veces lo que GPT-6.1 Sol. Cuando acabe el descuento, la diferencia se duplica.
Dicho esto, Google ha vuelto de verdad. Argon no es el más inteligente en términos absolutos, porque en el índice independiente Opus 5.5 sigue por delante, pero es el mejor en trabajo de oficina y en textos larguísimos, y se inventa mucho menos que los demás. Quien trabaja la visibilidad en las respuestas de las IA, como hago yo en la consultoría SEO, haría bien en no perderlo de vista: mi impresión es que modelos tan prudentes van a necesitar todavía más encontrar en la web fuentes claras y verificables que citar.
Conclusión
Gemini 4 Argon es la vuelta de Google a los modelos de primera línea: primero en trabajo profesional según Vals, empatado con GPT-6 Astra en el índice de Artificial Analysis, muy fuerte en textos largos y vídeo, y con la tasa de respuestas inventadas más baja entre los modelos de su nivel. En la programación más dura y en el trabajo desde el terminal, Claude Opus 5.5 y GPT-6 Astra siguen por delante, y GPT-6.1 Sol saca casi la misma puntuación general gastando mucho menos.
El mayor límite hoy es otro: casi nadie puede usarlo. Hasta que no llegue a la API y a Google AI Ultra, los números son solo números. Cuando llegue, la prueba que cuenta será la de tus propios trabajos, mirando la factura además de la puntuación.
Preguntas frecuentes
¿Qué es Gemini 4 Argon?
Es el nuevo modelo insignia de Google DeepMind, presentado el 30 de septiembre de 2026. Está pensado para trabajos largos y complejos: programación, finanzas, legal y ciberseguridad. Puede escribir hasta 1 millón de tokens en una sola respuesta.
¿Puedo usar ya Argon?
No, salvo que tu organización forme parte del programa Fairwind de Google, reservado a gobiernos, infraestructuras críticas y grandes plataformas tecnológicas. Después llegará a los clientes de pago de la API de Gemini y a los suscriptores de Google AI Ultra, pero Google no ha dado fechas.
¿Cuánto cuesta Gemini 4 Argon?
En la API cuesta 2 dólares por millón de tokens de entrada y 10 de salida durante la promoción de lanzamiento, y después 4 y 20 dólares. El texto ya en caché tiene un descuento del 95% sobre el precio de entrada. Google no ha dicho cuánto dura la promoción.
¿Gemini 4 Argon es mejor que GPT-6.1 Sol y Claude Opus 5.5?
Depende del trabajo. En las pruebas independientes de Artificial Analysis supera a GPT-6.1 Sol en 4 de 6 pruebas y es el primero en automatizaciones de empresa, pero Claude Opus 5.5 sigue siendo más capaz en conjunto. GPT-6.1 Sol cuesta más o menos un tercio por tarea.
¿Qué significa 1 millón de tokens de salida?
Que el modelo puede razonar y escribir durante mucho más tiempo en una sola respuesta: antes el límite de los modelos Gemini era de 64.000 tokens. Sirve para trabajos enormes, como migraciones de código o documentos largos, pero más tokens también significa un gasto mayor.
¿Por qué se llama Argon?
Google no lo ha explicado. «Argon» era el nombre en clave que ya circulaba a mediados de septiembre entre quienes siguen las pruebas de los modelos, y se ha convertido en el nombre oficial. Por ahora Google no ha anunciado versiones Pro o Flash de Gemini 4.
Lee también:
ChatGPT 6 Astra: novedades, precios y benchmarks oficiales ·
GPT-6 Astra y Gemini 3.8 Flash: benchmarks oficiales, precios reales y cuál conviene ·
Claude Fable 5.1 y Mythos 5.1: benchmarks, precios y recorte del 75%
Fuentes
- Google, Gemini 4 Argon: our next era of frontier intelligence, 30 de septiembre de 2026: novedades, precios y disponibilidad.
- Google DeepMind, Gemini 4 Argon Model evaluation: método y tabla de los 19 benchmarks.
- Google DeepMind, Fairwind Program: quién puede usar Argon hoy y con qué reglas.
- Artificial Analysis, análisis de Gemini 4 Argon, 30 de septiembre de 2026: pruebas independientes, coste por tarea y respuestas inventadas.
- Vals AI, Vals Index: la clasificación de trabajo profesional.
- Xataka, 1 de octubre de 2026: benchmarks internos e independientes, y las dudas de algunos empleados de Google recogidas por Bloomberg.

7 recursos gratuitos para desarrolladores: API de IA, bases de
7 recursos gratuitos para desarrolladores: API de IA, bases de datos, email y monitorización Por Daniele Forciniti Estos son 7 recursos gratuitos…

GPT-6.1 Sol: novedades, benchmarks y precios
GPT-6.1 Sol: novedades, benchmarks y precios Por Daniele Forciniti GPT-6.1 Sol es el nuevo modelo de OpenAI presentado ayer, 29 de septiembre…
Gemini 4 Pro en pruebas en Arena bajo el nombre
Gemini 4 Pro en pruebas en Arena bajo el nombre Gemini 3.8 Flash: lo que sabemos de verdad Por Daniele Forciniti Según…
Búsqueda multimodal: ahora Search Console muestra quién te encuentra con
Búsqueda multimodal: ahora Search Console muestra quién te encuentra con una foto Por Daniele Forciniti Desde el 24 de septiembre de 2026…
SEO, AEO, GEO, AIO y SXO: las 5 siglas del
SEO, AEO, GEO, AIO y SXO: las 5 siglas del SEO moderno explicadas de forma sencilla Por Daniele Forciniti SEO, AEO, GEO,…
Claude Opus 5.5, GPT-6 Sol y Luna: precios y benchmarks
Claude Opus 5.5, GPT-6 Sol y Luna: precios y benchmarks comparados Por Daniele Forciniti El 22 de septiembre de 2026 Anthropic publicó…