
MiniMax M3.1 Flash: novità, prezzi e benchmark del modello cinese per agenti AI
Di Daniele Forciniti
MiniMax M3.1 Flash è il nuovo modello di intelligenza artificiale della cinese MiniMax, pensato per gli agenti AI: programmi che lavorano da soli su più passaggi, scrivono codice, usano il computer e spostano dati tra un’applicazione e l’altra. È uscito il 19 ottobre 2026, costa 0,15 dollari per milione di token in entrata e 0,60 in uscita, legge fino a 1 milione di token e secondo MiniMax è quasi tre volte più veloce del modello precedente. Prima del lancio ha girato in anonimo con il nome in codice “Space Bunny”, e da oggi, 23 ottobre, i suoi pesi sono scaricabili su Hugging Face.
In questo articolo trovi la scheda tecnica spiegata in modo semplice, i prezzi con un conto su un lavoro reale, tutti i benchmark ufficiali (anche quelli dove perde), i test indipendenti che MiniMax non mette in evidenza, a partire dalle allucinazioni, e cosa dice davvero la licenza, che non è open source come molti scrivono. Alla fine ti dico per chi ha senso e per chi no.
Perché questa notizia è importante
Per tre motivi. Il primo è il prezzo: con M3.1 Flash MiniMax ha dimezzato il listino del suo modello di punta M3 e, nei lavori da agente, dichiara un costo d’uso più basso del 70%. Sul sito tedesco The Decoder lo hanno raccontato bene: tra i laboratori cinesi la corsa al ribasso dei prezzi non sembra avere un fondo.
Il secondo è il tipo di modello. Non è un chatbot per fare due chiacchiere, è un modello fatto per lavorare: automazioni tra software aziendali, programmazione, uso del computer e sicurezza informatica. È la fascia dove si spende davvero, perché un agente fa decine o centinaia di richieste per finire un solo lavoro, e lì ogni centesimo per milione di token si moltiplica.
Il terzo è il modo in cui è arrivato. Per settimane un modello senza nome, Space Bunny, è stato usato da migliaia di sviluppatori senza sapere chi lo avesse fatto. Solo dopo MiniMax ha detto che era una prima versione di M3.1 Flash. È un modo sempre più comune di lanciare un modello: prima lo si fa provare alla cieca, poi si rivela il marchio.
La storia di Space Bunny
Space Bunny è comparso come modello anonimo su piattaforme molto usate dagli sviluppatori, come OpenRouter (un servizio che dà accesso a centinaia di modelli con un solo account) e OpenCode (un assistente di programmazione open source). Nessuno sapeva chi ci fosse dietro e in rete si facevano ipotesi su diversi laboratori, cinesi e non.
Il 19 ottobre MiniMax ha chiuso il caso nell’annuncio ufficiale: Space Bunny era una prima versione di M3.1 Flash e, mentre girava in anonimo, ha elaborato oltre 200.000 miliardi di token. Per capire la cifra: un token è un pezzetto di parola, e un romanzo intero ne conta circa 150.000. Vuol dire che il modello è stato usato a lungo, e sul serio, da persone che lo hanno scelto senza conoscerne il nome.
La scheda tecnica, spiegata in modo semplice
Questi sono i dati ufficiali, presi dalla model card su Hugging Face, dalla documentazione di MiniMax e dal listino delle API.
| Caratteristica | MiniMax M3.1 Flash |
|---|---|
| Uscita | 19 ottobre 2026 (pesi su Hugging Face dal 23 ottobre) |
| Tipo di modello | multimodale “mixture of experts” |
| Parametri | circa 428 miliardi in totale, 23 miliardi attivi per ogni token |
| Cosa legge | testo, immagini e video |
| Cosa produce | solo testo |
| Memoria di lavoro (contesto) | fino a 1 milione di token |
| Livelli di ragionamento | cinque: low, medium, high, xhigh e max |
| Prezzo in entrata | 0,15 $ per milione di token |
| Prezzo in uscita | 0,60 $ per milione di token |
| Entrata già in cache | 0,015 $ per milione di token |
| Velocità dichiarata | oltre 200 token al secondo, mediana sopra i 170 |
| Licenza | MiniMax Community License (gratis per uso non commerciale, con condizioni per quello commerciale) |
Tre parole della tabella meritano una spiegazione:
- Mixture of experts: il modello è diviso in tanti “esperti” e per ogni pezzo di testo ne accende solo alcuni. Per questo, pur avendo 428 miliardi di parametri, ne usa 23 miliardi alla volta: è grande come conoscenza, ma veloce ed economico come un modello molto più piccolo.
- Contesto da 1 milione di token: è quanto testo il modello tiene a mente in una sola richiesta. Un milione di token vuol dire un intero archivio di codice, o qualche migliaio di pagine di documenti.
- Livelli di ragionamento: puoi chiedergli di pensare poco (risponde prima e costa meno) o tanto (è più preciso ma usa più token). È lo stesso principio che trovi ormai nei modelli di Anthropic, OpenAI e Google.
Una nota per chi va a controllare: nella pagina di Hugging Face, accanto al nome del modello, compare “220B params”. È un calcolo automatico della piattaforma sui file caricati, non il dato del produttore. La model card scritta da MiniMax dice chiaramente 428 miliardi totali e 23 attivi.
Cosa cambia rispetto a MiniMax M3
M3.1 Flash mantiene l’architettura di M3, ma secondo la model card cambia tre cose. Le spiego senza gergo:
- Attenzione “sparsa” in tutto il modello: per capire una frase, un modello guarda le parole che ha letto prima. Con l’attenzione completa le guarda tutte, con quella sparsa solo quelle che servono. MiniMax ha sostituito anche i primi tre livelli che usavano ancora l’attenzione completa. Il risultato è che i testi lunghissimi costano meno da elaborare. La tecnica è descritta nel paper di MiniMax su arXiv.
- Addestramento già “compresso”: i numeri dentro un modello si possono salvare in formato più leggero per risparmiare memoria, ma di solito si perde un po’ di qualità. MiniMax ha addestrato il modello sapendo già che sarebbe stato compresso (si chiama quantization-aware training), così la perdita è minore e il modello occupa meno memoria sui server.
- Decodifica speculativa DSpark: un piccolo modello di supporto prova a indovinare le parole successive e quello grande si limita a confermarle o correggerle. Quando indovina, il testo esce molto più in fretta. È una delle ragioni della velocità triplicata.
Nella pratica, rispetto a M3, cambiano tre numeri:
- Prezzo: la metà. M3 costa 0,30 dollari in entrata e 1,20 in uscita, e il doppio sopra i 512.000 token per richiesta. M3.1 Flash costa 0,15 e 0,60, con lo stesso prezzo su tutto il milione di token.
- Costo d’uso negli agenti: -70% secondo MiniMax, perché al prezzo più basso si somma il fatto che il modello finisce i lavori con meno passaggi.
- Intelligenza misurata da terzi: nell’indice di Artificial Analysis, che mette insieme dieci test diversi, M3 era a 29 punti e M3.1 Flash è a 43. È un salto molto grande per un aggiornamento di mezzo punto.
MiniMax ha anche detto che arriverà una versione Pro, più potente, ma non ha dato date. Flash è il modello veloce ed economico della nuova famiglia, non quello di punta.
Quanto costa MiniMax M3.1 Flash, con un esempio reale
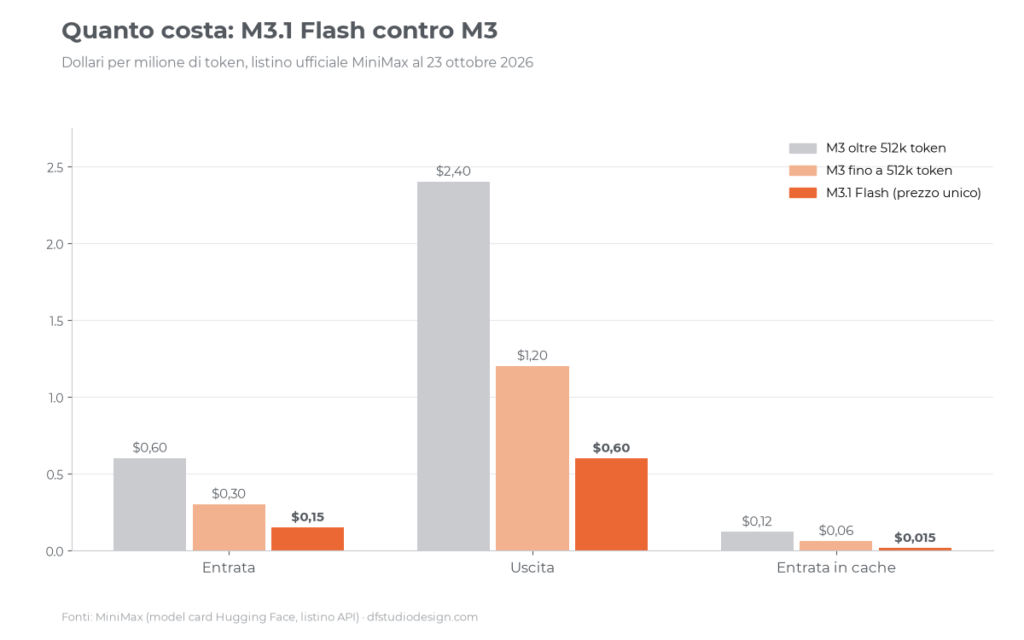
Il listino ufficiale è semplice: 0,15 dollari per milione di token letti, 0,60 per milione di token scritti, 0,015 per i token che il modello ha già letto e tiene in cache. Non ci sono fasce in base alla lunghezza della richiesta, come invece succede con M3 e con molti modelli concorrenti.
Il numero che conta di più è l’ultimo. Un agente di programmazione rilegge di continuo gli stessi file: la prima volta li paga a prezzo pieno, le volte dopo a un decimo. Facciamo un conto su una sessione di lavoro realistica, in cui l’agente legge 5 milioni di token (di cui 4 già in cache) e ne scrive 300.000:
| Voce | M3.1 Flash | M3 (fino a 512k) |
|---|---|---|
| 1 milione di token nuovi in entrata | 0,15 $ | 0,30 $ |
| 4 milioni di token in cache | 0,06 $ | 0,24 $ |
| 300.000 token in uscita | 0,18 $ | 0,36 $ |
| Totale della sessione | 0,39 $ | 0,90 $ |
Meno di 40 centesimi per una sessione di lavoro completa. C’è però un dettaglio che il listino non dice: M3.1 Flash è un modello che parla molto. Artificial Analysis ha contato circa 180 milioni di token scritti per completare il suo indice, contro una mediana di 100 milioni per i modelli simili. Il costo medio per attività resta basso (circa 0,22 dollari, contro 0,51 di M3), ma se lo usi al ragionamento massimo il conto sale più di quanto faccia pensare il prezzo per token.
I benchmark ufficiali, uno per uno
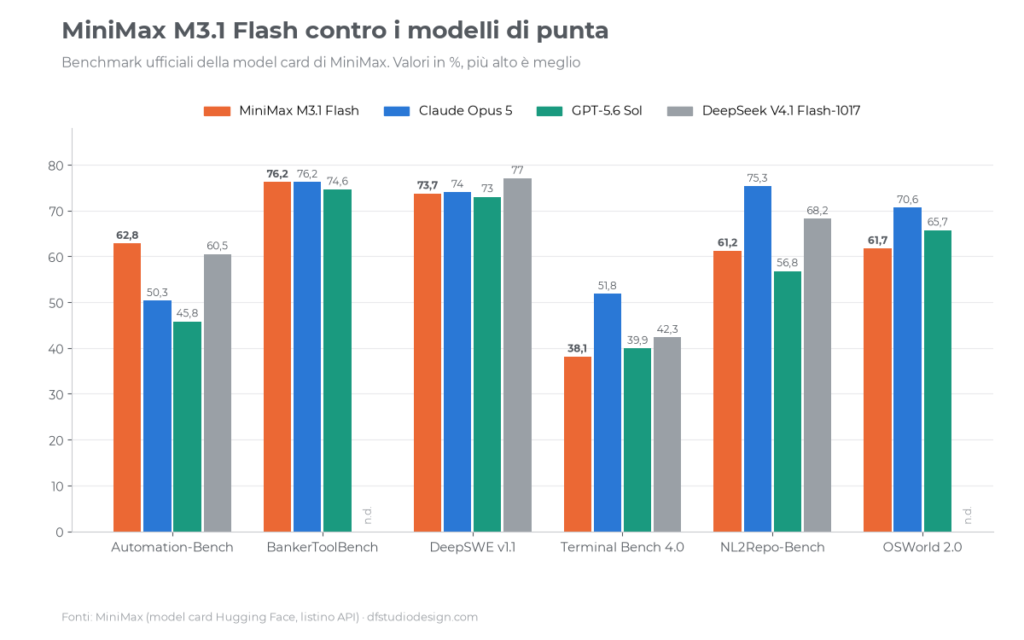
MiniMax ha confrontato M3.1 Flash con DeepSeek V4.1 Flash (in due versioni), Kimi K3, GLM-5.3, GPT-5.6 Sol e Claude Opus 5. Sono numeri dichiarati dal produttore, con impostazioni scelte da lui: vanno letti come un punto di partenza, non come una sentenza. Eccoli divisi per area, con una spiegazione di cosa misura ogni test.
Lavoro d’ufficio e automazioni (CoWork)
- Automation-Bench v1.0.6: 62,8. Misura quanto un agente riesce a completare processi aziendali tra più software (vendite, marketing, assistenza, finanza). È il risultato più alto della tabella, davanti a DeepSeek V4.1 Flash-1017 (60,5) e molto davanti a Opus 5 (50,3). Nella tabella del lancio il valore era 62,2: la model card aggiornata riporta 62,8.
- BankerToolBench: 76,2. Lavori da analista finanziario con strumenti veri. Pari con Claude Opus 5, davanti a GPT-5.6 Sol (74,6).
- LOCA-Bench 256K: 60,3. Lavori su contesti molto lunghi, 256.000 token. Primo posto, appena sopra GPT-5.6 Sol (60,0).
- OSWorld 2.0: 61,7. Uso del computer: aprire programmi, cliccare, compilare. Qui Opus 5 (70,6) e GPT-5.6 Sol (65,7) sono avanti.
- Agents’ Last Exam: 29,6. Compiti molto difficili da agente. Opus 5 arriva a 32,2, GPT-5.6 Sol a 30,6.
- Terminal Bench 4.0: 38,1. Lavoro dal terminale, cioè dalla riga di comando. È uno dei punti deboli: Opus 5 fa 51,8 e anche DeepSeek V4.1 Flash-1017 è avanti (42,3).
- GDP.pdf AA: 20,8. Lavoro su documenti PDF complessi. GPT-5.6 Sol è il migliore con 27,2.
Programmazione
- DeepSWE v1.1: 73,7. Risolvere problemi reali in progetti software. È praticamente alla pari con Opus 5 (74,0) e GPT-5.6 Sol (73,0), ma DeepSeek V4.1 Flash-1017 fa meglio (77,0).
- NL2Repo-Bench: 61,2. Costruire un intero progetto partendo da una descrizione. Opus 5 è molto avanti (75,3) e anche le due versioni di DeepSeek superano M3.1 Flash.
- SWE Refactor Bench: 23,0. Riorganizzare codice esistente senza romperlo. Opus 5 31,0, GPT-5.6 Sol 28,5.
- PostTrain Bench v1.1: 39,3. Lavori di addestramento di modelli. Secondo posto dietro Opus 5 (40,4).
Sicurezza informatica e capacità generali
- CyberGym: 82,2. Trovare e verificare vulnerabilità nel software. Molto vicino a GPT-5.6 Sol (83,6) e GLM-5.3 (84,5).
- BabyVision con strumenti: 91,0. Ragionamento visivo. Opus 5 è il migliore con 94,1.
- HLE senza strumenti: 43,4. Domande difficilissime di ogni materia. Qui si vede la distanza dai modelli di punta: Opus 5 arriva a 55,6, GPT-5.6 Sol a 49,5.
- CharXiv RQ: 82,5. Leggere e capire grafici scientifici. GPT-5.6 Sol 85,2.
Il quadro è chiaro: M3.1 Flash vince o pareggia nei lavori d’ufficio da agente, che sono quelli su cui MiniMax ha puntato, ed è vicino ai migliori nella programmazione di tutti i giorni. Resta indietro nei compiti più difficili, nel terminale e nella conoscenza generale. Ed è un modello Flash: lo stanno confrontando con i modelli di punta, ma costa una frazione di quanto costano loro.
Cosa dicono i test indipendenti
I benchmark del produttore servono a capire su cosa ha lavorato. Quelli fatti da terzi servono a capire quanto fidarsi. Su M3.1 Flash ne ho trovati tre, e non dicono tutti la stessa cosa.
- Intelligenza: Artificial Analysis gli dà 43 punti nel suo Intelligence Index, da 29 di M3. Al lancio, secondo VentureBeat, era a 42, alla pari con GLM-5.3 Flash e poco sotto DeepSeek V4.1 Flash-1017 (45).
- Velocità: MiniMax dichiara oltre 200 token al secondo, Artificial Analysis ne misura circa 96, sotto la mediana dei modelli simili. La differenza si spiega così: MiniMax parla dei suoi server nelle condizioni migliori, Artificial Analysis misura quello che arriva davvero a chi lo usa, in momenti diversi della giornata. Il modello è veloce, ma non aspettarti il triplo di tutto.
- Allucinazioni: è il punto più delicato. Nel test AA-Omniscience, che misura quanto un modello sa sui fatti e quanto inventa, M3.1 Flash risponde bene al 56% delle domande, più dei concorrenti cinesi della sua fascia. Ma tra le risposte non corrette, il 93% sono risposte sbagliate date con sicurezza, invece di un “non lo so”. Lo ha riportato VentureBeat partendo dai dati di Artificial Analysis.
- Lavoro professionale: Vals AI, che testa i modelli su finanza, diritto, tasse e programmazione, gli dà il 53,78% nel suo indice, al sedicesimo posto su 26 modelli. Nel Terminal-Bench 4.0 fatto da loro arriva al 25,25%, contro il 38,1 dichiarato da MiniMax con un’altra configurazione.
Il terzo punto è quello da tenere a mente. Un modello che inventa con sicurezza va bene per scrivere codice, perché il codice si prova e se è sbagliato non funziona. Va molto meno bene per rispondere a domande sui fatti, scrivere testi da pubblicare o dare informazioni ai clienti senza controllo.
Pesi su Hugging Face e licenza: cosa puoi fare davvero
MiniMax aveva promesso i pesi per il 23 ottobre e li ha pubblicati: da oggi il modello è scaricabile dalla pagina ufficiale su Hugging Face. I pesi sono i file che contengono tutto ciò che il modello ha imparato: averli vuol dire poterlo far girare sui propri server, senza passare dalle API di MiniMax.
Molti lo chiamano già “open source”, ma la licenza dice un’altra cosa. È la MiniMax Community License e funziona così:
- Uso non commerciale: libero e gratuito. Puoi studiarlo, modificarlo e condividerlo.
- Uso commerciale: devi scrivere in modo visibile “Built with MiniMax M3.1-Flash” sul sito, nell’app o nella documentazione del prodotto, e mandare una comunicazione a MiniMax via email.
- Aziende sopra i 20 milioni di dollari di fatturato annuo: serve un’autorizzazione scritta di MiniMax prima di usarlo.
- Usi vietati: tra gli altri, scopi militari, disinformazione e discriminazione.
Per un freelance o una piccola agenzia che lo usa per i propri clienti, quindi, si può fare, ma con la dicitura e la comunicazione. Per un’azienda grande serve un accordo. È un modello “open-weight” con condizioni, non open source nel senso classico.
E sul proprio computer? No, non è un modello da PC. Con 428 miliardi di parametri, anche compresso, serve un server con più schede grafiche professionali. MiniMax consiglia vLLM e SGLang, due programmi fatti per servire i modelli in produzione. Se vuoi provare l’AI in locale sul tuo computer, servono modelli molto più piccoli, come quelli che si installano con Ollama, di cui ho scritto una guida passo passo.
Come provarlo oggi
- MiniMax Agent: l’app web di MiniMax, il modo più semplice per vederlo all’opera senza scrivere codice.
- API di MiniMax: dalla piattaforma per sviluppatori, con il nome di modello MiniMax-M3.1-Flash. Le API sono compatibili anche con il formato di quelle di Anthropic, quindi molti strumenti già pronti funzionano cambiando solo l’indirizzo e la chiave.
- M Plan e MiniMax Code: l’abbonamento di MiniMax e la sua app desktop per programmare.
- OpenRouter: disponibile allo stesso prezzo del listino ufficiale. La versione gratuita usata nei primi giorni è terminata il 22 ottobre.
Una nota per chi lavora con dati di clienti europei: su OpenRouter il modello non è disponibile con l’instradamento dentro l’Unione Europea, e le API di MiniMax passano dai server dell’azienda. Se tratti dati personali, è una cosa da valutare prima, non dopo.
Per chi è utile davvero
Ha senso per:
- chi costruisce agenti che lavorano tra più software aziendali (CRM, fogli di calcolo, email, gestionali), dove è il migliore della tabella;
- chi usa agenti di programmazione tutto il giorno e vuole tagliare la bolletta, accettando di essere un po’ sotto i modelli di punta nei compiti più difficili;
- chi deve lavorare su documenti o archivi di codice molto lunghi, grazie al milione di token a prezzo unico;
- chi vuole un modello potente da far girare sui propri server, con una licenza che lo permette anche per lavoro.
Non è la scelta giusta per:
- risposte sui fatti, assistenza clienti o testi da pubblicare senza controllo umano, per via del tasso di allucinazioni;
- i compiti più difficili di programmazione e dal terminale, dove Claude Opus 5 resta molto avanti;
- le aziende sopra i 20 milioni di fatturato che vogliono usare i pesi senza passare da un accordo con MiniMax;
- chi deve tenere i dati dentro l’Unione Europea e non ha un’infrastruttura propria.
La mia opinione su M3.1 Flash
Da oltre dieci anni lavoro con siti web, SEO e contenuti, e da quando uso gli agenti AI ogni giorno ho imparato una cosa: per la maggior parte del lavoro non serve il modello più intelligente, serve quello giusto per quel compito. È lo stesso ragionamento che faccio quando scelgo i tre modelli che uso io: un modello economico e veloce per i lavori ripetitivi, uno di punta solo dove serve davvero.
M3.1 Flash entra bene in questo schema. Per automazioni tra software, lavori su documenti lunghi e programmazione di tutti i giorni, a 39 centesimi per una sessione di lavoro, è difficile da ignorare. E il fatto che migliaia di sviluppatori lo abbiano scelto come Space Bunny, senza sapere di chi fosse, dice più di qualsiasi tabella.
Il limite però è serio. Nel mio lavoro, dalla SEO alla GEO per farsi citare dalle intelligenze artificiali, un’informazione sbagliata detta con sicurezza è il danno peggiore che si possa fare a un cliente. Un modello che, quando non sa, quasi sempre inventa invece di fermarsi non lo userei per scrivere testi o per rispondere sui fatti senza un controllo. Per il codice, che si prova e si corregge, è un altro discorso.
Non l’ho ancora provato su un progetto vero: i numeri di questo articolo sono quelli ufficiali e dei test indipendenti. Il consiglio che do è quello di sempre: prova il modello sui tuoi casi reali per una settimana e guarda la fattura, non solo il listino.
Conclusione
MiniMax M3.1 Flash è uno dei modelli più interessanti usciti questo mese nella fascia economica: costa la metà di M3, è molto più capace, legge un milione di token a prezzo unico ed è il migliore della tabella nelle automazioni aziendali. I pesi sono disponibili da oggi, con una licenza che permette l’uso commerciale ma con condizioni precise.
Ha due limiti da conoscere prima di sceglierlo: nei compiti più difficili resta dietro ai modelli di punta come Claude Opus 5, e quando non sa una cosa tende a inventarla. Usato per il lavoro giusto, con un controllo sui risultati, è uno dei modi più economici per far lavorare un agente AI oggi.
FAQ
Che cos’è MiniMax M3.1 Flash?
È un modello di intelligenza artificiale della cinese MiniMax, uscito il 19 ottobre 2026, pensato per gli agenti AI: automazioni tra software aziendali, programmazione, uso del computer e sicurezza informatica. Legge testo, immagini e video, scrive testo e ha una memoria di lavoro da 1 milione di token.
Quanto costa MiniMax M3.1 Flash?
Nelle API costa 0,15 dollari per milione di token in entrata, 0,60 in uscita e 0,015 per i token già in cache, con lo stesso prezzo su tutto il milione di token. È la metà del listino di MiniMax M3. Nei lavori da agente MiniMax dichiara un costo d’uso più basso del 70%.
Che cos’era Space Bunny?
Era il nome in codice con cui una prima versione di M3.1 Flash è stata usata in anonimo su piattaforme come OpenRouter e OpenCode prima del lancio. Secondo MiniMax, in quel periodo ha elaborato oltre 200.000 miliardi di token. L’azienda ne ha rivelato l’identità il 19 ottobre 2026.
MiniMax M3.1 Flash è open source?
Non nel senso classico. I pesi sono scaricabili su Hugging Face dal 23 ottobre 2026 con la MiniMax Community License: l’uso non commerciale è libero, quello commerciale richiede la dicitura “Built with MiniMax M3.1-Flash” e una comunicazione a MiniMax, e sopra i 20 milioni di dollari di fatturato serve un’autorizzazione scritta.
È meglio di Claude Opus 5?
Nelle automazioni aziendali sì (62,8 contro 50,3 su Automation-Bench) e su BankerToolBench sono pari. Nei compiti più difficili, nella programmazione dal terminale e nella conoscenza generale Opus 5 resta molto avanti. La differenza vera è il prezzo: M3.1 Flash costa una piccola frazione.
Posso usarlo sul mio computer?
Sul normale PC no: ha circa 428 miliardi di parametri e serve un server con più schede grafiche professionali, usando programmi come vLLM o SGLang. Chi non ha questa infrastruttura lo può usare dalle API di MiniMax, dall’app MiniMax Agent o da OpenRouter.
Si può fidare delle sue risposte?
Per il codice e i lavori che si possono verificare è affidabile. Per le domande sui fatti meno: nel test AA-Omniscience di Artificial Analysis il 93% delle sue risposte non corrette sono errori dati con sicurezza, invece di un “non lo so”. Per testi da pubblicare o informazioni ai clienti serve sempre un controllo umano.
Leggi anche:
Claude Haiku 5.5 vs Gemini 4: prezzi, benchmark e chi conviene davvero ·
GPT-6.1 Sol: novità, benchmark e costi ·
Muse Code di Meta: prezzi, costi e novità dell’alternativa a Claude Code
Fonti
- MiniMax, annuncio di M3.1 Flash, 19 ottobre 2026: velocità, costo d’uso, prezzo, Space Bunny e versione Pro in arrivo.
- Hugging Face, model card di MiniMax-M3.1-Flash: architettura, parametri, benchmark completi e configurazioni dei test.
- MiniMax Community License: condizioni per l’uso commerciale e usi vietati.
- MiniMax, listino delle API: prezzi di M3.1 Flash e di M3.
- Artificial Analysis, MiniMax-M3.1-Flash: Intelligence Index, velocità misurata, consumo di token e costo per attività.
- VentureBeat, 19 ottobre 2026: confronto con DeepSeek e Opus 5 e tasso di allucinazioni.
- Vals AI, MiniMax-M3.1-Flash: Vals Index e test su finanza, diritto e programmazione.
- The Decoder: la corsa ai prezzi tra i laboratori cinesi.

Dati strutturati nel 2026: quali servono ancora (e quali non
Dati strutturati nel 2026: quali servono ancora (e quali non più) Di Daniele Forciniti I dati strutturati nel 2026 servono ancora, ma…

Migrare un sito senza perdere posizioni su Google: la guida
Migrare un sito senza perdere posizioni su Google: la guida 2026 Di Daniele Forciniti Migrare un sito senza perdere posizioni su Google…
Search Console: i report da controllare ogni mese nel 2026
Search Console: i report da controllare ogni mese nel 2026 Di Daniele Forciniti I report di Search Console da controllare ogni mese…
Claude Haiku 5.5 vs Gemini 4: prezzi, benchmark e chi
Claude Haiku 5.5 vs Gemini 4: prezzi, benchmark e chi conviene davvero Di Daniele Forciniti Claude Haiku 5.5 vs Gemini 4 è…
7 risorse gratuite per sviluppatori: API di AI, database, email
7 risorse gratuite per sviluppatori: API di AI, database, email e monitoraggio Di Daniele Forciniti Queste sono 7 risorse gratuite per sviluppatori…
Gemini 4 Argon: tutte le novità, costi e benchmark
Gemini 4 Argon: tutte le novità, costi e benchmark Di Daniele Forciniti Gemini 4 Argon è il nuovo modello di punta di…