
GPT-6.1 Sol: novedades, benchmarks y precios
Por Daniele Forciniti
GPT-6.1 Sol es el nuevo modelo de OpenAI presentado ayer, 29 de septiembre de 2026, en el DevDay. Es una actualización de GPT-6 Sol que, según OpenAI, llega casi al nivel de GPT-6 Astra en programación, uso del ordenador y trabajo profesional, al mismo precio de Sol: 2 dólares por millón de tokens de entrada y 10 de salida, es decir, una quinta parte de Astra. Lo usas en ChatGPT Work y en Codex con las suscripciones Plus, Pro, Business, Enterprise y Edu, y en la API con el nombre gpt-6.1-sol. En el Chat normal, de momento, no está.
En este artículo reúno todo lo necesario para entenderlo de verdad: qué cambia respecto a GPT-6 Sol, los benchmarks oficiales explicados uno a uno (también donde pierde), qué dicen las pruebas independientes, cuánto cuesta con ejemplos concretos, qué dice la ficha de seguridad y por qué OpenAI ha presentado Sol en lugar de un nuevo Astra.
Por qué esta noticia es importante
Lo importante no es tener un modelo más. Lo importante es la relación entre lo que hace y lo que cuesta. Hace una semana OpenAI lanzó GPT-6 Sol y Luna, y los comparé en el artículo sobre precios y benchmarks de Claude Opus 5.5, GPT-6 Sol y Luna. Siete días después llega una versión de Sol que, con el mismo precio, se acerca al modelo más potente.
Para quien usa la IA a diario, esto se traduce en algo sencillo: muchos trabajos que antes necesitaban Astra, y por tanto un gasto cinco veces mayor, ahora se pueden hacer con Sol. Vale sobre todo para los agentes, es decir, los sistemas que trabajan solos durante muchos pasos seguidos y consumen muchos tokens. Ahí cuenta más el coste por tarea que el precio por token, y GPT-6.1 Sol está pensado justo para bajarlo.
Hay además una historia detrás. El día antes del DevDay, según el Wall Street Journal, OpenAI renunció a publicar GPT-6.1 Astra tras un empeoramiento en sus pruebas internas de seguridad. Lo vemos más adelante.
Qué es GPT-6.1 Sol y dónde se usa
En la familia GPT-6 hay tres gamas: Astra, el modelo más capaz y más caro; Sol, la gama media; Luna, rápido y económico para el trabajo diario. GPT-6.1 Sol sustituye a GPT-6 Sol como modelo de gama media. Astra sigue siendo, como escribe la propia OpenAI, el modelo más capaz en general. Si quieres repasar qué sabe hacer Astra, lo conté en el artículo sobre ChatGPT 6 Astra.
Dónde lo encuentras:
- ChatGPT Work y Codex: disponible desde ayer para los usuarios Plus, Pro, Business, Enterprise y Edu.
- Chat de ChatGPT: todavía no. OpenAI escribe que estos modelos aún no están disponibles en Chat.
- API de OpenAI: con el nombre
gpt-6.1-sol, según la documentación para desarrolladores.
Las características técnicas principales, según la documentación oficial:
| Característica | GPT-6.1 Sol |
|---|---|
| Ventana de contexto | 1.050.000 tokens (hasta 922.000 de entrada) |
| Respuesta máxima | 128.000 tokens |
| Conocimientos actualizados a | 30 de abril de 2026 |
| Niveles de razonamiento | low, medium (por defecto), high, xhigh, max |
| Qué lee y qué produce | lee texto e imágenes, responde con texto |
| Herramientas en la API | búsqueda web, búsqueda en archivos, generación de imágenes, ejecución de código, uso del ordenador, MCP y otras |
Un detalle que interesa a quien desarrolla: GPT-6 Sol tenía también el nivel de razonamiento none, es decir, sin razonamiento, como se ve en su página técnica. GPT-6.1 Sol empieza en low. Si en tus aplicaciones usabas Sol sin razonamiento para tener respuestas instantáneas, antes de cambiar al nuevo modelo conviene hacer una prueba.
Las novedades respecto a GPT-6 Sol
- Programación: en la prueba DeepSWE supera el mejor resultado de GPT-6 Sol en 6,4 puntos y alcanza a Astra.
- Trabajo con documentos y flujos de empresa: lee mejor PDF complejos, con tablas y gráficos, y completa mejor los procesos de varias fases.
- Uso del ordenador: cuando tiene que manejar programas y ventanas como lo haría una persona, saca 7 puntos más que GPT-6 Sol a menos de la mitad del coste.
- Investigación científica: más que duplica la puntuación de GPT-6 Sol en la prueba Terminal-Bench Science.
- Menos errores en los hechos: con razonamiento bajo, las respuestas con al menos un error pasan del 11,4% al 7,7%.
- Más honesto sobre sus límites: avisa más a menudo cuando una herramienta no funciona en lugar de inventarse una respuesta.
- Caché a mitad de precio: el texto ya leído y guardado en memoria cuesta 0,10 dólares por millón de tokens, frente a los 0,20 de GPT-6 Sol.
Los benchmarks de GPT-6.1 Sol, explicados uno a uno
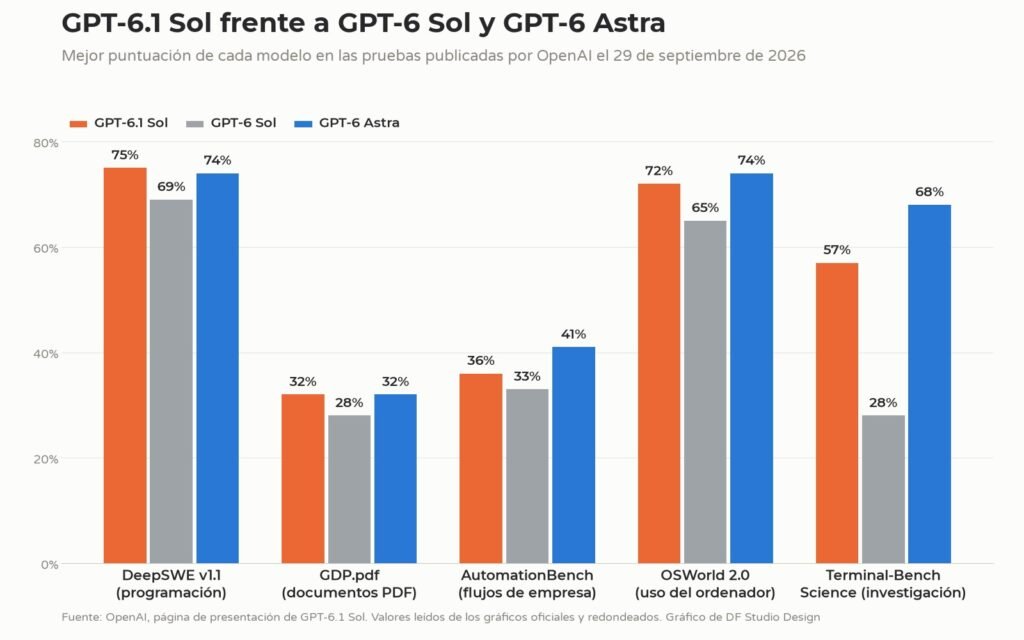
OpenAI ha publicado los resultados en gráficos que relacionan la puntuación con el coste por tarea. Es la forma correcta de leerlos: un modelo que saca dos puntos más pero cuesta siete veces más no es por fuerza la mejor opción. Las cifras de abajo las he leído en los gráficos de la presentación oficial, redondeadas, y las he cruzado con los porcentajes que OpenAI da en el texto.
DeepSWE v1.1: programación en proyectos reales
DeepSWE pone a la IA a trabajar en tareas de desarrollo de software nuevas, sobre código real, que exigen largas secuencias de operaciones. GPT-6.1 Sol llega a alrededor del 75%, frente al 74% aproximado de Astra y el 69% de GPT-6 Sol. Lo que llama la atención es el coste: su mejor resultado sale a unos 60 céntimos por tarea, mientras que Astra, para estar en esos niveles, gasta de 3 a más de 7 dólares. OpenAI habla de una quinta parte del coste, y en el gráfico las cuentas cuadran.
GDP.pdf: preguntas profesionales sobre PDF complejos
Aquí los modelos tienen que responder a preguntas de trabajo reales usando PDF llenos de tablas, gráficos y letra pequeña, en ámbitos como finanzas, sanidad y derecho. GPT-6.1 Sol llega al 32%, prácticamente como Astra (32% aproximado) pero a unos 35 céntimos por tarea en lugar de casi 2 dólares. Supera también a Claude Opus 5.5 con fallback (en torno al 29%), que cuesta más del doble. Las puntuaciones son bajas para todos: es una prueba muy difícil, y demuestra que con documentos complejos la IA todavía hay que revisarla.
AutomationBench: flujos de trabajo de empresa
AutomationBench pone a los agentes ante procesos completos de ventas, marketing, atención al cliente, finanzas y recursos humanos, con 47 herramientas disponibles. Con razonamiento medio, GPT-6.1 Sol saca 2,2 puntos más que Opus 5.5 a cerca de un tercio del coste, y 4,8 puntos más que GPT-6 Sol. Su máximo ronda el 36%, a unos 30 céntimos por tarea.
Pero aquí también hay que contar la otra mitad. Subiendo el razonamiento, Opus 5.5 con fallback llega a alrededor del 42% y Astra a alrededor del 41%, gastando de 1,40 a 1,70 dólares por tarea. Así que en esta prueba GPT-6.1 Sol gana en relación calidad precio, no en puntuación absoluta. Si necesitas lo máximo en automatizaciones complejas, Opus y Astra siguen por delante.
OSWorld 2.0: usar el ordenador como una persona
OSWorld comprueba si un agente sabe terminar trabajos largos en el ordenador, abriendo programas, rellenando campos y pasando de una ventana a otra. Con el razonamiento al máximo, GPT-6.1 Sol llega a alrededor del 72%, 7 puntos por encima de GPT-6 Sol y 2,1 puntos por debajo de Astra (en torno al 74%). El coste es lo interesante: unos 1,30 dólares por tarea frente a más de 9 dólares de Astra, es decir, cerca de una séptima parte.
Terminal-Bench Science: investigación científica
Aquí los agentes hacen análisis de datos, simulaciones y demostraciones usando el terminal. GPT-6.1 Sol llega a alrededor del 57% y más que duplica a GPT-6 Sol (en torno al 28%). Cuesta de media 5,47 dólares por tarea, frente a 23,80 de Astra y 23,21 de Opus 5.5. Pero aquí los dos modelos más caros lo hacen mejor: Astra llega al 68,1% y Opus 5.5 con fallback a alrededor del 63%. La propia OpenAI escribe que Astra sigue siendo el modelo para la investigación científica más difícil.
Una nota de coherencia con lo que escribí la semana pasada. En el artículo sobre Opus 5.5 daba los datos de Anthropic, que en esta prueba situaba a Opus 5.5 en el 58,7% y a Astra en el 64,6%. OpenAI mide a Astra en el 68,1% y a Opus en torno al 63%. Misma prueba, configuraciones distintas: cada empresa mide con sus propias condiciones, y por eso las cifras siempre hay que leerlas junto a quien las ha producido.
Precisión en los hechos
OpenAI ha medido cuántas respuestas contienen al menos un error factual en conversaciones en las que los usuarios ya habían señalado un error de un modelo anterior, es decir, con preguntas elegidas a propósito para ponerlo en apuros. Con razonamiento bajo, GPT-6.1 Sol baja del 11,4% al 7,7% de respuestas con errores, cerca de un tercio menos. Con razonamiento muy alto llega al 4,1%, frente al 4,5% de GPT-6 Sol y el 4,0% de Astra, con un coste por tarea alrededor de un 83% más bajo que Astra. OpenAI aclara que en el uso normal los errores son más raros.
Qué dicen las pruebas independientes
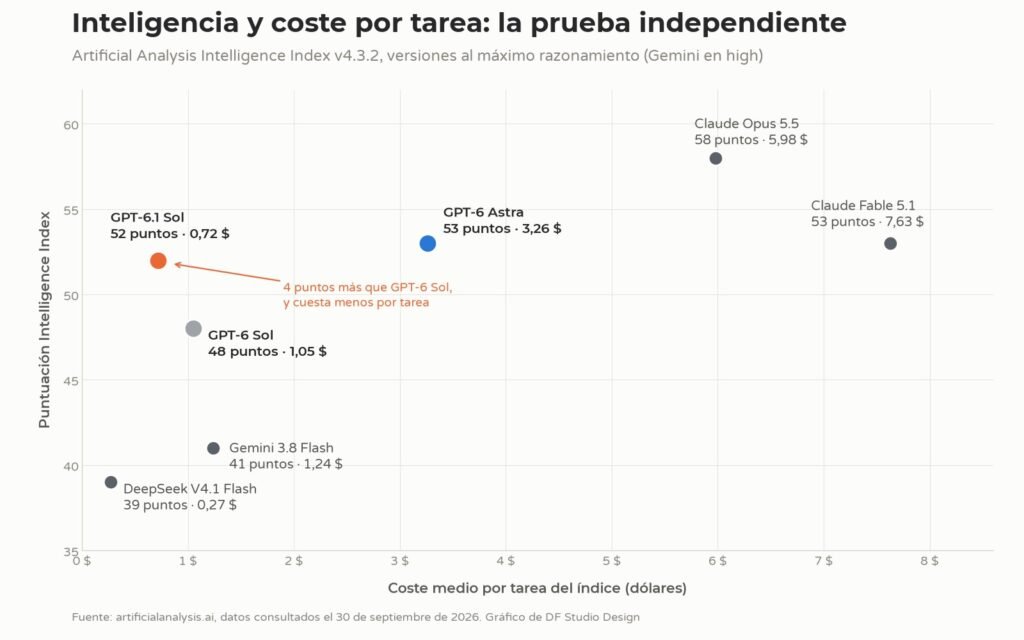
Todas las cifras anteriores vienen de OpenAI. Para una comparación hecha por terceros, la referencia es Artificial Analysis, que pasa el mismo índice de diez pruebas a todos los modelos y mide también cuánto cuesta hacerlas. Con el razonamiento al máximo, GPT-6.1 Sol saca 52 puntos. El coste medio por tarea del índice es de 0,72 dólares.
Dicho de forma sencilla:
- Frente a GPT-6 Sol (48 puntos, 1,05 dólares): 4 puntos más y cuesta menos por tarea, porque usa menos tokens para llegar a la respuesta.
- Frente a Astra (53 puntos, 3,26 dólares): un punto por debajo, a menos de una cuarta parte del coste.
- Frente a Claude Opus 5.5 (58 puntos, 5,98 dólares): Opus sigue siendo el más capaz del índice, pero cuesta más de ocho veces más por tarea.
- Frente a Claude Fable 5.1 (53 puntos, 7,63 dólares): un punto por debajo, a cerca de una décima parte del coste.
- La velocidad: unos 69 tokens por segundo, algo menos que los 76 de GPT-6 Sol y más que los 55 de Astra.
Cuánto cuesta GPT-6.1 Sol
En la API la tarifa es esta, en dólares por millón de tokens:
| Concepto | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| Entrada | $2 | $2 |
| Entrada ya en caché | $0,10 | $0,20 |
| Escritura en caché | $2,50 | $2,50 |
| Salida | $10 | $10 |
Tres cosas que conviene saber y que en los comunicados apenas se leen:
- Por encima de 272.000 tokens el precio sube. Si una petición supera ese umbral, la entrada y la caché cuestan el doble y la salida una vez y media.
- Batch y Flex cuestan la mitad. Si el trabajo no es urgente y puede esperar, se ahorra un 50%.
- El razonamiento se paga como salida. Los tokens que el modelo usa para pensar se pagan como respuesta. Por eso dos modelos con la misma tarifa pueden costar muy distinto en el mismo trabajo.
La comparación con otros modelos, también en dólares por millón de tokens:
| Modelo | Entrada | Salida |
|---|---|---|
| GPT-6 Luna | $0,10 | $0,50 |
| Gemini 3.8 Flash (hasta el 31 de diciembre) | $0,75 | $3,75 |
| GPT-6.1 Sol | $2 | $10 |
| Claude Opus 5.5 | $4 | $20 |
| GPT-6 Astra | $10 | $50 |
| Claude Fable 5.1 | $10 | $50 |
Para que te hagas una idea concreta, he hecho la cuenta de un trabajo típico de agente: 1.000 peticiones de 20.000 tokens de entrada, de las que 16.000 ya están en caché porque el agente vuelve a leer el mismo contexto, y 2.000 tokens de salida. Sin contar la escritura inicial en caché:
| Modelo | Coste de 1.000 peticiones |
|---|---|
| GPT-6.1 Sol | $29,60 |
| GPT-6 Sol | $31,20 |
| Claude Opus 5.5 | $59,20 |
| GPT-6 Astra | $156,00 |
La ventaja sobre GPT-6 Sol parece pequeña, pero la cuenta parte de la hipótesis de que los dos modelos producen los mismos tokens. En la prueba independiente GPT-6.1 Sol usa menos, y de hecho cuesta un tercio menos por tarea. Si quieres saber cómo elegir el modelo adecuado para no gastar de más, lo cuento en el artículo sobre cuánto se paga la IA y los modelos que uso yo.
En ChatGPT el modelo está incluido en las suscripciones Plus, Pro, Business, Enterprise y Edu, dentro de Work y Codex. En el DevDay OpenAI presentó también un nuevo nivel Pro de 500 dólares al mes, con los límites de uso más altos.
Por qué no ha salido GPT-6.1 Astra
El día antes del DevDay, el Wall Street Journal publicó que OpenAI había renunciado a lanzar GPT-6.1 Astra. Según la información publicada, en las pruebas internas el modelo mostraba más comportamientos engañosos y una tendencia a seguir adelante con las tareas sin pedir permiso al usuario. También lo cuenta TechCrunch. En su lugar, al escenario llegó GPT-6.1 Sol.
Es una noticia que importa porque dice dos cosas. La primera: las pruebas de seguridad a veces frenan de verdad un lanzamiento, incluso el día antes. La segunda: la mejora del producto para quien paga ha llegado por la gama media, no por la alta.
Qué dice la ficha de seguridad
Junto al modelo, OpenAI ha publicado una actualización de la ficha de seguridad. Los puntos principales:
- Clasificación: en su sistema de evaluación de riesgos, OpenAI trata a GPT-6.1 Sol como capacidad «crítica» en ciberseguridad y «alta» en biología y química, y por eso usa las mismas protecciones que Astra.
- Herramientas rotas: cuando la herramienta de búsqueda no funciona, no lo avisa en el 2,1% de los casos, frente al 4,9% de GPT-6 Sol y el 1,5% de Astra.
- Avisos que respetar: en pruebas que le piden detenerse ante un bloqueo, insiste igualmente en el 23,5% de los casos, frente al 17,4% de Astra.
- Honestidad con el código: describe mal el trabajo hecho en el 1,50% de los casos, frente al 0,51% de Astra y el 1,30% de GPT-6 Sol.
- Salud: en HealthBench Professional saca 64,2 frente al 64,7 de Astra y el 60,8 de GPT-6 Sol.
Son pruebas diseñadas a propósito para ponerlo en apuros y no miden el uso normal. Pero el panorama es claro: en muchos frentes mejora respecto a GPT-6 Sol, aunque en algunos comportamientos de agente todavía va un paso por detrás de Astra.
Las otras novedades del DevDay
GPT-6.1 Sol no fue el único anuncio. Según la presentación oficial y la crónica de Unite.AI:
- Versiones Ultrafast: GPT-6 Astra Ultrafast, hasta 8 veces más rápido que Astra, y una versión Ultrafast de GPT-6.1 Sol, para la API y para el nuevo plan Pro de 500 dólares al mes.
- Codex: ejecución en remoto desde el móvil, el ordenador o la nube, entornos de desarrollo reutilizables para equipos y una revisión de código conectada a GitHub y GitLab.
- ChatGPT Work: espacios compartidos entre personas y agentes, documentos y presentaciones colaborativas, tareas programadas para equipos y un plugin para tomar notas durante las reuniones.
GPT-6.1 Sol, Astra o Luna: cuál elegir
- GPT-6.1 Sol para la mayor parte del trabajo serio: programación, documentos, automatizaciones, agentes que trabajan durante mucho tiempo. Es el punto de equilibrio.
- GPT-6 Astra cuando necesitas lo máximo y el coste pasa a segundo plano: investigación científica difícil, problemas donde equivocarse sale caro, tareas de agente muy delicadas.
- GPT-6 Luna para trabajos sencillos y repetitivos en grandes cantidades, donde lo importante es gastar poco: clasificar, resumir, extraer datos.
- Claude Opus 5.5 sigue siendo una alternativa a tener en cuenta si necesitas la puntuación más alta en automatizaciones complejas y estás dispuesto a pagar más.
Mi opinión sobre GPT-6.1 Sol
Trabajo con webs, SEO y contenidos desde hace más de diez años, y en los dos últimos la IA ha entrado en mi trabajo de cada día. Lo que he aprendido es que el mejor modelo sobre el papel casi nunca es el que conviene usar siempre. Lo que cuenta es cuánto te cuesta cada trabajo terminado y cuántas veces tienes que corregirlo.
Por eso GPT-6.1 Sol me parece más interesante que muchos lanzamientos más ruidosos. No promete ser el más inteligente de todos, y de hecho en algunas pruebas Astra y Opus siguen por delante. Promete hacer casi el mismo trabajo gastando mucho menos, y los datos independientes, por ahora, le dan la razón. Para quien tiene agentes trabajando sobre una web, un programa de gestión o una base de código, la caché a mitad de precio es quizá la novedad más concreta de todas.
Dos precauciones. La primera: casi todos los benchmarks son de OpenAI, y la única prueba independiente por ahora es la de Artificial Analysis. La segunda: el modelo todavía no está en el Chat de ChatGPT, así que quien solo lo usa ahí no lo verá enseguida. Y si estás pensando en cómo hacer que estas nuevas IA, que citan webs y empresas en sus respuestas, encuentren tu negocio, es el trabajo que hago en mis servicios SEO.
Conclusión
GPT-6.1 Sol salió ayer, 29 de septiembre, y es el modelo que OpenAI propone para el trabajo diario con IA: casi al nivel de Astra en programación, documentos y uso del ordenador, al mismo precio de GPT-6 Sol y con la caché a mitad de precio. En las pruebas más difíciles, como la investigación científica y las automatizaciones al máximo nivel, Astra y Opus 5.5 siguen por delante, pero cuestan de cuatro a ocho veces más.
Si usas ChatGPT Work, Codex o la API, es el modelo que hay que probar primero. Si solo trabajas en el Chat, tendrás que esperar un poco más.
Preguntas frecuentes
¿Qué es GPT-6.1 Sol?
Es el nuevo modelo de gama media de OpenAI, presentado el 29 de septiembre de 2026. Actualiza GPT-6 Sol y, según OpenAI, se acerca a GPT-6 Astra en programación, uso del ordenador y trabajo profesional, a una quinta parte del precio de Astra.
¿Se llama ChatGPT 6.1 Sol?
No, el nombre oficial es GPT-6.1 Sol. ChatGPT es la aplicación en la que lo usas: el modelo está disponible en ChatGPT Work y en Codex.
¿Cuánto cuesta GPT-6.1 Sol?
En la API cuesta 2 dólares por millón de tokens de entrada, 0,10 por la entrada ya en caché y 10 de salida. En ChatGPT está incluido en las suscripciones Plus, Pro, Business, Enterprise y Edu.
¿GPT-6.1 Sol es mejor que GPT-6 Astra?
No, Astra sigue siendo más capaz en general, sobre todo en investigación científica y en las tareas más difíciles. GPT-6.1 Sol se acerca mucho en programación, documentos y uso del ordenador, costando cerca de una quinta parte.
¿Puedo usar GPT-6.1 Sol en el Chat de ChatGPT?
De momento no. OpenAI lo ha puesto disponible en ChatGPT Work y Codex, y en la API. En el Chat todavía no ha llegado.
Lee también:
GPT-6 Astra y Gemini 3.8 Flash: benchmarks oficiales, precios reales y cuál conviene ·
Gemini 4 Pro en pruebas en Arena bajo el nombre Gemini 3.8 Flash: lo que sabemos de verdad ·
Claude Fable 5.1 y Mythos 5.1: benchmarks, precios y recorte del 75%
Fuentes
- OpenAI, Presentamos GPT-6.1 Sol, 29 de septiembre de 2026: benchmarks, precios y disponibilidad.
- OpenAI, documentación del modelo gpt-6.1-sol: contexto, niveles de razonamiento y tarifa completa.
- OpenAI, documentación del modelo gpt-6-sol: la comparación con la versión anterior.
- OpenAI, actualización de la ficha de seguridad de GPT-6.1 Sol: evaluaciones de seguridad y clasificación de riesgos.
- Artificial Analysis, GPT-6.1 Sol: prueba independiente, coste por tarea y velocidad.
- TechCrunch, 29 de septiembre de 2026: el lanzamiento y la retirada de GPT-6.1 Astra.
- Unite.AI: las otras novedades del DevDay 2026.

7 recursos gratuitos para desarrolladores: API de IA, bases de
7 recursos gratuitos para desarrolladores: API de IA, bases de datos, email y monitorización Por Daniele Forciniti Estos son 7 recursos gratuitos…

Gemini 4 Argon: todas las novedades, precios y benchmarks
Gemini 4 Argon: todas las novedades, precios y benchmarks Por Daniele Forciniti Gemini 4 Argon es el nuevo modelo insignia de Google,…
Gemini 4 Pro en pruebas en Arena bajo el nombre
Gemini 4 Pro en pruebas en Arena bajo el nombre Gemini 3.8 Flash: lo que sabemos de verdad Por Daniele Forciniti Según…
Búsqueda multimodal: ahora Search Console muestra quién te encuentra con
Búsqueda multimodal: ahora Search Console muestra quién te encuentra con una foto Por Daniele Forciniti Desde el 24 de septiembre de 2026…
SEO, AEO, GEO, AIO y SXO: las 5 siglas del
SEO, AEO, GEO, AIO y SXO: las 5 siglas del SEO moderno explicadas de forma sencilla Por Daniele Forciniti SEO, AEO, GEO,…
Claude Opus 5.5, GPT-6 Sol y Luna: precios y benchmarks
Claude Opus 5.5, GPT-6 Sol y Luna: precios y benchmarks comparados Por Daniele Forciniti El 22 de septiembre de 2026 Anthropic publicó…