
TokenEconomizer: qué es y cómo reduce hasta un 31% el coste de Claude Code, Codex y Copilot
Por Daniele Forciniti
TokenEconomizer es un plugin de código abierto de Microsoft Research, Microsoft Security y UC Berkeley que hace gastar menos a los agentes de programación como Claude Code, Codex, GitHub Copilot CLI y Pi. No cambia ni el agente ni el modelo: aprende de las sesiones ya hechas en un proyecto y recorta el desperdicio en las siguientes. En las pruebas del paper con SWE-Bench redujo el coste medio entre un 18,4% y un 30,9%, según la combinación de agente y modelo, y en la mayoría de los casos el agente resolvió incluso algún problema más. Es gratuito, con licencia Apache 2.0, y se instala en pocos minutos.
Por qué está dando que hablar
Quien usa un agente de código a diario lo sabe: la factura sube rápido. Un agente no responde a una pregunta y ya está, trabaja por vueltas. Lee archivos, lanza un comando, mira el error, corrige y vuelve a lanzar. Y en cada vuelta reenvía al modelo todo lo anterior: las instrucciones del sistema, la lista de herramientas disponibles y la conversación hasta ese momento. Cuanto más largo es el trabajo, más veces se paga lo mismo.
El segundo motivo es quién lo firma. No es un truco de un usuario de Reddit, es un trabajo de investigación con once autores, entre ellos Ion Stoica de Berkeley (uno de los fundadores de Databricks) y Jianfeng Gao de Microsoft Research, con un paper público, el código para repetir los experimentos y resultados medidos en cinco combinaciones distintas.
El tercero es el método. Casi todos los trucos para ahorrar tokens valen para un trabajo concreto: comprimir la salida, bajar el razonamiento, cambiar de modelo. TokenEconomizer parte de una idea distinta y muy práctica: los desarrolladores usamos el mismo agente en el mismo proyecto durante semanas, así que el desperdicio se repite, y si se repite se puede aprender. El repositorio en GitHub ha superado las 4.000 estrellas en menos de tres semanas.
Qué es TokenEconomizer
Es un plugin que se añade al agente que ya usas, como una extensión. El nombre completo del proyecto lo explica: «control de costes de caja negra, guiado por la experiencia». Caja negra quiere decir que no toca el modelo, sus pesos ni el código del agente: trabaja solo con lo que el agente ya permite configurar, es decir, las instrucciones iniciales, las herramientas cargadas y los eventos de la sesión. Guiado por la experiencia quiere decir que cada sesión terminada se convierte en un dato del que aprender.
| Característica | TokenEconomizer |
|---|---|
| Quién lo ha hecho | Microsoft Research, Microsoft Security y UC Berkeley |
| Paper | arXiv 2610.22732, publicado el 15 de octubre de 2026 |
| Primera versión | v0.1.0 del 26 de octubre de 2026 |
| Licencia | Apache 2.0, gratuito también para uso comercial |
| Agentes compatibles | Claude Code, Codex, GitHub Copilot CLI, Pi; en pruebas opencode y Cursor Agent |
| Requisitos | Python 3.10 o más reciente, sin clave de API |
| Dónde guarda lo que aprende | en tu ordenador, en la carpeta ~/.tokeneconomizer |
| Ahorro medido | del 18,4% al 30,9% del coste medio en SWE-Bench |
Dos palabras sobre los términos, porque salen a menudo. Los tokens son los trocitos de palabra con los que la IA lee y escribe, y son la unidad con la que se paga. Un agente de código es una IA que trabaja sola sobre el código: abre archivos, los modifica, lanza las pruebas y vuelve a empezar hasta terminar. Si quieres entender mejor cómo funcionan y cuánto pueden costar, tengo una guía completa sobre agentes de IA.
Dónde se desperdician los tokens de un agente
Antes de construir el plugin, los investigadores analizaron 60 tareas hechas por Claude Code con Opus 4.8 en seis proyectos de código abierto muy usados en Python: Django, scikit-learn, SymPy, Sphinx, Matplotlib y xarray. Las tareas salen de SWE-Bench, la prueba más usada para medir si un agente sabe corregir bugs reales sacados de GitHub. Encontraron tres fuentes de desperdicio, y cualquiera que use estas herramientas las reconoce enseguida.
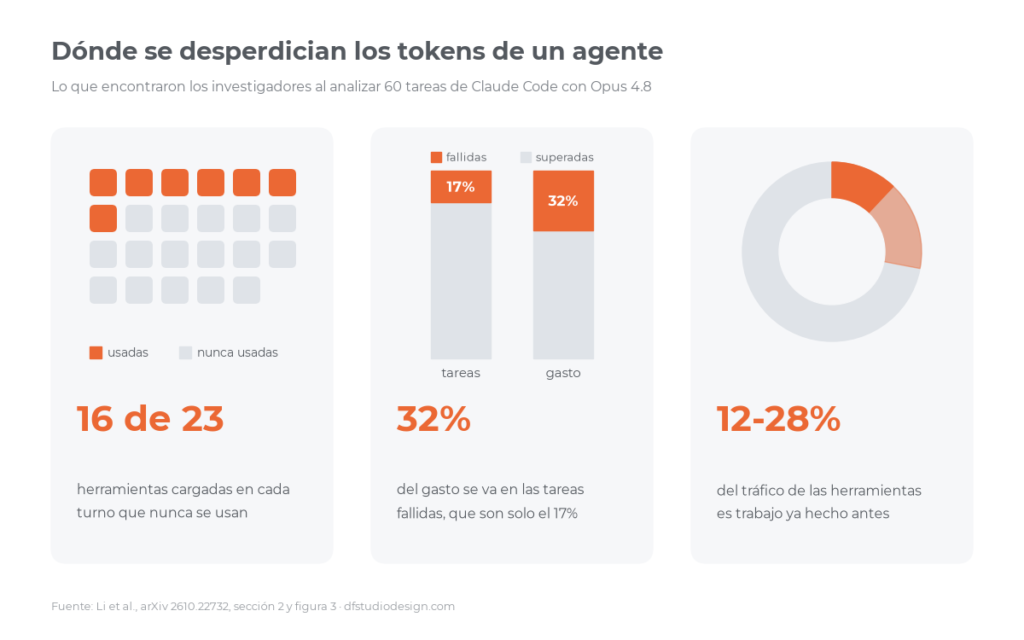
- Herramientas cargadas que nunca se usan. En cada turno el agente recibía la descripción de 23 herramientas, pero ningún proyecto usaba más de 7. Dieciséis no se llamaban nunca, y tres herramientas hacían por sí solas el 98% de las llamadas. El problema es que la descripción de cada herramienta se reenvía en cada petición, sirva o no.
- Tareas fallidas que cuestan el doble. Las tareas que no salían bien eran el 17% del total, pero se comían el 32% del gasto. Cuando un agente se atasca, prueba una y otra vez el mismo camino, y cada intento cuesta.
- Lo mismo descubierto cada vez. Entre el 12% y el 28% del tráfico de las herramientas eran acciones que se repetían en al menos la mitad de las tareas del mismo proyecto: cómo se lanzan las pruebas, qué comando funciona, dónde están ciertos archivos. Cada sesión nueva lo vuelve a descubrir desde cero.
Este tercer punto me suena muchísimo. Uso Claude Code a diario para el trabajo en las webs, y la escena es siempre la misma: en cada sesión nueva el agente empieza de cero y tiene que volver a entender cómo se entra al servidor, qué comando vacía la caché o dónde está un archivo. Para evitarlo me he montado un archivo de notas que el agente lee al empezar. TokenEconomizer intenta hacer lo mismo de forma automática.
Cómo funciona: los tres mecanismos
Cada fuente de desperdicio tiene su mecanismo, y cada uno se puede activar o desactivar por separado. El principio común es que el plugin solo decide con pruebas recogidas en sesiones anteriores, y cualquier acción suya se puede deshacer.
1. Micro-skills: recordar cómo funciona el proyecto
El plugin recoge los datos prácticos que las sesiones vuelven a descubrir una y otra vez: un paso de compilación que hay que hacer antes, el comando correcto para las pruebas en ese proyecto (por ejemplo python -m pytest donde pytest solo no existe), una variable de entorno necesaria, la carpeta donde acaban los archivos generados. Los aprende de dos formas: de los errores que se repiten entre sesiones y de un modelo que cada 3 sesiones relee las últimas y propone datos.
Un dato entra en las instrucciones iniciales solo cuando tres sesiones lo han confirmado, y se quita en cuanto una sesión posterior lo contradice. Son frases de una línea, no documentos largos: añadir demasiado contexto costaría más de lo que ahorra.
2. Tool pruning: dejar de cargar herramientas inútiles
Si una herramienta no se usa en 10 peticiones repartidas en al menos 2 sesiones, o en 5 sesiones de cualquier duración, el plugin la quita de las sesiones siguientes usando los ajustes del propio agente. En Claude Code escribe una lista de exclusiones en el archivo .claude/settings.local.json, que deja fuera de git. Con un comando se recupera todo.
En el paper hay un ejemplo muy claro. En el proyecto Django, Claude Code con Sonnet 5 cargaba 23 herramientas, y la primera petición de cada tarea pesaba unos 43.000 tokens. Desde la segunda tarea el plugin excluyó 19 herramientas que nunca se usaban, y la primera petición bajó a unos 16.000 tokens: más o menos un 62% menos, antes incluso de que el agente empiece a trabajar.
3. Failure-loop intervention: darse cuenta de cuándo el agente da vueltas
Primero el plugin aprende cuánto dura normalmente un turno que sale bien en ese proyecto. Después, cuando un turno empieza a repetir los mismos errores, le pregunta a un modelo «juez» si el agente está realmente atascado. Si el juez está seguro al menos al 70%, el agente recibe una nota breve que le sugiere cambiar de camino. Una sola vez por turno. Si después de la nota sigue atascado, el plugin te avisa y te dice cómo pararlo, pero nunca lo para por su cuenta.
Esta prudencia tiene un motivo concreto. En las pruebas, 36 de las 50 tareas que salieron bien habían repetido el mismo error al menos una vez antes de llegar a la solución. Repetir un error no significa siempre estar atascado, y un control demasiado agresivo habría cortado trabajos que estaban a punto de salir.
| Mecanismo | Qué hace | Activo por defecto | Regla principal |
|---|---|---|---|
| Micro-skills | recuerda los datos del proyecto | no | un dato entra tras 3 confirmaciones y sale con la primera contradicción |
| Tool pruning | quita las herramientas sin usar | sí | 10 peticiones en al menos 2 sesiones, o 5 sesiones |
| Loop guard | interviene en los bucles de errores | sí | juez seguro al menos al 70%, una nota por turno |
Los resultados: cuánto se ahorra de verdad
Los investigadores ejecutaron 277 tareas de SWE-Bench de los seis proyectos, cada una como una sesión aparte y en orden cronológico, empezando sin ninguna experiencia. Cada prueba se repitió tres veces. Los costes se calculan como se facturan de verdad, con los precios de la caché, e incluyen todas las llamadas al modelo que hace el propio plugin.
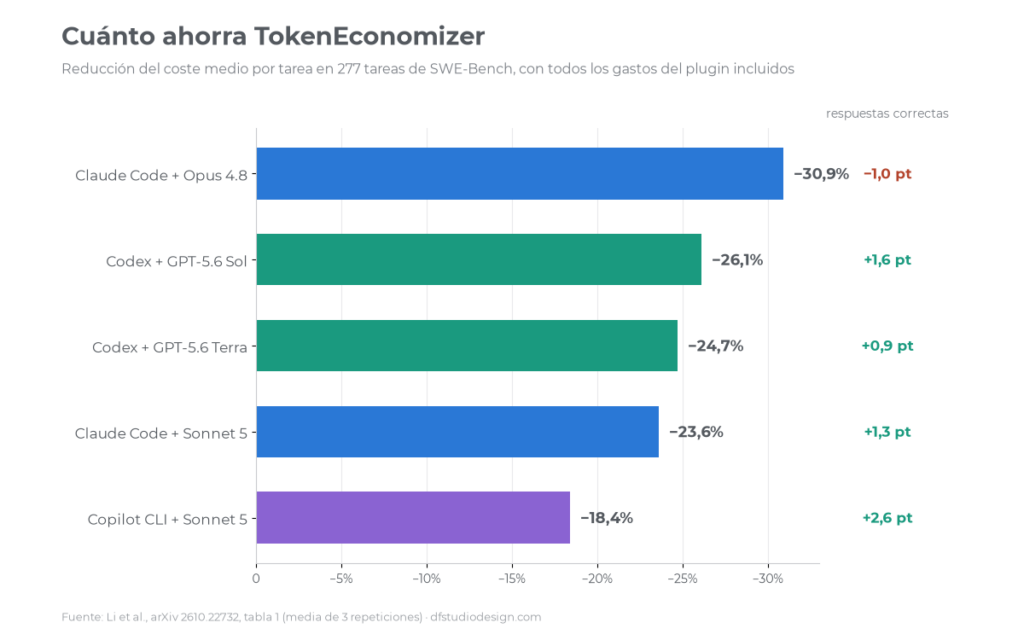
| Agente y modelo | Coste medio | Resueltas sin plugin | Resueltas con el plugin |
|---|---|---|---|
| Claude Code + Sonnet 5 | −23,6% | 74,7% | 76,0% |
| Claude Code + Opus 4.8 | −30,9% | 74,0% | 73,0% |
| Codex + GPT-5.6 Terra | −24,7% | 73,8% | 74,7% |
| Codex + GPT-5.6 Sol | −26,1% | 80,1% | 81,7% |
| Copilot CLI + Sonnet 5 | −18,4% | 75,0% | 77,6% |
La columna de resueltas es el Pass@1, es decir, el porcentaje de bugs corregidos al primer intento. En cuatro casos de cinco sube, y en el único en que baja (Opus 4.8) pierde un punto. Pero el dato que más me llamó la atención es otro: el ahorro aparece en los 30 cruces entre proyecto y combinación, con recortes que van del 5,2% al 40,1%. No hay ni un proyecto en el que el plugin haya hecho gastar más.
El paper mide también cuánto pesa cada mecanismo por separado, en las dos combinaciones con Claude Code:
| Mecanismo por separado | Claude Code + Sonnet 5 | Claude Code + Opus 4.8 |
|---|---|---|
| Micro-skills | −11,8% | −14,3% |
| Tool pruning | −13,2% | −17,7% |
| Loop guard | −7,1% | −5,4% |
| Los tres juntos | −23,6% | −30,9% |
El tool pruning es el que más rinde, porque actúa en cada turno de cada tarea. El loop guard ahorra menos, pero interviene justo en las tareas más caras.
También hay pruebas con trabajos distintos de corregir bugs. En Web-Bench, donde el agente construye un proyecto web paso a paso, el ahorro fue de entre el 16,0% y el 21,2%. En dos pruebas de seguridad donde cada tarea está en un proyecto distinto, y por tanto sin experiencia que reutilizar, el recorte fue de entre el 16,5% y el 19,6% en CredData (búsqueda de credenciales olvidadas en el código) y solo de entre el 6,4% y el 9,3% en ReposVul (búsqueda de vulnerabilidades), donde las sesiones son cortas y hay poco que recortar.
¿Mejor que bajar el razonamiento?
Es la pregunta correcta, porque la forma más fácil de gastar menos con un agente es bajar el nivel de razonamiento del modelo. El paper lo comparó directamente, junto a dos herramientas de código abierto muy usadas: RTK (Rust Token Killer), que comprime la salida de los comandos, y el repo map de Aider, que le pasa al agente un mapa del código.
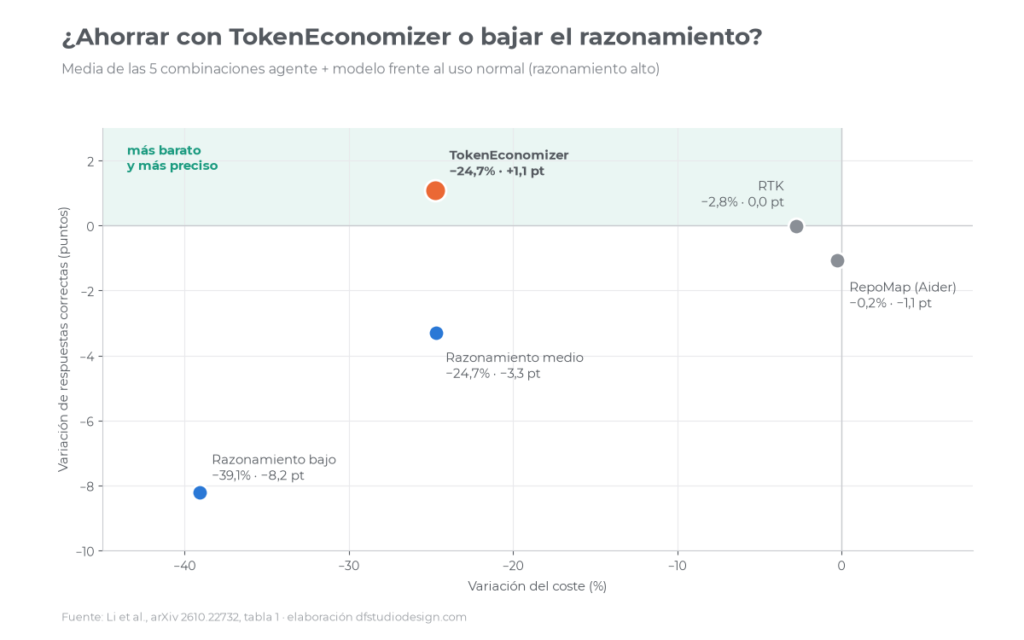
He hecho la media de las cinco combinaciones, y sale un resultado interesante. Pasar del razonamiento alto al medio ahorra de media lo mismo que TokenEconomizer (alrededor del 24,7%), pero pierde 3,3 puntos de bugs resueltos. El razonamiento bajo llega a ahorrar un 39%, pero pierde más de 8 puntos. TokenEconomizer ahorra lo mismo que el razonamiento medio y de media gana uno.
| Método (media de 5 combinaciones) | Coste | Bugs resueltos |
|---|---|---|
| Razonamiento medio | −24,7% | −3,3 puntos |
| Razonamiento bajo | −39,1% | −8,2 puntos |
| RTK | −2,8% | sin cambios |
| RepoMap de Aider | −0,2% | −1,1 puntos |
| TokenEconomizer | −24,7% | +1,1 puntos |
RTK y RepoMap por sí solos ahorran poco y de forma irregular: RTK hizo gastar más en 12 de los 30 cruces, RepoMap en 15. El motivo, según los autores, es que aplican la misma receta en todas partes, mientras que cada proyecto tiene su propio desperdicio. Una tercera herramienta, Serena, se quedó fuera de la comparación final porque en las pruebas iniciales era la única que aumentaba el gasto total. La buena noticia es que los métodos se pueden sumar: en Claude Code con Opus 4.8, TokenEconomizer junto a RTK llevó el ahorro al 33,2%.
Cómo se instala en Claude Code, Codex, Copilot CLI y Pi
Necesitas uno de los agentes compatibles, ya conectado a tu cuenta, y Python 3.10 o más reciente. El plugin no pide claves de API ni toca las credenciales: las pocas llamadas al modelo que hace pasan por tu agente, con la misma suscripción. Para Claude Code, Codex y Copilot CLI se clona el repositorio en una carpeta y se deja ahí, porque el plugin funciona desde esa copia.
Claude Code
git clone https://github.com/microsoft/TokenEconomizer.git
claude plugin marketplace add "$PWD/TokenEconomizer"
claude plugin install tokeneconomizer@tokeneconomizer
Después abres claude, confirmas que confías en la carpeta y lanzas /tokeneconomizer:status. Una vez por ordenador, y otra vez después de cada actualización de Claude Code, hay que lanzar /tokeneconomizer:toolprune refresh-catalog, que registra todas las herramientas disponibles.
Codex
git clone https://github.com/microsoft/TokenEconomizer.git
codex plugin marketplace add "$PWD/TokenEconomizer"
codex plugin add tokeneconomizer@tokeneconomizer
Al arrancar eliges «Trust and continue» y luego «Trust all and continue» para los hooks. Funciona desde la sesión siguiente: sales con /exit, vuelves a abrir y compruebas con $tokeneconomizer:status.
Copilot CLI
git clone https://github.com/microsoft/TokenEconomizer.git
copilot plugin marketplace add "$PWD/TokenEconomizer"
copilot plugin install tokeneconomizer@tokeneconomizerPi: basta con pi install git:github.com/microsoft/TokenEconomizer, y dentro de Pi se comprueba con /te status.
Algo que conviene saber: el plugin solo está probado en versiones concretas de los agentes, y las más nuevas todavía no se han probado.
| Agente | Versiones compatibles | Comando de estado |
|---|---|---|
| Claude Code | de 2.1.300 a 2.1.310 | /tokeneconomizer:status |
| Codex | de 0.153.1 a 0.164.0 | $tokeneconomizer:status |
| Copilot CLI | de 1.0.83 a 1.0.102 | /tokeneconomizer:status |
| Pi | de 1.2.0 a 1.3.0 | /te status |
| opencode (en pruebas) | 1.19.5 y 2.2.0 | desde el terminal |
| Cursor Agent (en pruebas) | 3.24.9, solo macOS y Linux | desde el terminal |
Los comandos del día a día son pocos: status enseña lo que ha aprendido y cuánto cuestan las sesiones, microskills los datos que usa, toolprune las herramientas excluidas, toolprune restore las devuelve y config enseña los ajustes. Para apagarlo todo en una sesión se arranca el agente con TE_DISABLE=1 claude.
El detalle que casi nadie cuenta
En el paper el ahorro del 18,4% al 30,9% se mide con los tres mecanismos activados. Pero si instalas el plugin tal cual, las micro-skills están desactivadas. Los autores lo explican en el README: el modelo que propone los datos hace llamadas extra, y lo que rinden depende del proyecto y del tipo de trabajo.
Así que con los ajustes de serie tienes el tool pruning y el loop guard. Viendo los resultados de cada mecanismo por separado, lo razonable es esperar un ahorro algo más bajo que el del paper. Si quieres el paquete completo, tienes que activar las micro-skills con un comando:
/tokeneconomizer:config set microskills=onHay también un término medio, microskills=envfacts, que aprende datos solo de los errores repetidos, sin ninguna llamada al modelo. Para quien quiera probarlo con prudencia, es el punto de partida que recomendaría.
Límites y cosas que saber antes de usarlo
- Las primeras sesiones cuestan más. El plugin empieza sin experiencia. En las pruebas casi todos los proyectos costaban al principio más de lo normal, y se volvieron más baratos a partir de la sexta tarea. Si abres un proyecto una vez al mes, la ventaja es mínima.
- Los modelos de las pruebas no son los últimos. Los experimentos usan Sonnet 5, Opus 4.8 y GPT-5.6, no los modelos más recientes como Claude Opus 5.5. El principio sigue valiendo, pero las cifras exactas podrían cambiar.
- Pi no está en las pruebas. El plugin es compatible con Pi, pero el paper solo mide Claude Code, Codex y Copilot CLI. Además, en Pi el tool pruning no hace nada, porque Pi ya carga solo cuatro herramientas.
- Las pruebas no son sesiones reales. Los propios autores escriben que las tareas de SWE-Bench son correcciones relacionadas pero independientes, no el trabajo real de una persona. Esperan más ahorro en sesiones continuas, pero está por comprobar.
- Modifica los ajustes del agente. El tool pruning escribe en los archivos de configuración (en Claude Code, en
.claude/settings.local.json). Solo añade sus entradas y no toca las tuyas, pero conviene saberlo. Si trabajas de forma interactiva y usas herramientas como el modo plan solo de vez en cuando, revisa contoolprunequé ha excluido. - En Claude Code sus avisos se ven poco. Los mensajes de los plugins solo aparecen en la transcripción detallada (Ctrl+O), así que el aviso de bloqueo lo repite Claude en la respuesta, y el modelo puede reformularlo u omitirlo.
- En ejecuciones automáticas no te para. Si usas el agente sin nadie delante (por ejemplo
claude -pen un script), un turno atascado sigue hasta los límites del agente: el plugin lo señala, pero no lo interrumpe. - Son cifras de los autores. El código para repetir los experimentos es público en la carpeta
experiments/, pero por ahora no he encontrado verificaciones independientes.
Para quién es útil de verdad
- Quien trabaja mucho tiempo en los mismos proyectos. Es el caso perfecto: cuantas más sesiones haces en el mismo repositorio, más experiencia tiene el plugin para usar.
- Quien paga por uso con la API. Si usas los agentes con una clave de API y pagas por token, un recorte del 20-30% se nota enseguida en la factura.
- Quien tiene suscripción y llega a los límites. Con los planes de cuota fija no se ahorra dinero, pero menos tokens por tarea significa llegar menos veces al límite de uso.
- Los equipos con muchos servidores MCP conectados. Cada servidor añade herramientas, y cada herramienta pesa en cada petición. En Copilot CLI el plugin excluye servidores MCP enteros que nunca se usan.
- Menos útil para quien abre proyectos siempre distintos, hace tareas cortas o usa Pi, donde hay poco que recortar.
Qué opino
Hago webs y posicionamiento desde hace más de una década, y últimamente los agentes de código se han convertido en un compañero más en mi día a día, tanto para el diseño web en WordPress como para todas las tareas repetitivas que antes hacía a mano. El coste de los tokens se ha convertido en un gasto real, como el hosting o las licencias.
TokenEconomizer me convence por una razón sencilla: no promete milagros, mide. Ha cogido tres desperdicios que cualquiera que use estas herramientas ve a diario, los ha contado y ha construido una solución prudente, que solo decide con pruebas y se deshace con un comando. Y la comparación con bajar el razonamiento es la parte más útil del paper: ahorrar bajando la calidad sabemos hacerlo todos, ahorrar sin perderla es otra cosa. Quien ya ha probado alternativas a Claude Code como Muse Code de Meta sabe que el precio por tarea importa tanto como el precio por token.
Todavía no lo he metido en mi trabajo diario, así que estas son las cifras del paper, no las mías. Si lo instalas, mi consejo es este: deja los ajustes de serie una o dos semanas, mira con status cuánto gastas y qué ha excluido, y solo después activa las micro-skills. Y vigila las versiones compatibles, porque Claude Code y Codex se actualizan a menudo.
Conclusión
TokenEconomizer es uno de los proyectos más prácticos que han salido este año sobre el coste de los agentes de programación. No cambia el modelo ni baja la calidad: aprende de las tareas hechas en el mismo proyecto, deja de cargar herramientas inútiles, recuerda lo que el agente volvía a descubrir cada vez e interviene cuando el agente da vueltas. Las cifras del paper son buenas y, sobre todo, constantes: ahorro en los 30 casos medidos. Los límites existen (versiones compatibles muy concretas, micro-skills desactivadas por defecto, ninguna verificación externa por ahora), pero para quien trabaja a diario en los mismos repositorios merece la pena probarlo.
Preguntas frecuentes
¿Qué es TokenEconomizer?
Es un plugin de código abierto de Microsoft Research, Microsoft Security y UC Berkeley que reduce el coste en tokens de los agentes de programación. Aprende de las sesiones ya hechas en un proyecto y recorta el desperdicio en las siguientes, sin modificar el agente ni el modelo.
¿Cuánto ahorra?
En las pruebas del paper con 277 tareas de SWE-Bench redujo el coste medio entre un 18,4% y un 30,9%, según la combinación de agente y modelo. En tareas de desarrollo web el recorte fue de entre el 16% y el 21%, y en pruebas de seguridad de entre el 6% y el 20%.
¿Con qué agentes funciona?
Con Claude Code, Codex, GitHub Copilot CLI y Pi. La compatibilidad con opencode y Cursor Agent todavía está en pruebas. Eso sí, el paper solo mide los resultados en Claude Code, Codex y Copilot CLI.
¿Es gratis?
Sí. Es de código abierto con licencia Apache 2.0 y no pide claves de API. Las pocas llamadas al modelo que hace pasan por tu agente, con tu suscripción, y su coste ya está incluido en el ahorro medido.
¿Empeora la calidad del trabajo del agente?
En las pruebas no: el porcentaje de bugs resueltos subió en cuatro combinaciones de cinco y bajó un punto solo con Opus 4.8. Bajar el nivel de razonamiento, en cambio, ahorra de forma parecida pero pierde de media más de 3 puntos.
¿Qué hace con mis datos?
Todo lo que aprende se queda en tu ordenador, en la carpeta ~/.tokeneconomizer. Los cambios en las herramientas los escribe en los archivos de ajustes locales del agente, fuera de git, y se deshacen con el comando toolprune restore.
¿Funciona nada más instalarlo?
Necesita algunas sesiones para aprender. En las pruebas las primeras tareas costaban algo más de lo normal y el ahorro llegó a partir de la sexta. Además, por defecto solo están activos el tool pruning y el loop guard: las micro-skills hay que activarlas a mano.
Lee también:
Claude Opus 5.5, GPT-6 Sol y Luna: precios y benchmarks comparados ·
Claude Duet: qué es y para qué usarlo ·
7 recursos gratuitos para desarrolladores: API de IA, bases de datos, email y monitorización
Fuentes
- Microsoft, TokenEconomizer en GitHub: README con los mecanismos, la instalación, los ajustes y las versiones compatibles.
- Li et al., TokenEconomizer: Experience-Driven Black-Box Cost Control for Coding Agents, arXiv 2610.22732: el paper con todos los resultados, las comparaciones y los límites.
- Notas de la versión 0.1.0: primera versión pública del 26 de octubre de 2026.
- Página del proyecto: gráficos interactivos y resultados por proyecto.
- ExplainX: análisis de la instalación y las advertencias.
- AI Mastery y AlphaSignal: resumen de la noticia y de los resultados.

Animaciones con scroll en CSS: desde 2026 funcionan en todos
Animaciones con scroll en CSS: desde 2026 funcionan en todos los navegadores, sin JavaScript Por Daniele Forciniti Desde el 27 de octubre…

Kimi K3.1 Pro: novedades, benchmarks y precios del modelo de
Kimi K3.1 Pro: novedades, benchmarks y precios del modelo de pesos abiertos que desafía a Opus 5.5 Por Daniele Forciniti Kimi K3.1…
Google mueve los AI Overviews de las marcas a la
Google mueve los AI Overviews de las marcas a la columna derecha y prueba a quitar el Modo IA: qué…
Core Web Vitals en 2026: qué son LCP, INP y
Core Web Vitals en 2026: qué son LCP, INP y CLS y cómo mejorarlos Por Daniele Forciniti Los Core Web Vitals son…
Title, meta description y snippet en 2026: cómo escribirlos y
Title, meta description y snippet en 2026: cómo escribirlos y por qué Google los cambia Por Daniele Forciniti El title y la…
Gemini 4 Carbon: novedades, benchmarks y precios del modelo más
Gemini 4 Carbon: novedades, benchmarks y precios del modelo más potente de Google Por Daniele Forciniti Gemini 4 Carbon es el nuevo…