
Claude Opus 5.5, GPT-6 Sol y Luna: precios y benchmarks comparados
Por Daniele Forciniti
El 22 de septiembre de 2026 Anthropic publicó Claude Opus 5.5, a 4 dólares por millón de tokens de entrada y 20 de salida, un 20% menos que Opus 5. Ese mismo día OpenAI lanzó GPT-6 Sol (2 y 10 dólares) y GPT-6 Luna (10 y 50 céntimos), a mitad de precio respecto a los GPT-5.6. En el índice independiente de Artificial Analysis Opus 5.5 es primero con 58 puntos, Sol hace 48 y Luna 37.
Hasta aquí es lo que encuentras en todas partes, también en el post que circula por redes con los tres precios uno al lado del otro. Lo que falta es la parte que importa a quien paga la factura: el precio por token no es el coste por tarea. Un modelo más barato por token puede salir más caro al final del trabajo si para llegar consume cuatro veces más. En este artículo pongo en orden los precios reales, los benchmarks oficiales, los independientes y el coste real por tarea, y al final te digo cuál usar y cuándo.
Por qué este doble lanzamiento importa
Dos empresas que lanzan el mismo día, casi a la misma hora, no es casualidad de calendario: es una guerra de precios declarada. Durante años el mejor modelo fue también el más caro, y quien quería ahorrar aceptaba uno más flojo. Ahora las dos opciones se están acercando.
La señal más clara es que Opus 5.5 supera en muchas pruebas a Claude Fable 5.1, el modelo tope de gama de Anthropic, que cuesta 10 y 50 dólares, es decir, dos veces y media más. Al otro lado, OpenAI ha llevado a Sol y Luna los mismos métodos de entrenamiento de GPT-6 Astra, su modelo más capaz, que sigue en 10 y 50 dólares. En la práctica, las dos empresas están bajando de precio la inteligencia que antes se pagaba a tarifa completa.
Para quien usa inteligencia artificial en el trabajo, un token es más o menos tres cuartos de palabra: es la unidad con la que te facturan tanto lo que envías al modelo (entrada) como lo que te responde (salida). La salida siempre cuesta más, y es justo ahí donde se esconde la diferencia entre modelos.
Los precios, uno al lado del otro
He sacado las tarifas directamente de las páginas oficiales de Anthropic y de OpenAI. Precios en dólares por millón de tokens.
| Modelo | Entrada | Salida | Lectura de caché | Antes costaba | Rebaja |
|---|---|---|---|---|---|
| Claude Opus 5.5 | $4 | $20 | $0,20 | $5 / $25 (Opus 5) | 20% por token, 60% en caché |
| GPT-6 Sol | $2 | $10 | $0,20 | $4 / $20 (GPT-5.6 Sol) | 50% |
| GPT-6 Luna | $0,10 | $0,50 | $0,01 | $0,20 / $1,20 (GPT-5.6 Luna) | 50% en entrada, 58% en salida |
| GPT-6 Astra | $10 | $50 | $1 | sin cambios | ninguna |
| Claude Fable 5.1 | $10 | $50 | n/d | sin cambios | ninguna |
Tres matices que el post viral no hace. El primero: el «50% más barato» vale para OpenAI, no para Anthropic. Opus 5.5 cuesta un 20% menos por token, y Anthropic habla de un 40% de ahorro en cargas de trabajo típicas porque el modelo usa menos cálculo y menos tokens para la misma tarea con los ajustes predeterminados. El segundo: OpenAI calcula su 50% respecto al precio promocional de los GPT-5.6, no respecto a la tarifa completa. El tercero: en Luna el recorte en salida es del 58%, más de lo que dice el titular.
En la caché las dos empresas han llegado más o menos al mismo punto. OpenAI aplica un descuento del 90% sobre los tokens ya leídos y ha mejorado el reconocimiento automático de las partes reutilizables. Anthropic ha bajado la lectura de caché de Opus 5.5 de 50 a 20 céntimos. Para quien construye agentes que releen el mismo contexto cien veces, es la partida que más pesa en la factura.
Claude Opus 5.5: qué cambia de verdad
Además del precio, según Anthropic Opus 5.5 genera texto más de un 30% más rápido que Opus 5. Hay también un modo rápido hasta dos veces y media más veloz, que cuesta el doble: 8 dólares de entrada y 40 de salida. El modelo está disponible en las apps de Claude, en la API con el nombre claude-opus-5-5 y en las tres grandes nubes, AWS, Google Cloud y Microsoft Azure, desde el primer día. Quien tiene suscripción Pro, Max, Team o Enterprise tiene además límites más altos en las ventanas de cinco horas, que eran el punto débil de Opus 5.
Estas son las cifras principales de la tabla oficial. Ojo: Anthropic compara Opus 5.5 con GPT-6 Astra y con GPT-5.6 Sol, no con el nuevo Sol, porque salió el mismo día.
| Benchmark | Opus 5.5 | Opus 5 | Fable 5.1 | GPT-6 Astra |
|---|---|---|---|---|
| Terminal-Bench 4.0 (trabajo en terminal) | 66,4% | 52,3% | 55,8% | 57,9% |
| FrontierCode 1.1 (código listo para fusionar) | 54,4% | 48,0% | 50,3% | 53,3% |
| GDPval-AA 2.1 (trabajo de oficina, Elo) | 1.846 | 1.708 | 1.735 | 1.542 |
| AutomationBench (flujos de empresa) | 40,0% | 26,9% | 31,4% | 41,4% |
| Humanity’s Last Exam (con herramientas) | 67,7% | 63,6% | 65,6% | 57,2% |
| Terminal-Bench-Science 0.1 | 58,7% | 29,0% | 52,6% | 64,6% |
El salto más grande está en el trabajo en terminal, es decir, los agentes que escriben código, lanzan comandos y se corrigen solos: 14 puntos más que Opus 5. Astra sigue delante en los flujos de empresa automatizados y en la parte científica, aunque por poco en AutomationBench. Anthropic cita también a un tester que completó una migración de código de 680.000 líneas en menos de un día, un trabajo que a un equipo le habría llevado semanas: es un caso único contado por la empresa, para tomarlo como anécdota y no como media.
En seguridad, Opus 5.5 desvía la mayoría de las peticiones de ciberseguridad ofensiva al antiguo Opus 4.8, salvo para quien entra en el programa de verificación correspondiente. Es una decisión que a algún desarrollador le molestará y que conviene conocer antes de migrar.
GPT-6 Sol y GPT-6 Luna: qué cambia de verdad
Sol y Luna completan la familia GPT-6 por debajo de Astra, que sigue siendo el modelo tope de OpenAI. Sol está pensado para código complejo y agentes, Luna para tareas concretas que hay que ejecutar en grandes volúmenes al mínimo coste. En la evaluación interna de OpenAI sobre exactitud de los datos, Sol comete más o menos la mitad de errores que su predecesor.
Las cifras más interesantes del comunicado son las del coste por tarea. En AutomationBench, Sol al nivel de razonamiento más alto saca un 33,2% gastando 27 céntimos por tarea, mientras que Claude Opus 5 al máximo saca un 26,9% costando 11 veces más. En DeepSWE, una prueba de ingeniería de software sobre bases de código reales, Sol llega al 68,8% y Luna al 66,6%, con Luna costando un 93% menos que Opus 5 por tarea. En OSWorld 2.0, el uso del ordenador como lo haría una persona, Sol empata con Opus 5 (60,5% frente a 60,3%) a cerca de una quinta parte del coste.
Aquí también está el truco del espejo: OpenAI se mide con Opus 5 y Fable 5.1, no con Opus 5.5. Ninguna de las dos empresas, en sus gráficos, se compara con el modelo que la otra sacó ese día.
Sobre la disponibilidad: Sol y Luna están en ChatGPT Work y en Codex para los suscriptores Plus, Pro, Business, Enterprise y Edu. Los usuarios gratuitos y Go pueden usar Luna solo desde la app de escritorio. En el chat clásico todavía no están. En la API se llaman gpt-6-sol y gpt-6-luna.
La comparativa independiente: precio por token frente a coste por tarea
Como cada empresa se compara con el modelo antiguo de la otra, la única comparativa directa y actualizada es la de Artificial Analysis, que pasa la misma batería de pruebas a todos los modelos y publica además cuánto ha costado hacerlo. Y aquí el panorama cambia.
| Modelo (nivel de razonamiento) | Puntuación | Coste medio por tarea | Tokens de salida en todo el índice |
|---|---|---|---|
| Claude Opus 5.5 (max) | 58 | $5,98 | 260 millones |
| GPT-6 Astra (max) | 53 | $3,26 | 60 millones |
| Claude Opus 5.5 (medium) | 51 | $1,34 | 38 millones |
| GPT-6 Sol (max) | 48 | $1,06 | 77 millones |
| GPT-6 Luna (max) | 37 | $0,07 | 150 millones |
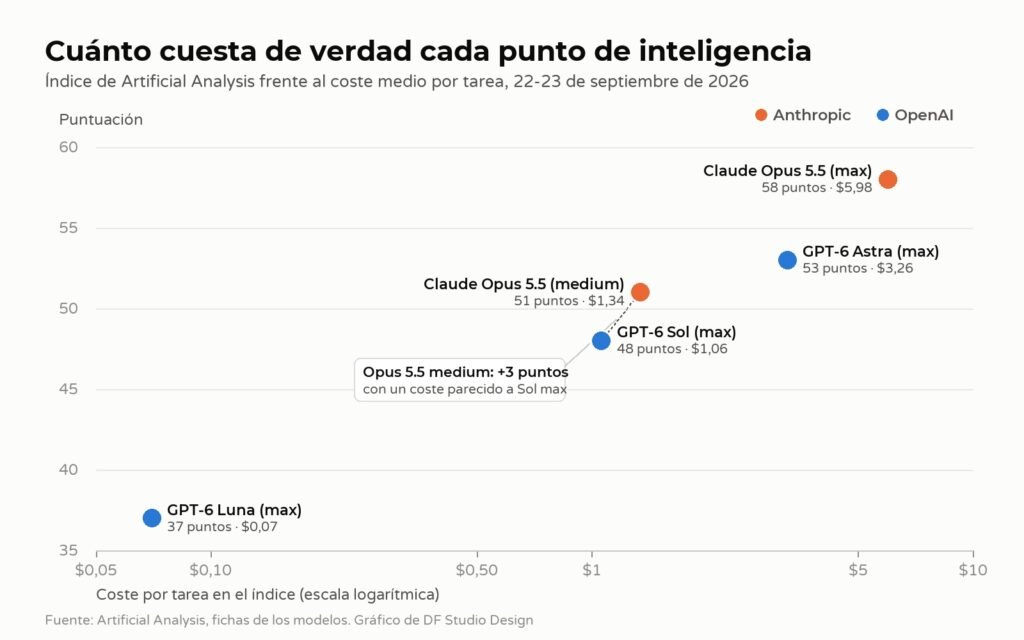
Tres lecturas, por orden de importancia.
Opus 5.5 al máximo es el más inteligente, pero también el más caro, más que Astra. Cuesta menos que Astra por token (20 dólares de salida frente a 50) y, aun así, para completar el índice ha gastado casi el doble por tarea, porque ha producido 260 millones de tokens frente a 60. Razona mucho, a veces demasiado. Simon Willison, uno de los desarrolladores más seguidos en este tema, probó Opus 5.5 al máximo en su test favorito, dibujar un pelícano en bicicleta en SVG: el modelo consumió todo el tope de 128.000 tokens de salida sin terminar el dibujo, dos veces, a 2,56 dólares y veinte minutos por intento.
Opus 5.5 en nivel medio es la sorpresa. Hace 51 puntos gastando 1,34 dólares por tarea y usando apenas 38 millones de tokens, menos que nadie en la tabla. Sol al máximo hace 48 a 1,06 dólares. Tres puntos más por un 26% más de gasto, aproximadamente: si el trabajo es difícil, merece la pena.
Luna juega en otra liga. Siete céntimos por tarea, quince veces menos que Sol, con una puntuación que hace dos años habría sido de modelo tope. Para extraer datos, clasificar, resumir o hacer de primer filtro en un agente, es difícil encontrar algo mejor a ese precio.
Un detalle menos agradable para OpenAI llega de The Decoder: en el índice Sol sube solo un punto respecto a GPT-5.6 Sol (de 47 a 48) y Luna se queda en 37. En el trabajo de oficina medido por GDPval-AA, Sol pierde unos 100 puntos Elo y Luna unos 75, por respuestas peor presentadas y a medias. Dicho de otra forma, lo grueso de la novedad de Sol y Luna es el precio, no la inteligencia.
Claude Opus 5.5 o GPT-6 Sol: cuál elegir
La elección correcta depende del tipo de trabajo y, casi más todavía, del nivel de razonamiento que configures. Te lo divido por casos prácticos.
- Agentes de programación en proyectos largos, refactorizaciones, migraciones: Opus 5.5 en nivel medio o alto. Es donde tiene la ventaja más clara, y en esos niveles no desperdicia tokens.
- Agentes con presupuesto ajustado, muchos pasos, automatizaciones de empresa: Sol. El coste por tarea se mantiene bajo incluso al máximo, y es rápido: más de 130 tokens por segundo según Artificial Analysis.
- Grandes volúmenes de tareas sencillas: Luna. Clasificaciones, extracción de datos de documentos, etiquetas, primeros borradores, filtro antes de pasar la tarea a un modelo más potente.
- El mejor resultado posible, sin mirar la factura: Opus 5.5 al máximo o Astra. Pero con Opus al máximo pon siempre un tope a los tokens de salida, o te arriesgas al pelícano de Willison.
- Trabajo de oficina, documentos y presentaciones: Opus 5.5, que lidera GDPval-AA con 1.846 Elo, mientras que Sol y Luna han retrocedido en esa prueba.
El consejo práctico que vale para todos: antes de migrar, prueba los modelos con tus tareas reales, diez o veinte ejemplos típicos, y mira el coste en la factura, no en la tarifa. Expliqué cómo montar este tipo de comparación en estás pagando la IA diez veces de más, y las cifras de esta semana lo confirman: el modelo más barato por token no es automáticamente el que te hace gastar menos.
Qué cambia para quien tiene una empresa o una web
Para una pequeña empresa estos precios hacen sostenibles cosas que hace un año eran un lujo: un asistente que responde a los clientes en la web, la generación de fichas de producto, la lectura automática de presupuestos y facturas. Con Luna a 50 céntimos por millón de tokens de salida, un chatbot que gestiona miles de conversaciones al mes cuesta menos que un café al día.
Hay además un efecto menos visible pero más importante para quien vive de los clientes que llegan por internet. Cuanto menos cuestan los modelos, más respuestas generadas por inteligencia artificial acaban en todas partes: en los buscadores, en los asistentes, en las apps. Ser la fuente que citan estos modelos pasa a formar parte del posicionamiento, y es el trabajo que hago en la consultoría SEO, donde ya incluyo la parte de GEO. Si en cambio tu web está en WordPress y quieres conectarle un asistente o una automatización, todo empieza por una web bien hecha, como las que hago en el diseño web con WordPress.
Qué pienso yo
Llevo más de diez años trabajando con webs, SEO y contenidos, y en los dos últimos uso estos modelos cada día, para escribir código y para trabajar los textos. La lección de esta semana para mí es una: el nivel de razonamiento cuenta tanto como el modelo. Opus 5.5 al máximo y Opus 5.5 en nivel medio son casi dos productos distintos, con un coste que cambia cuatro veces y media por siete puntos de diferencia.
En el lado de OpenAI valoro la decisión de bajar los precios de forma clara, pero leo con cautela los gráficos del comunicado: compararse con el modelo antiguo del competidor el día en que sale uno nuevo es marketing, no medición. Lo mismo vale para Anthropic. Quien decide según los gráficos de las empresas, esta semana, decide con datos ya superados.
El post que circula por redes pregunta «¿con cuál te quedas?». La respuesta honesta es que no tienes por qué quedarte con uno solo. Para el trabajo difícil uso un modelo potente en nivel medio, para las tareas repetitivas uno pequeño, y cambio cuando cambian los precios. Es justo lo que esta guerra de precios te permite hacer.
Conclusión
Opus 5.5 es hoy el modelo más capaz del índice independiente y cuesta un 20% menos que Opus 5, pero con el razonamiento al máximo consume tantos tokens que sale más caro que GPT-6 Astra por tarea. En nivel medio, en cambio, es el mejor equilibrio entre calidad y gasto de la semana. Sol reduce a la mitad el precio de GPT-5.6 Sol sin un salto real de inteligencia, y sigue siendo la opción más conveniente para agentes con presupuesto. Luna es el modelo de volumen, a siete céntimos por tarea.
La cifra que hay que mirar no es el precio por millón de tokens, es cuánto gastas para terminar tu tarea. Y eso solo lo descubres probando.
Preguntas frecuentes
¿Cuánto cuesta Claude Opus 5.5?
4 dólares por millón de tokens de entrada y 20 de salida, con la lectura de caché a 20 céntimos. El modo rápido cuesta 8 y 40 dólares. Frente a Opus 5 es un 20% menos por token y un 60% menos en caché.
¿Es verdad que todos son un 50% más baratos?
No. El 50% vale para GPT-6 Sol y Luna respecto al precio promocional de los GPT-5.6. Opus 5.5 cuesta un 20% menos por token que Opus 5, y Anthropic estima un ahorro del 40% en cargas de trabajo típicas porque usa menos tokens.
¿Cuál es el más inteligente de los tres?
Claude Opus 5.5, con 58 puntos en el índice de Artificial Analysis, primero en absoluto. GPT-6 Sol hace 48 y GPT-6 Luna 37. Como referencia, GPT-6 Astra y Claude Fable 5.1 están en 53.
¿Cuál sale más barato de verdad?
GPT-6 Luna, a 7 céntimos de media por tarea en el índice. Entre los modelos de gama alta, Opus 5.5 en nivel medio cuesta 1,34 dólares por tarea y Sol al máximo 1,06, mientras que Opus 5.5 al máximo llega a 5,98 dólares.
¿Puedo usar GPT-6 Sol en el chat de ChatGPT?
Todavía no. En el lanzamiento Sol y Luna están en ChatGPT Work y Codex para suscriptores Plus, Pro, Business, Enterprise y Edu, y Luna también en la app de escritorio para usuarios gratuitos y Go. En la API están disponibles desde el primer día.
¿Conviene pasar de Opus 5 a Opus 5.5?
En la mayoría de los casos sí: cuesta menos, es más rápido y rinde mejor en casi todas las pruebas. Revisa eso sí el nivel de razonamiento que usas, porque al máximo Opus 5.5 produce muchos más tokens que Opus 5 y el ahorro puede desaparecer.
¿Por qué los gráficos de las dos empresas no se comparan entre sí?
Porque los modelos salieron el mismo día: Anthropic se compara con GPT-6 Astra y GPT-5.6 Sol, OpenAI con Opus 5 y Fable 5.1. La comparación directa entre los modelos nuevos, por ahora, solo está en las pruebas independientes como las de Artificial Analysis.
Lee también:
Estás pagando la IA 10 veces de más: los 3 modelos que uso yo ·
ChatGPT 6 Astra: novedades, precios y benchmarks oficiales ·
GPT-6 Astra y Gemini 3.8 Flash, comparados
Fuentes
- Anthropic, 22 de septiembre de 2026: el anuncio de Claude Opus 5.5 con precios y benchmarks oficiales.
- Tarifas de la Claude Platform: precios por token, caché y modo rápido.
- OpenAI, 22 de septiembre de 2026: el anuncio de GPT-6 Sol y Luna con precios, benchmarks y disponibilidad.
- Artificial Analysis: el índice independiente, con las fichas de GPT-6 Sol, GPT-6 Luna y GPT-6 Astra.
- The Decoder: los avances y retrocesos de Sol y Luna frente a los GPT-5.6.
- Simon Willison, 22 de septiembre de 2026: la prueba práctica de los tres modelos y el consumo de tokens de Opus 5.5 al máximo.

7 recursos gratuitos para desarrolladores: API de IA, bases de
7 recursos gratuitos para desarrolladores: API de IA, bases de datos, email y monitorización Por Daniele Forciniti Estos son 7 recursos gratuitos…

Gemini 4 Argon: todas las novedades, precios y benchmarks
Gemini 4 Argon: todas las novedades, precios y benchmarks Por Daniele Forciniti Gemini 4 Argon es el nuevo modelo insignia de Google,…
GPT-6.1 Sol: novedades, benchmarks y precios
GPT-6.1 Sol: novedades, benchmarks y precios Por Daniele Forciniti GPT-6.1 Sol es el nuevo modelo de OpenAI presentado ayer, 29 de septiembre…
Gemini 4 Pro en pruebas en Arena bajo el nombre
Gemini 4 Pro en pruebas en Arena bajo el nombre Gemini 3.8 Flash: lo que sabemos de verdad Por Daniele Forciniti Según…
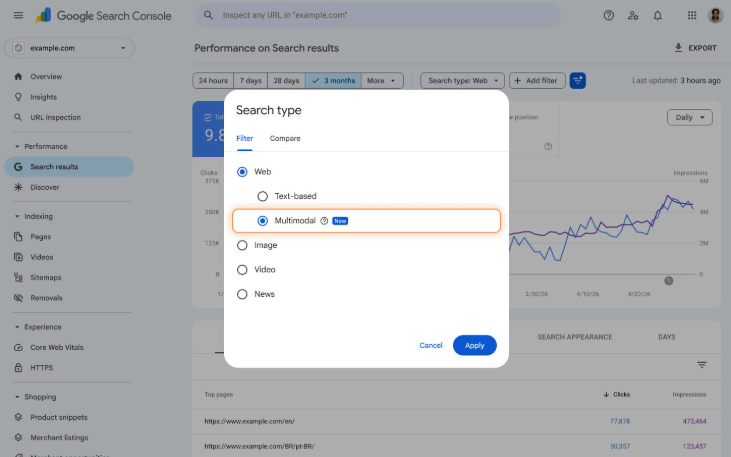
Búsqueda multimodal: ahora Search Console muestra quién te encuentra con
Búsqueda multimodal: ahora Search Console muestra quién te encuentra con una foto Por Daniele Forciniti Desde el 24 de septiembre de 2026…
SEO, AEO, GEO, AIO y SXO: las 5 siglas del
SEO, AEO, GEO, AIO y SXO: las 5 siglas del SEO moderno explicadas de forma sencilla Por Daniele Forciniti SEO, AEO, GEO,…