
Gemini 4 Carbon: novedades, benchmarks y precios del modelo más potente de Google
Por Daniele Forciniti
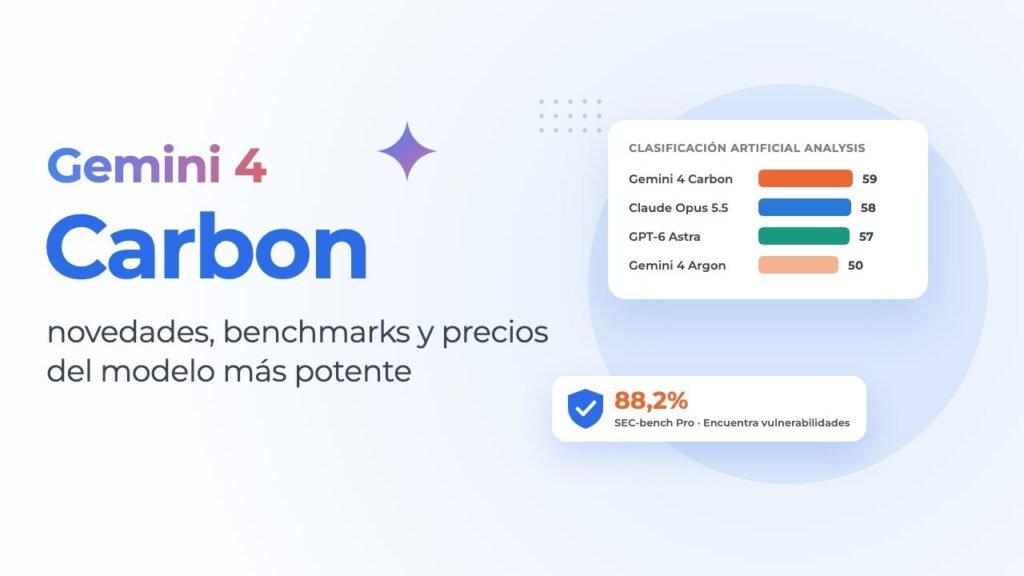
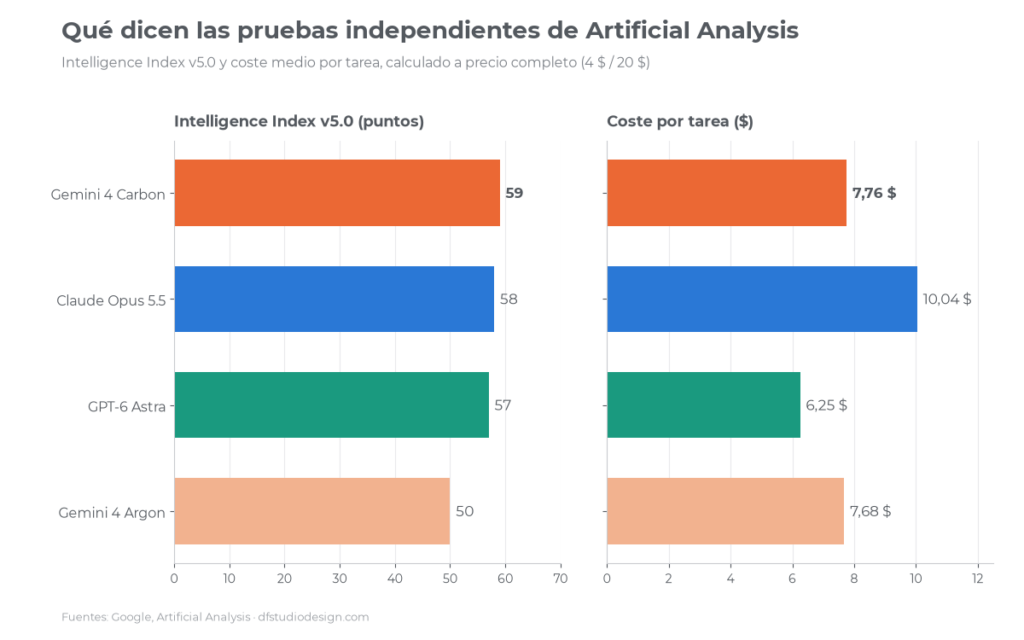
Gemini 4 Carbon es el nuevo modelo insignia de Google DeepMind, anunciado el 28 de octubre de 2026, solo dos semanas después de que Gemini 4 Argon llegara a todo el mundo. Google lo presenta como su modelo más potente, pensado para trabajos largos con agentes y para la ciberseguridad. En las pruebas independientes de Artificial Analysis es hoy el número uno, con 59 puntos frente a los 58 de Claude Opus 5.5 y los 57 de GPT-6 Astra. Por ahora solo lo pueden usar algunos ciberdefensores elegidos por Google; para desarrolladores, empresas y usuarios todavía no hay fecha. El precio de lanzamiento en la API será de 2 dólares por millón de tokens de entrada y 10 de salida, igual que Argon.
Por qué esta noticia es importante
El primer motivo es el calendario. Google presentó Gemini 4 Argon el 30 de septiembre y lo abrió a todos el 13 de octubre. El 28 de octubre llegó Carbon, sin ningún anuncio previo, más allá de algún rumor en Arena los días anteriores. Dos modelos insignia en el mismo mes es un ritmo rapidísimo, incluso para Google.
El segundo motivo es la clasificación. Durante casi un año los modelos de gama alta de Google se quedaron un paso por detrás de los de OpenAI y Anthropic. Con Argon, Google volvió al grupo de los tres primeros; con Carbon se pone por delante de todos en el índice más seguido del sector. El margen es pequeño (un punto sobre Opus 5.5 y dos sobre GPT-6 Astra), pero ahora en lo más alto del índice de Artificial Analysis hay un Gemini.
El tercer motivo es cómo sale. Carbon es tan bueno encontrando y explotando fallos en el software que Google ha decidido darlo primero a quienes defienden redes e infraestructuras, y solo después al resto. Es una señal clara de hacia dónde va la IA: los modelos más potentes ya no llegan directamente a la app, primero pasan por los controles.
Qué es Gemini 4 Carbon
Carbon es un modelo «de frontera», es decir, de la gama más alta, construido a partir de Argon. En el anuncio oficial, firmado por Koray Kavukcuoglu, arquitecto jefe de IA de Google, los puntos fuertes son tres: programación, trabajos con agentes que duran mucho tiempo y ciberseguridad. Google cuenta que sus equipos internos lo han visto trabajar durante días en un mismo problema, siguiendo adelante incluso tras los callejones sin salida, hasta encontrar y corregir el origen de errores escondidos en proyectos de código enormes.
Esta es la ficha con los datos que se conocen hoy:
| Característica | Gemini 4 Carbon |
|---|---|
| Anuncio | 28 de octubre de 2026 |
| Desarrollado por | Google DeepMind, a partir de Gemini 4 Argon |
| Puntos fuertes declarados | ciberseguridad, programación, trabajos largos con agentes, ciencia, desarrollo web, comprensión de imágenes y documentos |
| Memoria de trabajo (contexto) | 1 millón de tokens, según Artificial Analysis |
| Velocidad medida | unos 100 tokens por segundo, pero casi 100 segundos antes de empezar a responder |
| Precio de lanzamiento | 2 $ de entrada y 10 $ de salida por millón de tokens |
| Precio completo | 4 $ de entrada y 20 $ de salida, tras el periodo de lanzamiento |
| Texto ya en caché | descuento del 95% sobre el precio de entrada |
| Quién puede usarlo | por ahora solo un grupo de ciberdefensores, después los socios de Fairwind |
| Lo que no se sabe | parámetros, arquitectura, fecha de llegada a la app Gemini y a la API |
Google no ha publicado un informe técnico con la arquitectura ni el número de parámetros. Sí ha publicado un documento de evaluación de cinco páginas con la tabla completa de benchmarks y la forma en que se hicieron las pruebas. Todos los números de este artículo los he sacado de ahí y los he comparado con las pruebas independientes.
Dos palabras sobre los términos. Los tokens son los trocitos de palabra con los que la IA lee y escribe: un millón de tokens son más o menos 1.500 páginas de texto. Un agente es una IA que no se limita a responder, sino que trabaja sola en varios pasos: abre archivos, escribe código, lo prueba, lo corrige y vuelve a empezar, hasta terminar el trabajo.
Quién puede usarlo hoy (y quién no)
Hoy Carbon no está en la app Gemini, ni en el Modo IA del buscador, ni en la API pública. Google ha anunciado un calendario por etapas, sin fechas concretas:
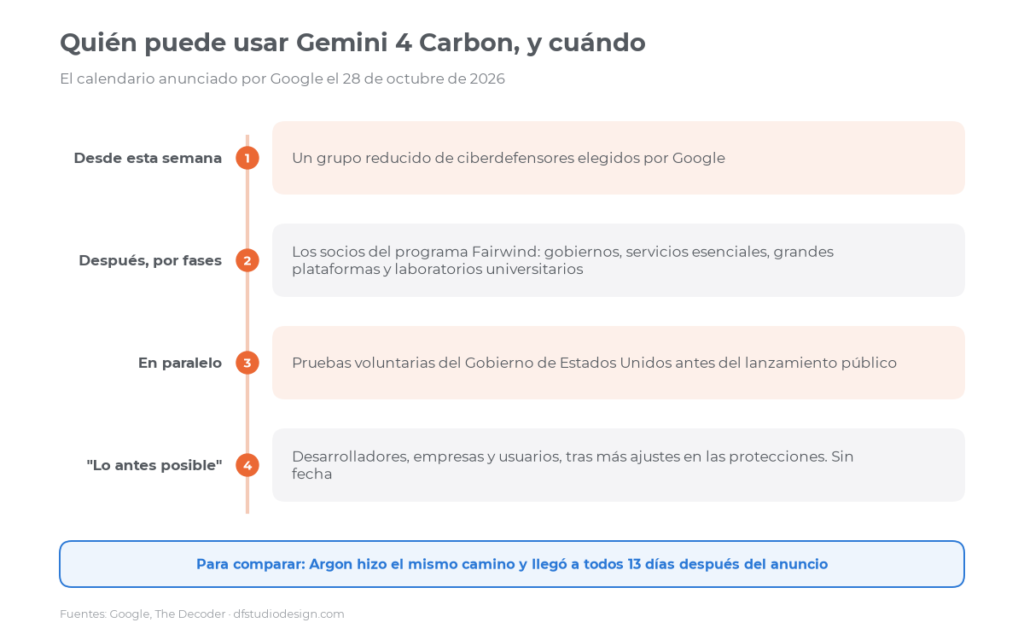
- Desde esta semana: un grupo reducido de ciberdefensores.
- Después, por fases: los socios del programa Fairwind, el canal con el que Google DeepMind da acceso anticipado a sus modelos a quienes protegen redes y servicios. En su página oficial Google habla de más de 650 socios: gobiernos y agencias nacionales de ciberseguridad, quienes gestionan servicios esenciales (sanidad, telecomunicaciones, energía, banca), las grandes plataformas tecnológicas y los laboratorios universitarios que estudian la defensa.
- En paralelo: Google participa en el proceso voluntario del Gobierno de Estados Unidos, que prueba los modelos antes del lanzamiento público.
- Lo antes posible: desarrolladores, empresas y usuarios, después de recoger más opiniones y ajustar las protecciones.
Las reglas de Fairwind son estrictas. Google revisa el historial de quien lo solicita y solo permite usos «dobles» con fines de defensa o investigación: simular ataques autorizados, analizar un virus, desmontar un programa para entender cómo funciona. Crear malware está prohibido. Los socios pueden usar el modelo solo o dentro de CodeMender, el agente de Google que encuentra y corrige fallos en el código.
Un precedente ayuda a hacer previsiones: Argon hizo el mismo camino y llegó a todos 13 días después del anuncio. No está claro que con Carbon vaya a pasar lo mismo, porque Google lo describe como mucho más fuerte justo en la parte delicada, la de los ataques informáticos.
¿Y Arena?
En X varios usuarios dicen que ya lo han probado en Arena, la web donde se comparan dos modelos a ciegas y se vota la mejor respuesta. Según TestingCatalog, antes del lanzamiento una versión de prueba llamada Carbon apareció justo ahí, de forma anónima, y quienes se la encontraron elogiaron sus resultados en 3D, aunque les pareció muy lenta. Ya lo conté cuando un modelo misterioso de Google apareció en Arena con otro nombre: en Arena no eliges tú el modelo, te toca. Así que hoy no hay forma de usarlo cuando quieras.
Yo tampoco he podido probarlo. He hecho lo mismo que con Argon: he cogido la tabla oficial de Google, la he puesto al lado de las pruebas independientes de Artificial Analysis, Vals AI y Arena, y he rehecho las cuentas de los costes. Lo que viene a continuación es el resultado.
Todos los benchmarks oficiales, también donde pierde
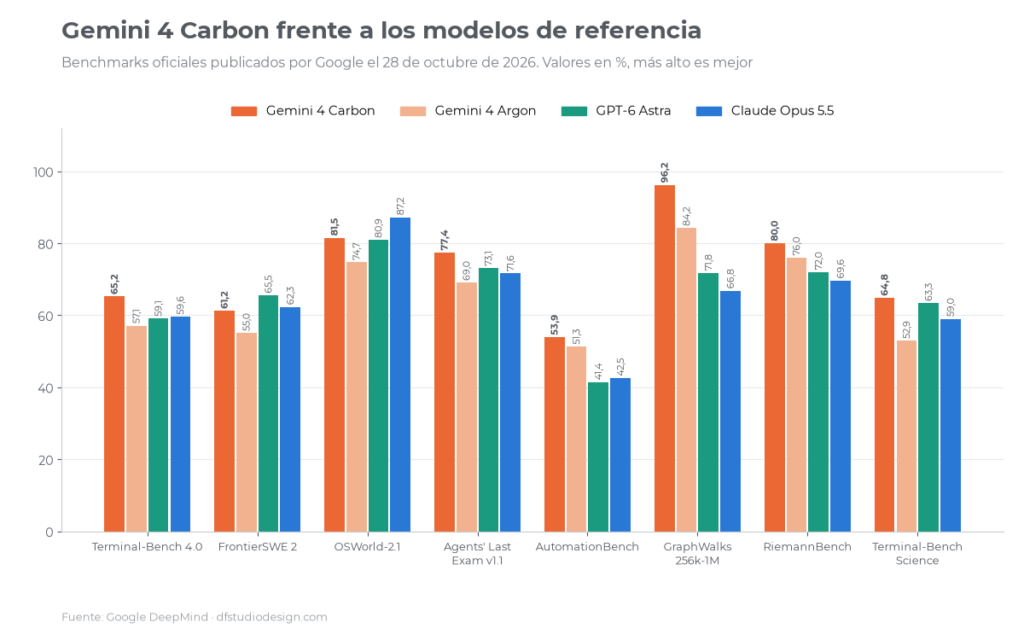
Google ha comparado Carbon con Argon, Claude Opus 5.5, GPT-6 Astra y Claude Fable 5.1 en 17 pruebas. Carbon es el primero en 15. Los números de los demás modelos son los que declaran sus propias empresas; los de Carbon y Argon los ha calculado Google. Esta es la tabla completa del documento de evaluación:
| Benchmark | Carbon | Argon | GPT-6 Astra | Opus 5.5 | Fable 5.1 |
|---|---|---|---|---|---|
| Artificial Analysis Index v5.0 | 59 | 50 | 57 | 58 | 49 |
| Vals Index v2.2 | 70,4% | 69,2% | 65,0% | 70,2% | s.d. |
| SWE-sweep | 9,6% | 4,3% | 9,5% | 3,6% | 2,9% |
| FrontierSWE 2 | 61,2% | 55,0% | 65,5% | 62,3% | 56,3% |
| Terminal-Bench 4.0 | 65,2% | 57,1% | 59,1% | 59,6% | 52,0% |
| Agents’ Last Exam v1.1 | 77,4% | 69,0% | 73,1% | 71,6% | s.d. |
| OSWorld-2.1 (offline) | 81,5% | 74,7% | 80,9% | 87,2% | 76,8% |
| AutomationBench (Zapier) | 53,9% | 51,3% | 41,4% | 42,5% | 31,4% |
| Vending-Bench 2 (saldo final) | 16.484 $ | 13.718 $ | 15.515 $ | 9.235 $ | 5.422 $ |
| Chartography | 72,5% | 71,6% | 71,0% | 66,3% | 46,2% |
| Blueprint-Bench 2 | 58,6% | 54,4% | 49,7% | 51,2% | 41,9% |
| GraphWalks (de 256k a 1M tokens) | 96,2% | 84,2% | 71,8% | 66,8% | 65,0% |
| RiemannBench | 80,0% | 76,0% | 72,0% | 69,6% | 65,6% |
| Terminal-Bench Science 0.1 | 64,8% | 52,9% | 63,3% | 59,0% | 43,3% |
| CWE-bench | 71,0% | 68,0% | 68,0% | 67,0% | 58,0% |
| ExploitGym | 54,8% | 42,0% | 42,4% | 34,5% | s.d. |
| SEC-bench Pro | 88,2% | 83,4% | 85,4% | s.d. | s.d. |
Qué miden estas pruebas, en palabras sencillas
- SWE-sweep, FrontierSWE 2 y Terminal-Bench 4.0: programación real. El modelo tiene que arreglar proyectos de código reales o trabajar desde el terminal, la línea de comandos de los programadores, como lo haría un desarrollador.
- Agents’ Last Exam y OSWorld-2.1: uso del ordenador. El modelo ve la pantalla y usa ratón y teclado para terminar una tarea, por ejemplo rellenar una hoja de cálculo u ordenar archivos.
- AutomationBench: automatizaciones entre programas de empresa; la prueba es de Zapier. Vending-Bench 2, en cambio, simula un pequeño negocio de máquinas expendedoras que hay que gestionar durante meses: gana quien termina con más dinero en caja.
- Chartography y Blueprint-Bench 2: entender gráficos y dibujos técnicos, como los planos.
- GraphWalks: trabajar con textos larguísimos, de 256.000 a 1 millón de tokens, sin perder el hilo.
- RiemannBench y Terminal-Bench Science: matemáticas y trabajo científico.
- CWE-bench, ExploitGym y SEC-bench Pro: ciberseguridad, de la que hablo más abajo.
Dónde gana y dónde no
La mayor diferencia está en los textos largos: en GraphWalks Carbon saca un 96,2% frente al 71,8% de GPT-6 Astra y el 66,8% de Opus 5.5. Quiere decir que, cuando le das un documento enorme o un proyecto de código entero, encuentra la información correcta mucho mejor que los demás. También destaca en las automatizaciones de empresa (53,9% frente a poco más del 41-42% de la competencia) y en Terminal-Bench 4.0, donde supera a los demás en más de 5 puntos.
Pierde en dos pruebas, y son dos pruebas importantes. En FrontierSWE 2, programación en proyectos complejos, GPT-6 Astra sigue por delante (65,5% frente a 61,2%) y Opus 5.5 también lo hace mejor. En OSWorld-2.1, el uso del ordenador, Opus 5.5 gana con claridad: 87,2% frente a 81,5%. Si tu trabajo es que un agente use el ordenador, hoy Claude sigue siendo la opción más sólida.
Una última cosa a tener en cuenta: las pruebas las ha elegido Google, y cada empresa enseña las pruebas en las que sale mejor. Por eso más abajo tienes también los resultados de las pruebas independientes.
La ciberseguridad: el verdadero motivo de tanta prudencia
Google ha medido tres capacidades distintas, con las protecciones del modelo desactivadas, para ver hasta dónde llega de verdad:
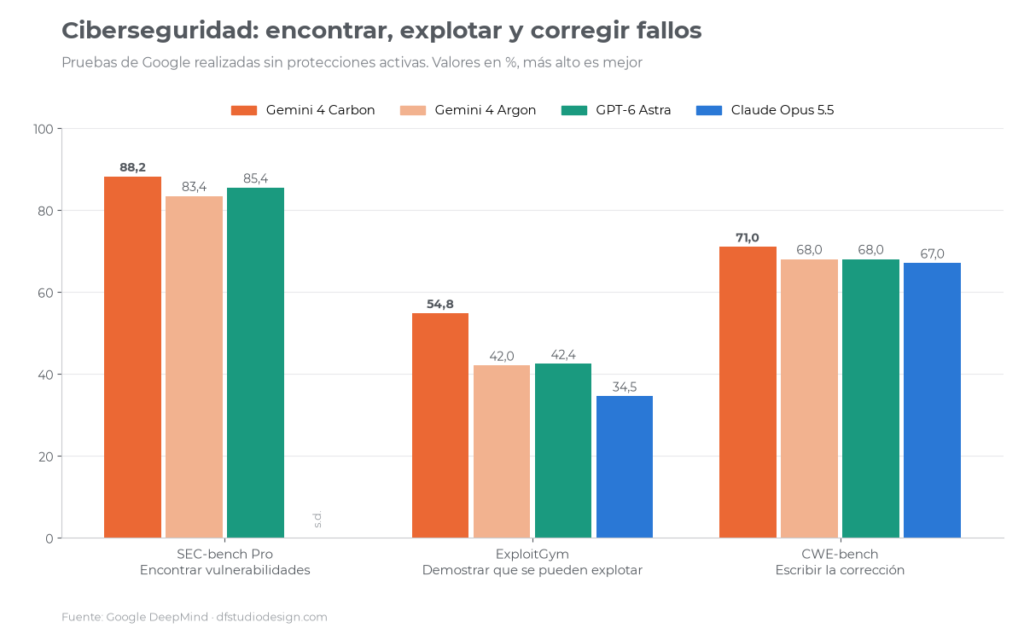
- Encontrar vulnerabilidades (SEC-bench Pro): 88,2%. El modelo recibe un programa y tiene que encontrar un fallo, demostrándolo con un pequeño código que hace fallar la versión defectuosa pero no la corregida. La prueba usa 183 fallos reales de motores JavaScript, los que ejecutan el código en los navegadores.
- Demostrar que se pueden explotar (ExploitGym): 54,8%, frente al 42,4% de GPT-6 Astra y el 34,5% de Opus 5.5. Aquí el modelo tiene que convertir un fallo en un ataque que funcione de verdad, sin internet. El 54,8% es el resultado con 10 horas de tiempo por tarea.
- Escribir la corrección (CWE-bench): 71,0%. Es la prueba de CWE-bench, gestionada por la empresa independiente Collinear: aquí la diferencia es menor, tres puntos sobre Argon y GPT-6 Astra.
Google añade tres datos que no se pueden comprobar desde fuera. En sus pruebas internas, Carbon escribe código seguro con una tasa de éxito más del doble que Argon. El equipo de Chrome dice que sus correcciones de seguridad fueron más de 10 veces mejores que las de un gran modelo de otro laboratorio, sin decir cuál. Y Wiz, empresa de seguridad en la nube, dice que Carbon es el mejor en sus pruebas de ataques a sitios web.
Visto así se entiende la prudencia: una herramienta que encuentra fallos, los explota y los corrige mejor que nadie es perfecta para quien defiende, pero sería un regalo para quien ataca. Por eso los primeros en usarla son las agencias de seguridad y quienes gestionan servicios esenciales.
Menos trampas, menos invenciones: qué cambia en su comportamiento
Con modelos que trabajan solos durante horas, el riesgo no es solo equivocarse, también hacer trampas: fingir que han terminado, saltarse una prueba o hacer más de lo que se les pide. Google declara estas mejoras respecto a Argon:
- Sin trampas en las pruebas: en Terminal-Bench 4.0 los intentos de hacer trampa bajan al 0,4% y los que salen bien al 0%, mientras que la precisión sube.
- Menos comportamientos raros mientras programa: en los entornos de trabajo internos las alertas graves de «desalineación» (cuando el modelo hace cosas distintas de las que le has pedido) bajan casi un 80%.
- Menos afirmaciones sin pruebas: más o menos la mitad que Argon.
- Hace más a menudo lo que pides, ni más ni menos: los casos en los que va más allá de lo pedido bajan un 26%, y los casos en los que hace menos de lo necesario, un 29%.
- Órdenes ocultas: al leer páginas web, correos o código, un agente puede encontrar instrucciones escritas a propósito para desviarlo. En la prueba de Gray Swan los ataques con éxito pasan del 0,7% de Argon al 0%. La propia Google reconoce que la prueba parece ya demasiado fácil y que el problema no está resuelto.
Según 9to5Google, cuando una petición es ambigua Carbon busca las fuentes y señala las diferencias antes de actuar, y en los documentos que genera incluye advertencias sobre el método que ha usado. Son detalles que, si se confirman en el uso real, cuentan más que un punto en la clasificación.
Qué dicen las pruebas independientes
Aquí la cosa se pone interesante, porque los números no los elige Google.
Artificial Analysis
En el Intelligence Index v5.0 de Artificial Analysis, que reúne nueve pruebas distintas, Carbon es el primero de 52 modelos con 59 puntos, 9 más que Argon. Es el primero en 4 de las 9 pruebas, sobre todo en razonamiento complejo, conocimiento y ciencia. En el índice de agentes que programan, en cambio, se queda por detrás: 59 puntos frente a los 62 de Opus 5.5.
Hay otros tres datos útiles, recogidos por The Decoder:
- Respuestas correctas y alucinaciones: en la prueba de conocimiento las respuestas correctas suben del 48% al 58%, mejor que Opus 5.5 y GPT-6 Astra (50% los dos). La tasa de alucinaciones, sin embargo, sube del 4% de Argon al 11%. Sigue entre las más bajas de la clasificación, pero es un paso atrás que hay que vigilar.
- Coste por tarea: 7,76 dólares a precio completo, casi igual que Argon (7,68), un 23% menos que Opus 5.5 (10,04) pero más que GPT-6 Astra (6,25).
- Consumo de tokens: unos 123.000 tokens de salida por tarea, un 29% menos que Opus 5.5. Aun así es un modelo que escribe y razona mucho: en todo el índice generó 200 millones de tokens, frente a una media de 64 millones.
Luego está la velocidad: una vez que arranca escribe a unos 100 tokens por segundo, que está en la media alta, pero antes de escribir la primera palabra razona durante casi 100 segundos. Para un chat rápido es mucho. Para un trabajo que dura horas, da igual.
Vals AI
En el Vals Index v2.2, que mide trabajos profesionales como finanzas, derecho y programación, Carbon queda segundo con un 70,36%, por detrás de Claude Sonnet 5.5 (70,85%) y justo por delante de Opus 5.5 (70,18%). Cuesta 10,51 dólares por prueba y tarda poco menos de 48 minutos, menos que los dos modelos de Anthropic. Es el primero en el índice de finanzas y en la investigación jurídica, donde cita alrededor de un 45% más de fuentes que Argon. La otra cara: en algunas tareas de finanzas e impuestos tarda más del doble que Argon.
Arena
En Arena, donde votan las personas, en la clasificación de chat de texto Carbon sube a 1.528 puntos, por delante de Argon (1.520); es cuarto en creación de sitios web con 1.768 puntos, 89 más que Argon, y segundo en la clasificación de agentes, por detrás de Opus 5.5. En esta última, eso sí, el coste medio de una tarea es de 1,80 dólares, un 72% menos que Opus 5.5.
Puestas juntas, las pruebas independientes confirman lo que dice Google con un matiz: Carbon es hoy el modelo más completo, pero no arrasa. En programación con agentes y en uso del ordenador, Anthropic sigue por delante.
Cuánto cuesta de verdad
La tarifa de la API que ha anunciado Google es esta, por millón de tokens:
| Tipo de uso | Precio de lanzamiento | Precio completo |
|---|---|---|
| Entrada (lo que le envías) | 2 $ | 4 $ |
| Salida (lo que escribe, razonamiento incluido) | 10 $ | 20 $ |
| Entrada ya en caché | 0,10 $ | 0,20 $ |
Google no ha dicho cuánto dura el precio de lanzamiento. Para Argon la promoción termina el 30 de noviembre de 2026, pero Carbon todavía no está a la venta, así que por ahora son solo cifras sobre el papel.
Para que te hagas una idea, pongamos un ejemplo inventado pero realista: un agente que revisa una web de unos cientos de páginas para una auditoría técnica, y que en total lee 4 millones de tokens y escribe 500.000.
- A precio de lanzamiento: 4 x 2 $ + 0,5 x 10 $ = 13 dólares.
- A precio completo: 4 x 4 $ + 0,5 x 20 $ = 26 dólares.
- Con la caché: si 3 de esos 4 millones son texto que el agente vuelve a leer varias veces, a precio completo baja a 4 $ + 0,60 $ + 10 $ = 14,60 dólares.
Se ve muy claro: con los modelos que razonan mucho, lo que pesa es la salida. Por eso el dato de Artificial Analysis sobre los tokens consumidos cuenta tanto como el precio de tarifa.
Para quién es y para quién no
Cuando llegue a todos, Carbon tendrá sentido sobre todo para:
- Quien trabaja en seguridad: encontrar y corregir fallos es su punto más fuerte.
- Quien maneja documentos o proyectos enormes: contratos, archivos, grandes bases de código. En textos largos no tiene rival, al menos en las pruebas.
- Quien crea automatizaciones entre programas de empresa: es el primero en AutomationBench con un buen margen.
- Quien hace trabajos largos y bien definidos: análisis, informes, investigaciones que duran horas, donde los 100 segundos de espera inicial no importan.
Tiene menos sentido, al menos por ahora, para:
- Quien usa Gemini gratis o quiere probarlo ya: sencillamente no está.
- Quien quiere respuestas rápidas: para las preguntas del día a día un modelo más rápido y barato hace el mismo trabajo.
- Quien quiere que un agente use el ordenador: en OSWorld Opus 5.5 sigue claramente por delante.
- Quien programa en proyectos complejos: en FrontierSWE 2 y en el índice de Artificial Analysis para agentes que programan, GPT-6 Astra y Opus 5.5 todavía lo hacen mejor.
Lo que pienso
Llevo más de diez años trabajando con webs, SEO y contenidos, y en los últimos dos años he visto salir un modelo «mejor que todos» casi cada mes. Lo que me llama la atención de Carbon no es el primer puesto, que con un punto de ventaja puede cambiar en el próximo lanzamiento de OpenAI o Anthropic. Es la dirección: el modelo más potente de Google nace para trabajar solo durante días y para encontrar fallos en el software, y por eso sale primero para los defensores.
Para quien gestiona webs, esta dirección importa más de lo que parece. Si una IA encuentra un fallo en un motor JavaScript en pocas horas, también encontrará los de los plugins de WordPress. Estas herramientas las usará quien defiende, pero tarde o temprano también quien ataca. Cuando escribí sobre los 11 fallos corregidos en WordPress 7.1.1 el consejo era actualizar enseguida; con modelos así es todavía más cierto, porque el tiempo entre que se descubre un fallo y llega el primer ataque se acorta. Un servicio de mantenimiento web con actualizaciones constantes ya no es un extra.
En lo práctico, mi consejo es el mismo de siempre: no cambies de modelo por un punto en una clasificación. Cuando Carbon esté disponible, pruébalo con tus trabajos reales, con tus documentos y tus costes, y compáralo con lo que usas hoy. Si trabajas con textos largos o automatizaciones puede que notes la diferencia; si haces otra cosa, quizá no.
Conclusión
Gemini 4 Carbon es hoy el modelo más capaz según el índice más seguido, con puntos muy fuertes en textos largos, automatizaciones y ciberseguridad, y dos debilidades claras: el uso del ordenador y la programación en proyectos complejos. Cuesta lo mismo que Argon, gasta menos tokens que Opus 5.5 y razona mucho antes de responder. Por ahora sigue en manos de unos pocos defensores, y la fecha para todos los demás no existe todavía. Si Google sigue el ritmo de Argon, podría llegar en pocas semanas: en cuanto pase, actualizo el artículo.
Preguntas frecuentes
¿Qué es Gemini 4 Carbon?
Es el nuevo modelo insignia de Google DeepMind, anunciado el 28 de octubre de 2026 y construido a partir de Gemini 4 Argon. Google lo describe como su modelo más potente, pensado para la ciberseguridad, la programación y los trabajos largos con agentes, que pueden durar incluso días.
¿Es el mejor modelo del mundo?
En el Intelligence Index v5.0 de Artificial Analysis sí: es el primero de 52 modelos con 59 puntos, por delante de Claude Opus 5.5 (58) y GPT-6 Astra (57). Pero el margen es pequeño y en algunas pruebas pierde: Opus 5.5 es mejor en el uso del ordenador y GPT-6 Astra en la programación de proyectos complejos.
¿Puedo usarlo ya?
Por ahora no, salvo que formes parte del grupo de ciberdefensores elegidos por Google o del programa Fairwind. No está en la app Gemini ni en la API pública. Google dice que llegará a desarrolladores, empresas y usuarios lo antes posible, sin fecha.
¿Cuánto cuesta?
En la API el precio de lanzamiento es de 2 dólares por millón de tokens de entrada y 10 de salida, igual que Argon, con un 95% de descuento en el texto ya en caché. Después del periodo de lanzamiento el precio se duplica: 4 y 20 dólares. Google no ha dicho cuánto dura ese periodo.
¿Por qué Google lo da primero a los expertos en seguridad?
Porque es muy bueno encontrando fallos en el software, demostrando que se pueden explotar y corrigiéndolos. Es útil para quien defiende, pero también podría usarse para atacar. Por eso Google lo da primero a quienes protegen redes y servicios esenciales, y lo deja probar al Gobierno de Estados Unidos antes del lanzamiento público.
¿Qué diferencia hay entre Carbon y Argon?
Carbon parte de Argon y lo mejora casi en todo: 9 puntos más en el índice de Artificial Analysis, mucha más fiabilidad con textos largos, más nivel en programación y ciberseguridad, menos trampas y menos afirmaciones sin pruebas. El precio de lanzamiento es el mismo. Pero Argon ya se puede usar hoy y Carbon no.
¿Se puede probar en Arena?
No cuando uno quiera. Antes del lanzamiento apareció en Arena una versión de prueba anónima, y quien se la encontraba en los duelos a ciegas la usaba sin saberlo. Hoy Carbon aparece en las clasificaciones de Arena, pero no hay forma de elegirlo y usarlo cuando se quiera.
Lee también:
Claude Opus 5.5, GPT-6 Sol y Luna: precios y benchmarks comparados ·
ChatGPT 6 Astra: novedades, precios y benchmarks oficiales ·
Claude Fable 5.1 y Mythos 5.1: benchmarks, precios y recorte del 75%
Fuentes
- Google, Gemini 4 Carbon: our next frontier model, 28 de octubre de 2026: anuncio, ciberseguridad, alineación, acceso y precios.
- Google DeepMind, Gemini 4 Carbon model evaluation: tabla completa de los 17 benchmarks y método de las pruebas.
- Google DeepMind, Fairwind Program: quién puede acceder y con qué reglas.
- Artificial Analysis, Gemini 4 Carbon: Intelligence Index v5.0, velocidad, contexto y consumo de tokens.
- The Decoder, 28 de octubre de 2026: pruebas independientes de Artificial Analysis, Vals AI y Arena.
- 9to5Google: precios tras el lanzamiento y cambios en el comportamiento del modelo.
- Yahoo Finanzas: la noticia en español.

Animaciones con scroll en CSS: desde 2026 funcionan en todos
Animaciones con scroll en CSS: desde 2026 funcionan en todos los navegadores, sin JavaScript Por Daniele Forciniti Desde el 27 de octubre…

Kimi K3.1 Pro: novedades, benchmarks y precios del modelo de
Kimi K3.1 Pro: novedades, benchmarks y precios del modelo de pesos abiertos que desafía a Opus 5.5 Por Daniele Forciniti Kimi K3.1…
Google mueve los AI Overviews de las marcas a la
Google mueve los AI Overviews de las marcas a la columna derecha y prueba a quitar el Modo IA: qué…
Core Web Vitals en 2026: qué son LCP, INP y
Core Web Vitals en 2026: qué son LCP, INP y CLS y cómo mejorarlos Por Daniele Forciniti Los Core Web Vitals son…
TokenEconomizer: qué es y cómo reduce hasta un 31% el
TokenEconomizer: qué es y cómo reduce hasta un 31% el coste de Claude Code, Codex y Copilot Por Daniele Forciniti TokenEconomizer es…
Title, meta description y snippet en 2026: cómo escribirlos y
Title, meta description y snippet en 2026: cómo escribirlos y por qué Google los cambia Por Daniele Forciniti El title y la…