
Kimi K3.1 Pro: novedades, benchmarks y precios del modelo de pesos abiertos que desafía a Opus 5.5
Por Daniele Forciniti
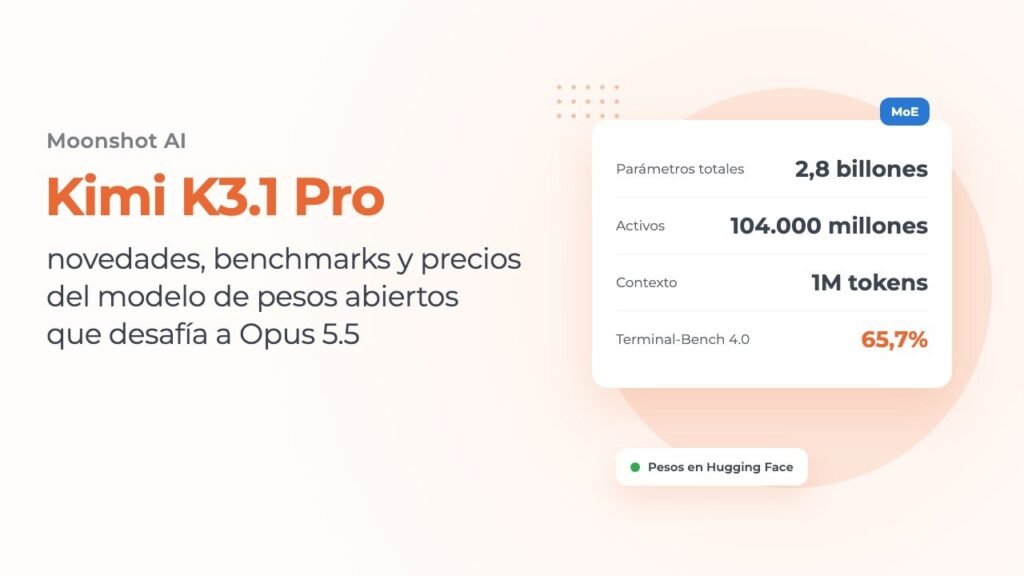
Kimi K3.1 Pro es el nuevo modelo insignia de Moonshot AI: un modelo de expertos (MoE) de 2,8 billones de parámetros, de los que 104.000 millones están activos en cada token, que entiende texto e imágenes y trabaja con un contexto de 1 millón de tokens. Salió el 23 de octubre de 2026 en Kimi y por API, y desde el 4 de noviembre los pesos completos se pueden descargar de Hugging Face, tal como se había prometido. En Terminal-Bench 4.0, la prueba que mide cómo trabaja un agente desde la terminal, saca un 65,7%, casi lo mismo que Claude Opus 5.5 (66,4%) y más que GPT-6 Astra (58,2%), y cuesta 2 dólares por millón de tokens de entrada y 10 de salida.
Qué cambia respecto a Kimi K3
K3.1 Pro no es un modelo hecho desde cero. Es Kimi K3, que salió en julio, entrenado mucho más tiempo con aprendizaje por refuerzo en cientos de ámbitos distintos: programación, modelado 3D, finanzas, investigación. El blog técnico de Moonshot habla de un aumento importante de la potencia de cálculo dedicada a esta segunda fase, y de ahí salen las mejoras.
El único cambio en la arquitectura afecta a la forma en que el modelo «mira» los textos largos. En 24 de sus 93 capas Moonshot ha cambiado la atención completa por una atención dispersa (Gated DSA, la técnica que introdujo DeepSeek), que en lugar de comparar cada palabra con todas las demás elige las 2.048 más relevantes. Sirve para aguantar el millón de tokens de contexto sin que se disparen los costes.
| Característica | Kimi K3.1 Pro |
|---|---|
| Arquitectura | Mixture-of-Experts (modelo de expertos) |
| Parámetros totales | 2,8 billones |
| Parámetros activos por token | 104.000 millones |
| Expertos | 896, de los que se eligen 16 en cada token, más 2 siempre activos |
| Contexto | 1.048.576 tokens (aprox. 1 millón) |
| Entrada | Texto e imágenes (la API acepta también vídeo) |
| Formato de los pesos | MXFP4, entrenado ya en ese formato (1,56 TB en Hugging Face) |
| Lanzamiento | 23 de octubre de 2026 (apps y API), pesos públicos desde el 4 de noviembre de 2026 |
| Licencia | Kimi K3.1-Pro License, tipo MIT con dos condiciones para los grandes |
Un modelo de expertos funciona como una oficina con 896 especialistas: para cada palabra que hay que escribir solo se llama a 16, más dos generalistas que están siempre. Por eso, aunque tiene 2,8 billones de parámetros en total, en cada token usa «solo» 104.000 millones, y responde con un coste mucho menor que un modelo denso del mismo tamaño.
Los benchmarks: cerca de Opus 5.5, pero no en todo
El número que Moonshot pone en portada es el de Terminal-Bench 4.0: 65,7%, frente al 66,4% de Claude Opus 5.5 y el 58,2% de GPT-6 Astra. La prueba hace trabajar al modelo como un agente dentro de una terminal real, con recursos limitados y comprobaciones estrictas, así que es una de las más parecidas al trabajo real de quien programa con IA.
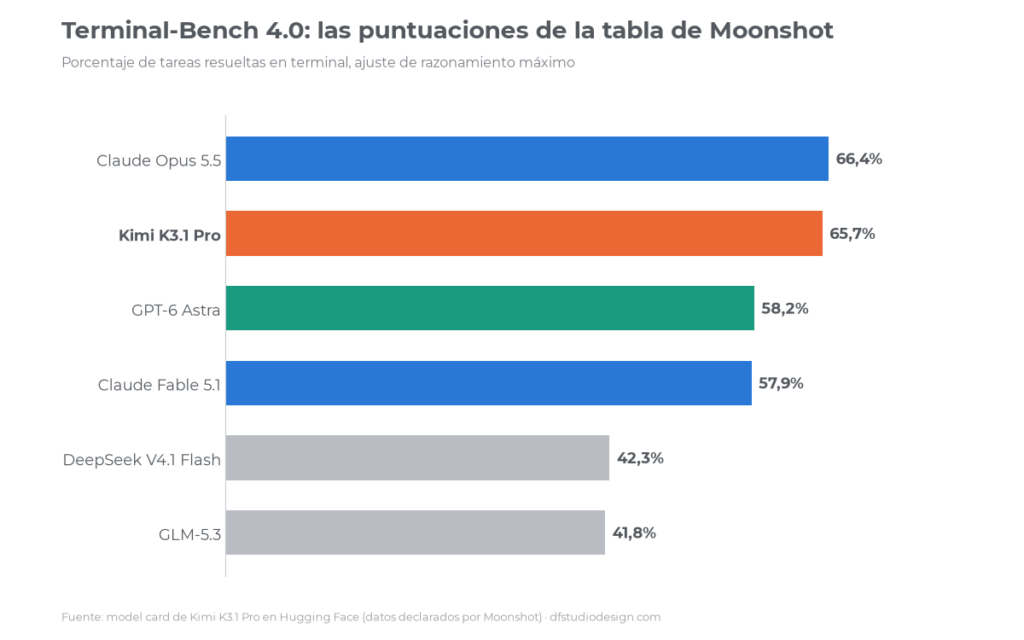
Un detalle que casi nadie ha comentado: Moonshot midió K3.1 Pro usando Claude Code como entorno de trabajo, es decir, el mismo programa que Anthropic usa para sus modelos. Funciona porque la API de Kimi es compatible con el formato de Anthropic: quien ya usa Claude Code puede probarlo cambiando solo la dirección y la clave de la API.
¿Aguanta el 65,7% en Terminal-Bench?
Los números que declara quien vende el modelo siempre hay que revisarlos, así que fui a ver quién lo ha medido por su cuenta. Artificial Analysis, que repite las pruebas con su propio método, obtuvo un 67,2%. Vals AI obtuvo un 63,6% (con un margen de error de más o menos 1,75 puntos) y lo coloca tercero de 61 modelos en esa prueba.
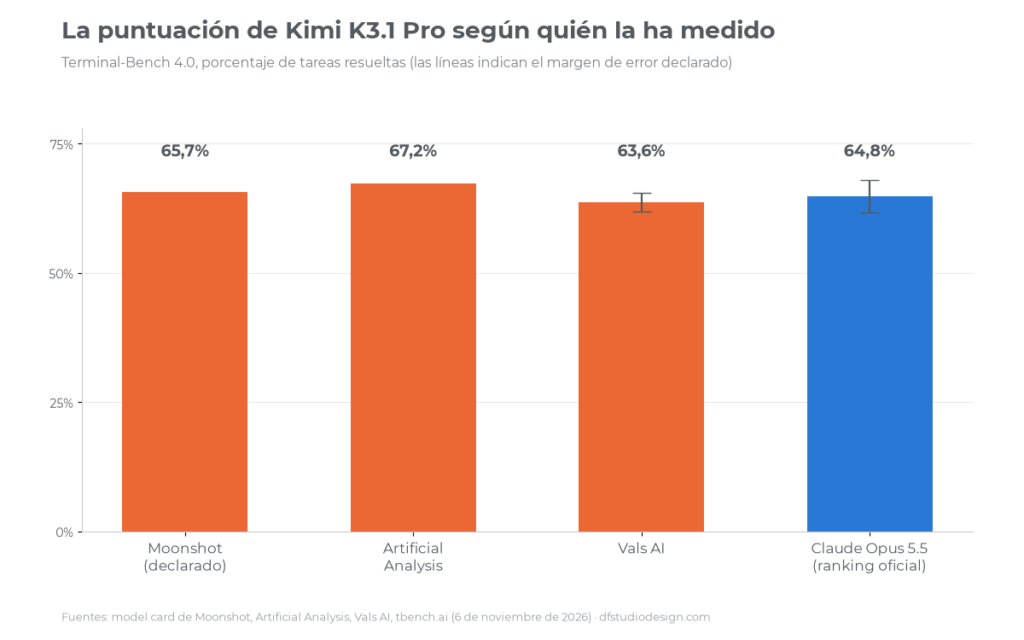
Hay otro detalle en la comparación con Opus 5.5. Moonshot usa el 66,4%, es decir, el valor más alto publicado por Anthropic, mientras que en el ranking oficial de Terminal-Bench Opus 5.5 aparece con un 64,8% y un margen de error de 3,1 puntos. En resumen: en esta prueba Kimi K3.1 Pro y Opus 5.5 están prácticamente empatados, y las diferencias de un punto caen dentro del margen de error. A 6 de noviembre, Kimi todavía no aparece en el ranking oficial.
Dónde gana y dónde pierde
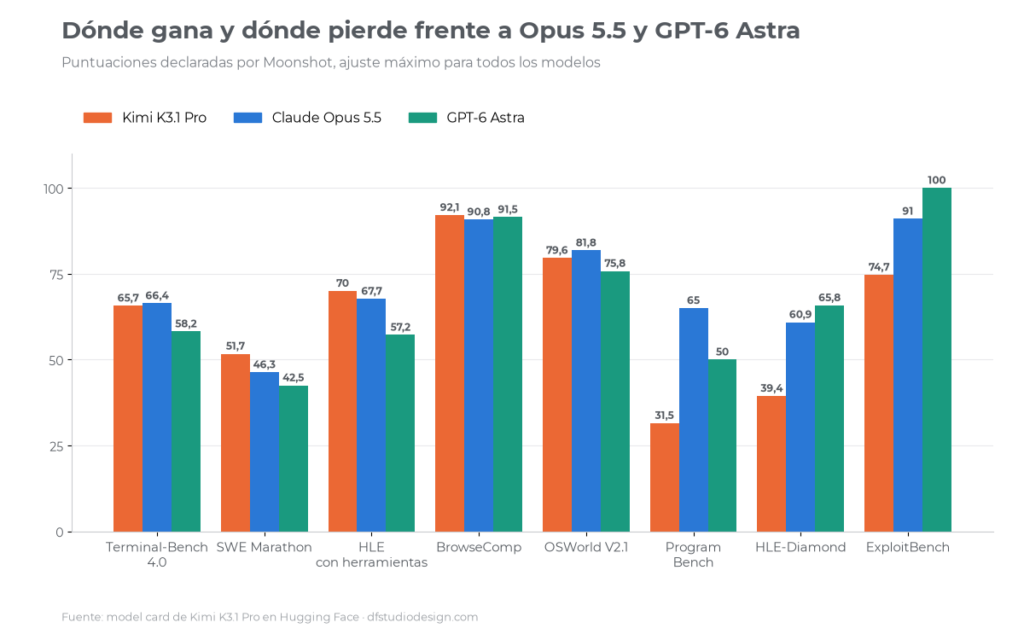
La tabla completa de la model card tiene más de 40 pruebas, y el panorama es menos uniforme de lo que dice el titular del anuncio. He elegido ocho pruebas que explican bien los puntos fuertes y los débiles.
| Prueba | Qué mide | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|---|
| SWE Marathon v1.1 | Trabajos de programación muy largos | 51,7 | 46,3 | 42,5 |
| HLE-Full con herramientas | Preguntas dificilísimas, con búsqueda y código | 70,0 | 67,7 | 57,2 |
| BrowseComp | Encontrar información difícil en la web | 92,1 | 90,8 | 91,5 |
| OfficeQA Pro v2 | Análisis de documentos financieros reales | 64,4 | 62,2 | 54,4 |
| OSWorld V2.1 | Usar un ordenador como una persona | 79,6 | 81,8 | 75,8 |
| HLE-Full sin herramientas | Las mismas preguntas, solo razonando | 51,1 | 59,8 | 53,6 |
| Program Bench | Reconstruir programas completos | 31,5 | 65,0 | 50,0 |
| PerceptionBench | Entender bien las imágenes | 68,3 | 72,1 | 77,6 |
El dibujo está claro. Cuando el modelo puede usar herramientas (buscar en la web, ejecutar código, trabajar horas en una tarea larga) compite con los mejores, y en algunos casos los supera. Cuando tiene que razonar «a pelo», reconstruir programas enteros o leer imágenes con precisión, se queda por detrás de los modelos cerrados de Anthropic y OpenAI. En HLE-Diamond, la parte más difícil de esa prueba, saca un 39,4 frente al 60,9 de Opus 5.5 y al 65,8 de GPT-6 Astra.
Alucinaciones y ciberseguridad
Dos números del blog merecen atención. El primero tiene que ver con la información inventada: en una prueba interna diseñada para hacer fallar a los modelos, el porcentaje de afirmaciones falsas baja del 23,4% de Kimi K3 al 8,3%. La propia Moonshot aclara que no es la tasa de error en el uso diario, pero la dirección es la buena, sobre todo para quien quiere usarlo con documentos financieros.
El segundo es más curioso. Antes de publicar los pesos, Moonshot quitó de los datos de entrenamiento el contenido de ciberseguridad ofensiva, para no regalar a cualquiera un modelo capaz de escribir exploits. Se nota en los resultados: en una prueba interna de explotación de vulnerabilidades la versión «limpia» resuelve el 81% de los casos, frente al 90,5% que habría alcanzado sin ese filtro, y en ExploitBench queda por debajo de Opus 5.5 y GPT-6 Astra.
Cuánto cuesta Kimi K3.1 Pro y dónde se usa
Según la tarifa oficial, por API cuesta 2 dólares por millón de tokens de entrada y 10 dólares por millón de salida, con la entrada ya en memoria (caché) a 0,20 dólares. Es menos que Kimi K3, que costaba 3 y 15 dólares. Para trabajos que no necesitan respuesta inmediata existe el procesamiento por lotes (batch) al 60% del precio.
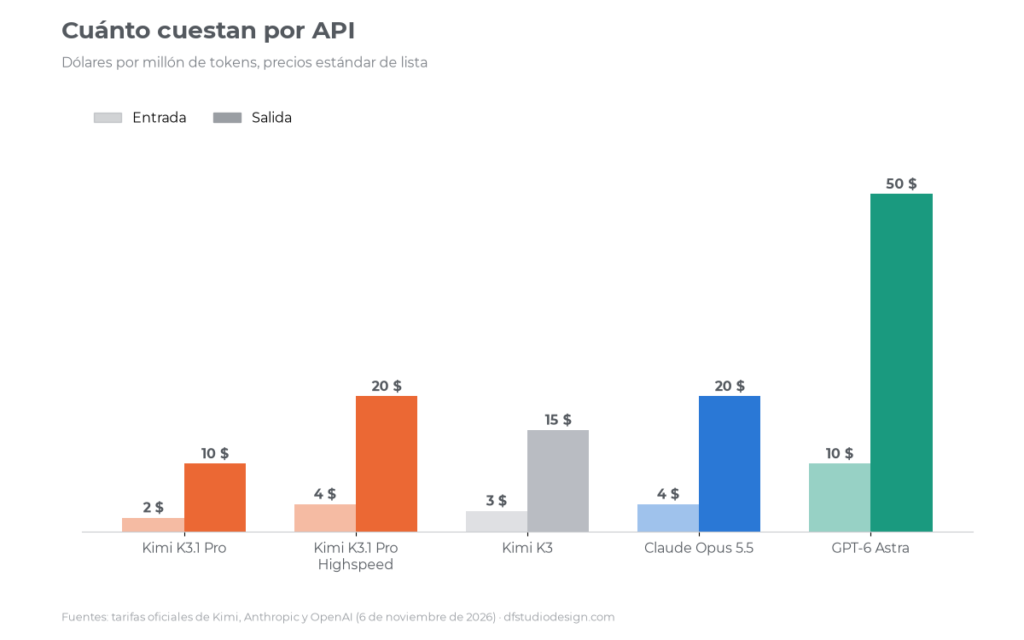
| Modelo | Entrada | Salida | Entrada en caché |
|---|---|---|---|
| Kimi K3.1 Pro | 2 $ | 10 $ | 0,20 $ |
| Kimi K3.1 Pro Highspeed | 4 $ | 20 $ | 0,20 $ |
| Kimi K3 | 3 $ | 15 $ | 0,30 $ |
| Claude Opus 5.5 | 4 $ | 20 $ | 0,20 $ |
| GPT-6 Astra | 10 $ | 50 $ | 1 $ |
Frente a GPT-6 Astra cuesta una quinta parte, y con resultados parecidos en Terminal-Bench el ahorro es enorme. Frente a Opus 5.5 la cosa cambia: Kimi cuesta la mitad, pero la versión Highspeed, dos o tres veces más rápida, cuesta exactamente lo mismo que Opus 5.5. En la comparativa que hice entre Claude Opus 5.5 y GPT-6 el precio de Opus ya había bajado bastante, y aquí se nota.
Luego está la velocidad, que el precio por token no cuenta. Artificial Analysis mide unos 33 tokens por segundo, casi tres minutos antes de la primera respuesta en las preguntas difíciles y 36 minutos de media para terminar una de sus tareas, frente a los 13,5 de la media de modelos parecidos. Con el razonamiento al máximo (el ajuste por defecto) es un modelo lento y que habla mucho, y esos tokens de más se pagan. Para bajar los tiempos se puede elegir el nivel de razonamiento «low» o «high», o pasar a la versión Highspeed.
Dónde se usa:
- Kimi.ai y las apps de Kimi para iOS, Android y HarmonyOS, para chatear y usar los agentes;
- Kimi Work, la app de escritorio para Windows y Mac con chip de Apple (desde la versión 3.1.0);
- Kimi Code, el agente para programar: el modelo se elige con el comando /model;
- API con el nombre kimi-k3.1-pro, compatible con el formato de OpenAI y de Anthropic (la guía rápida explica los parámetros), con retención cero de datos si se pide;
- Kimi Business para empresas: el administrador tiene que activarlo, porque al principio está desactivado.
Los pesos en Hugging Face: qué puedes hacer de verdad con ellos
Moonshot había prometido los pesos para el 4 de noviembre y ha cumplido: el repositorio en Hugging Face es público, sin formularios que rellenar, y contiene 1,56 TB repartidos en 96 archivos. Es una buena noticia para quien investiga y para las empresas que quieren tener los datos en casa. Pero «pesos abiertos» no significa que puedas ejecutarlo en tu ordenador.
Según la guía oficial de vLLM, la configuración mínima es un grupo de 8 GPU de gama altísima: dos bandejas NVIDIA GB300 o un servidor B300, o bien un servidor AMD MI355X o 16 chips TPU de Google. Son máquinas de centro de datos que cuestan cientos de miles de euros. Si buscas un modelo para usar en local en tu PC, el camino siguen siendo los modelos pequeños que se instalan con Ollama.
La licencia también hay que leerla. Es una MIT modificada: puedes usar, modificar y revender el modelo libremente, con dos excepciones pensadas para los grandes:
| Quién | Qué tiene que hacer |
|---|---|
| Empresas que venden el modelo como servicio (API) con más de 20 millones de dólares de ingresos en 12 meses | Firmar un acuerdo aparte con Moonshot antes del uso comercial |
| Productos con más de 100 millones de usuarios al mes o más de 20 millones de dólares de ingresos al mes | Mostrar de forma visible «Kimi K3.1-Pro» en la interfaz |
| Uso interno, o a través de los productos oficiales de Moonshot y sus socios certificados | Ninguna de las dos condiciones |
Para una pyme, una agencia o un desarrollador, en la práctica, la licencia no pone límites.
A quién le conviene
- A quien programa con agentes y gasta mucho con Opus o GPT-6 Astra: en Terminal-Bench y en los trabajos largos da resultados parecidos a un coste menor, y se conecta también a Claude Code.
- A quien trabaja con documentos y datos financieros, donde tiene sus mejores resultados y menos información inventada que K3.
- A quien hace modelado 3D y diseño paramétrico: Moonshot ha apostado fuerte por Blender, CAD y motores de juego como Unity, Unreal y Godot.
- A las empresas que quieren un modelo de alto nivel en sus propios servidores, siempre que tengan (o alquilen) el hardware adecuado.
Conviene menos a quien necesita respuestas rápidas, a quien trabaja mucho con imágenes y a quien tiene que razonar sobre problemas difíciles sin herramientas: ahí los modelos cerrados siguen por delante.
Mi opinión después de ordenar los números
Todavía no he usado K3.1 Pro en mis trabajos, así que lo que escribo es una prueba sobre los números: he cruzado la tabla de Moonshot con las pruebas independientes, las tarifas y la documentación técnica. Llevo más de diez años haciendo webs y posicionándolas en Google, y en los dos últimos he visto pasar un modelo «que gana a todos» casi cada mes: la diferencia siempre la marcan los detalles que no salen en el titular.
Aquí los detalles son buenos. La puntuación en Terminal-Bench la confirman dos entidades independientes, los pesos han llegado en la fecha prometida y la licencia es de verdad permisiva para quien no es un gigante. No es habitual ver un modelo abierto a un punto de Opus en una prueba tan parecida al trabajo real. Dicho esto, no es «el nuevo Opus a mitad de precio»: es más lento, gasta más tokens y pierde donde hay que razonar sin herramientas. Lo veo bien como motor para agentes que trabajan mucho tiempo, quizá junto a un modelo cerrado para las partes más delicadas, más que como sustituto único. Y si ya trabajas con GPT-6 Astra, es la primera comparación que conviene hacer en serio, porque la diferencia de precio es de cinco veces.
En pocas palabras
Kimi K3.1 Pro es un modelo de pesos abiertos de 2,8 billones de parámetros que en Terminal-Bench 4.0 llega al nivel de Claude Opus 5.5 y supera a GPT-6 Astra, con confirmaciones independientes entre el 63,6% y el 67,2%. Cuesta 2 y 10 dólares por millón de tokens, tiene los pesos públicos en Hugging Face con una licencia permisiva, pero hacen falta 8 GPU de centro de datos para ejecutarlo. Es fuerte en agentes y trabajos largos, más flojo en razonamiento puro y visión, y es lento con el razonamiento al máximo.
Preguntas frecuentes
¿Qué es Kimi K3.1 Pro?
Es el modelo insignia de Moonshot AI, lanzado el 23 de octubre de 2026. Es una versión de Kimi K3 entrenada durante más tiempo, con 2,8 billones de parámetros totales, 104.000 millones activos por token y un contexto de 1 millón de tokens.
¿Los pesos se pueden descargar de verdad?
Sí. Desde el 4 de noviembre de 2026 los pesos completos son públicos en Hugging Face, sin registro, con la licencia Kimi K3.1-Pro. Ocupan unos 1,56 TB.
¿Cuánto cuesta usarlo por API?
2 dólares por millón de tokens de entrada y 10 de salida, 0,20 dólares por la entrada en caché. La versión Highspeed cuesta el doble (4 y 20 dólares) y es dos o tres veces más rápida.
¿Es mejor que Claude Opus 5.5?
En Terminal-Bench 4.0 están prácticamente empatados, y Kimi gana en algunas pruebas con herramientas como SWE Marathon y BrowseComp. Opus 5.5 sigue por delante en el razonamiento sin herramientas, en la reconstrucción de programas completos y en visión.
¿Puedo ejecutarlo en mi ordenador?
No. Hacen falta al menos 8 GPU de centro de datos, como dos bandejas NVIDIA GB300 o un servidor B300. Para usarlo sin ese hardware está la API o la app de Kimi.
¿Se puede usar con Claude Code?
Sí. La API de Kimi es compatible con el formato de Anthropic, y la propia Moonshot midió los benchmarks de programación usando Claude Code.
¿Se puede usar para trabajar, también en un producto comercial?
Sí. La licencia permite el uso comercial. Las únicas condiciones afectan a quien vende el modelo como servicio con más de 20 millones de dólares de ingresos anuales y a los productos con más de 100 millones de usuarios al mes.
Lee también:
Kimi Work: qué es, cómo funciona y cuánto cuesta el agente de escritorio de Moonshot AI ·
MiniMax M3.1 Flash: novedades, precios y benchmarks del modelo chino para agentes de IA ·
TokenEconomizer: qué es y cómo reduce hasta un 31% el coste de Claude Code, Codex y Copilot
Fuentes
- Model card de Kimi K3.1 Pro en Hugging Face: arquitectura, tabla completa de benchmarks y notas sobre los métodos.
- Moonshot AI, blog técnico de Kimi K3.1 Pro: novedades, disponibilidad y decisiones sobre ciberseguridad.
- Tarifa oficial de la plataforma Kimi y licencia Kimi K3.1-Pro.
- vLLM Recipes, Kimi-K3.1-Pro: hardware necesario para ejecutarlo.
- Artificial Analysis y Vals AI: pruebas independientes en Terminal-Bench 4.0, velocidad y costes.
- Ranking oficial de Terminal-Bench 4.0.

Animaciones con scroll en CSS: desde 2026 funcionan en todos
Animaciones con scroll en CSS: desde 2026 funcionan en todos los navegadores, sin JavaScript Por Daniele Forciniti Desde el 27 de octubre…

Google mueve los AI Overviews de las marcas a la
Google mueve los AI Overviews de las marcas a la columna derecha y prueba a quitar el Modo IA: qué…
Core Web Vitals en 2026: qué son LCP, INP y
Core Web Vitals en 2026: qué son LCP, INP y CLS y cómo mejorarlos Por Daniele Forciniti Los Core Web Vitals son…
TokenEconomizer: qué es y cómo reduce hasta un 31% el
TokenEconomizer: qué es y cómo reduce hasta un 31% el coste de Claude Code, Codex y Copilot Por Daniele Forciniti TokenEconomizer es…
Title, meta description y snippet en 2026: cómo escribirlos y
Title, meta description y snippet en 2026: cómo escribirlos y por qué Google los cambia Por Daniele Forciniti El title y la…
Gemini 4 Carbon: novedades, benchmarks y precios del modelo más
Gemini 4 Carbon: novedades, benchmarks y precios del modelo más potente de Google Por Daniele Forciniti Gemini 4 Carbon es el nuevo…