
Claude Opus 5.5, GPT-6 Sol e Luna: prezzi e benchmark a confronto
Di Daniele Forciniti
Il 22 settembre 2026 Anthropic ha pubblicato Claude Opus 5.5, a 4 dollari per milione di token in entrata e 20 in uscita, il 20% in meno di Opus 5. Lo stesso giorno OpenAI ha lanciato GPT-6 Sol (2 e 10 dollari) e GPT-6 Luna (10 e 50 centesimi), a metà prezzo rispetto ai GPT-5.6. Nell’indice indipendente di Artificial Analysis Opus 5.5 è primo con 58 punti, Sol ne fa 48 e Luna 37.
Fin qui è quello che trovi ovunque, anche nel post che sta girando sui social con i tre prezzi affiancati. Quello che manca è la parte che conta per chi paga la bolletta: il prezzo per token non è il costo per compito. Un modello più economico a token può costare di più alla fine del lavoro, se per arrivarci ne consuma quattro volte tanti. In questo articolo metto in fila i prezzi veri, i benchmark ufficiali, quelli indipendenti e il costo reale per compito, e alla fine ti dico quale usare e quando.
Perché questo doppio lancio conta
Due aziende che lanciano lo stesso giorno, quasi alla stessa ora, non è una coincidenza di calendario: è una guerra di prezzi dichiarata. Per anni il modello migliore è stato anche il più caro, e chi voleva risparmiare accettava un modello più debole. Adesso le due scelte si stanno avvicinando.
Il segnale più chiaro è che Opus 5.5 supera in molti test Claude Fable 5.1, il modello di punta di Anthropic che costa 10 e 50 dollari, cioè due volte e mezzo tanto. Dall’altra parte, OpenAI ha portato su Sol e Luna gli stessi metodi di addestramento di GPT-6 Astra, il suo modello più capace, che resta a 10 e 50 dollari. In pratica entrambe le aziende stanno spostando verso il basso l’intelligenza che prima si pagava a prezzo pieno.
Per chi usa l’intelligenza artificiale per lavoro, un token è più o meno tre quarti di parola: è l’unità con cui ti fatturano sia quello che mandi al modello (entrata) sia quello che ti risponde (uscita). L’uscita costa sempre di più, ed è proprio lì che si nasconde la differenza tra i modelli.
I prezzi, uno accanto all’altro
Ho preso i listini direttamente dalle pagine ufficiali di Anthropic e di OpenAI. Prezzi in dollari per milione di token.
| Modello | Entrata | Uscita | Lettura dalla cache | Prima costava | Riduzione |
|---|---|---|---|---|---|
| Claude Opus 5.5 | $4 | $20 | $0,20 | $5 / $25 (Opus 5) | 20% a token, 60% sulla cache |
| GPT-6 Sol | $2 | $10 | $0,20 | $4 / $20 (GPT-5.6 Sol) | 50% |
| GPT-6 Luna | $0,10 | $0,50 | $0,01 | $0,20 / $1,20 (GPT-5.6 Luna) | 50% in entrata, 58% in uscita |
| GPT-6 Astra | $10 | $50 | $1 | invariato | nessuna |
| Claude Fable 5.1 | $10 | $50 | n/d | invariato | nessuna |
Tre precisazioni che il post virale non fa. La prima: il “50% in meno” vale per OpenAI, non per Anthropic. Opus 5.5 costa il 20% in meno a token, e Anthropic parla di un 40% di risparmio sui carichi di lavoro tipici perché il modello usa meno calcolo e meno token per lo stesso compito alle impostazioni predefinite. La seconda: OpenAI calcola il suo 50% rispetto al prezzo promozionale dei GPT-5.6, non rispetto al listino pieno. La terza: su Luna il taglio in uscita è del 58%, più di quanto dichiarato nel titolo.
Sulla cache le due aziende sono arrivate più o meno allo stesso punto. OpenAI applica uno sconto del 90% sui token già letti e ha migliorato il riconoscimento automatico delle parti riutilizzabili. Anthropic ha abbassato la lettura dalla cache di Opus 5.5 da 50 a 20 centesimi. Per chi costruisce agenti che rileggono lo stesso contesto cento volte, è la voce che pesa di più in fattura.
Claude Opus 5.5: cosa cambia davvero
Oltre al prezzo, secondo Anthropic Opus 5.5 genera testo oltre il 30% più veloce di Opus 5. Esiste anche una modalità veloce fino a due volte e mezzo più rapida, che costa il doppio: 8 dollari in entrata e 40 in uscita. Il modello è disponibile nelle app Claude, nell’API con il nome claude-opus-5-5 e sulle tre grandi nuvole, AWS, Google Cloud e Microsoft Azure, dal primo giorno. Chi ha un abbonamento Pro, Max, Team o Enterprise ha anche limiti più alti nelle finestre da cinque ore, che erano il punto dolente di Opus 5.
Questi sono i numeri principali della tabella ufficiale. Attenzione: Anthropic confronta Opus 5.5 con GPT-6 Astra e con GPT-5.6 Sol, non con il nuovo Sol, perché è uscito lo stesso giorno.
| Benchmark | Opus 5.5 | Opus 5 | Fable 5.1 | GPT-6 Astra |
|---|---|---|---|---|
| Terminal-Bench 4.0 (lavoro da terminale) | 66,4% | 52,3% | 55,8% | 57,9% |
| FrontierCode 1.1 (codice pronto da unire) | 54,4% | 48,0% | 50,3% | 53,3% |
| GDPval-AA 2.1 (lavoro d’ufficio, Elo) | 1.846 | 1.708 | 1.735 | 1.542 |
| AutomationBench (flussi aziendali) | 40,0% | 26,9% | 31,4% | 41,4% |
| Humanity’s Last Exam (con strumenti) | 67,7% | 63,6% | 65,6% | 57,2% |
| Terminal-Bench-Science 0.1 | 58,7% | 29,0% | 52,6% | 64,6% |
Il salto più grosso è sul lavoro da terminale, cioè gli agenti che scrivono codice, lanciano comandi e correggono da soli: più 14 punti su Opus 5. Astra resta davanti sui flussi aziendali automatizzati e sulla parte scientifica, ma di poco su AutomationBench. Anthropic cita anche un tester che ha completato una migrazione di codice da 680.000 righe in meno di un giorno, un lavoro che a un team sarebbe costato settimane: è un caso singolo riportato dall’azienda, da prendere come aneddoto e non come media.
Sul fronte sicurezza, Opus 5.5 smista la maggior parte delle richieste di cybersicurezza offensiva verso il vecchio Opus 4.8, salvo per chi entra nel programma di verifica dedicato. È una scelta che a qualche sviluppatore darà fastidio e che va conosciuta prima di migrare.
GPT-6 Sol e GPT-6 Luna: cosa cambia davvero
Sol e Luna completano la famiglia GPT-6 sotto Astra, che resta il modello di punta di OpenAI. Sol è pensato per il codice complesso e gli agenti, Luna per i compiti mirati da far girare in grandi volumi a costo minimo. Nella valutazione interna di OpenAI sulla correttezza dei fatti, Sol fa circa la metà degli errori del suo predecessore.
I numeri più interessanti del comunicato sono quelli sul costo per compito. Su AutomationBench, Sol al livello di ragionamento più alto prende il 33,2% spendendo 27 centesimi a compito, mentre Claude Opus 5 al massimo prende il 26,9% costando 11 volte di più. Su DeepSWE, un test di ingegneria del software su codebase reali, Sol arriva al 68,8% e Luna al 66,6%, con Luna che costa il 93% in meno di Opus 5 a compito. Su OSWorld 2.0, l’uso del computer come farebbe una persona, Sol pareggia Opus 5 (60,5% contro 60,3%) a circa un quinto del costo.
Anche qui c’è il trucco dello specchio: OpenAI si misura con Opus 5 e Fable 5.1, non con Opus 5.5. Nessuna delle due aziende, nei propri grafici, si confronta con il modello uscito quel giorno dall’altra.
Sulla disponibilità: Sol e Luna sono in ChatGPT Work e in Codex per gli abbonati Plus, Pro, Business, Enterprise ed Edu. Gli utenti gratuiti e Go possono usare Luna solo dall’app desktop. Nella chat classica non ci sono ancora. Nell’API si chiamano gpt-6-sol e gpt-6-luna.
Il confronto indipendente: prezzo per token contro costo per compito
Visto che le aziende si confrontano ciascuna con il modello vecchio dell’altra, l’unico confronto diretto e aggiornato è quello di Artificial Analysis, che fa girare la stessa batteria di test su tutti i modelli e pubblica anche quanto è costato farlo. Ed è qui che il quadro cambia.
| Modello (livello di ragionamento) | Punteggio | Costo medio per compito | Token in uscita per tutto l’indice |
|---|---|---|---|
| Claude Opus 5.5 (max) | 58 | $5,98 | 260 milioni |
| GPT-6 Astra (max) | 53 | $3,26 | 60 milioni |
| Claude Opus 5.5 (medium) | 51 | $1,34 | 38 milioni |
| GPT-6 Sol (max) | 48 | $1,06 | 77 milioni |
| GPT-6 Luna (max) | 37 | $0,07 | 150 milioni |
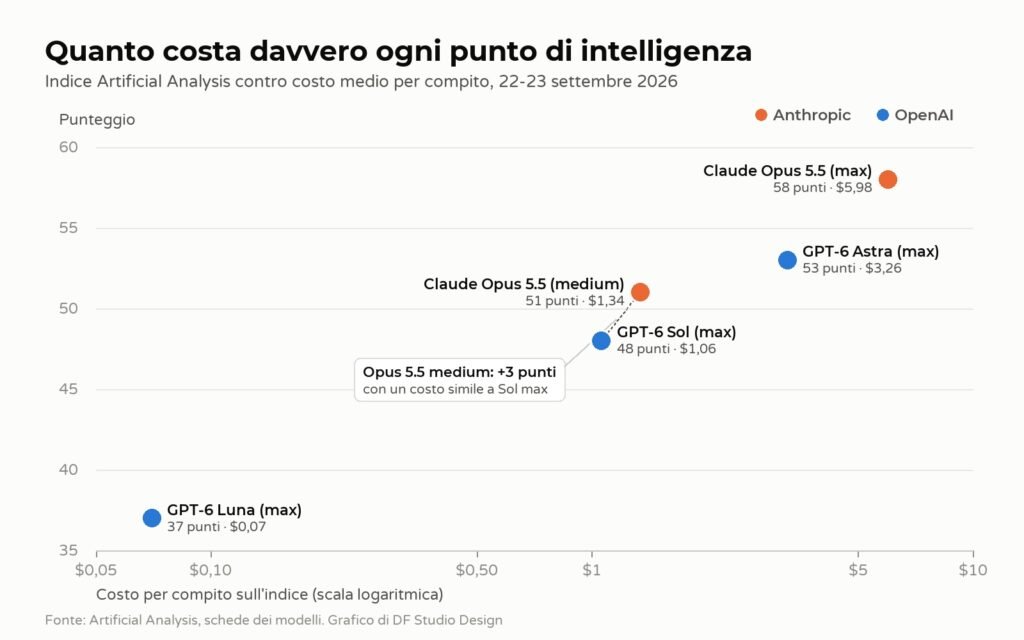
Tre letture, in ordine di importanza.
Opus 5.5 al massimo è il più intelligente ma anche il più caro, più di Astra. Costa meno di Astra a token (20 dollari in uscita contro 50), eppure per completare l’indice ha speso quasi il doppio a compito, perché ha prodotto 260 milioni di token contro 60. Ragiona molto, a volte troppo. Simon Willison, uno degli sviluppatori più seguiti sul tema, ha provato Opus 5.5 al massimo sul suo test preferito, disegnare un pellicano in bicicletta in SVG: il modello ha consumato tutto il tetto di 128.000 token di uscita senza finire il disegno, due volte, a 2,56 dollari e venti minuti a tentativo.
Opus 5.5 al livello medio è la sorpresa. Fa 51 punti spendendo 1,34 dollari a compito e usando appena 38 milioni di token, meno di chiunque altro nella tabella. Sol al massimo fa 48 a 1,06 dollari. Tre punti in più per circa il 26% di spesa in più: se il lavoro è difficile, vale la pena.
Luna gioca un altro campionato. Sette centesimi a compito, quindici volte meno di Sol, con un punteggio che due anni fa sarebbe stato da modello di punta. Per estrarre dati, classificare, riassumere o fare da primo filtro in un agente, è difficile trovare di meglio a quel prezzo.
Un dettaglio meno piacevole per OpenAI arriva da The Decoder: nell’indice Sol sale di un solo punto rispetto a GPT-5.6 Sol (da 47 a 48) e Luna resta ferma a 37. Sul lavoro d’ufficio misurato da GDPval-AA, Sol perde circa 100 punti Elo e Luna circa 75, per risposte presentate peggio e lasciate incomplete. In altre parole, il grosso della novità di Sol e Luna è il prezzo, non l’intelligenza.
Claude Opus 5.5 o GPT-6 Sol: quale scegliere
La scelta giusta dipende dal tipo di lavoro e, quasi più ancora, dal livello di ragionamento che imposti. Te la divido per casi pratici.
- Agenti di programmazione su progetti lunghi, refactoring, migrazioni: Opus 5.5 a livello medio o alto. È dove ha il vantaggio più netto, e a quei livelli non spreca token.
- Agenti con budget stretto, tanti passaggi, automazioni aziendali: Sol. Il costo per compito resta basso anche al massimo, ed è veloce: oltre 130 token al secondo secondo Artificial Analysis.
- Grandi volumi di compiti semplici: Luna. Classificazioni, estrazione di dati da documenti, tag, prime bozze, filtro prima di passare la palla a un modello più forte.
- Il risultato migliore possibile, senza guardare il conto: Opus 5.5 al massimo o Astra. Ma con Opus al massimo imposta sempre un tetto ai token in uscita, altrimenti rischi il pellicano di Willison.
- Lavoro d’ufficio, documenti e presentazioni: Opus 5.5, che guida GDPval-AA con 1.846 Elo, mentre Sol e Luna su quel test sono andati indietro.
Il consiglio pratico che vale per tutti: prima di migrare, prova i modelli sui tuoi compiti veri, dieci o venti esempi tipici, e guarda il costo in fattura, non il listino. Ho spiegato come impostare questo tipo di confronto in stai pagando l’AI dieci volte troppo, e i numeri di questa settimana lo confermano: il modello più economico a token non è automaticamente quello che ti fa spendere meno.
Cosa cambia per chi ha un’azienda o un sito
Per una piccola azienda questi prezzi rendono sostenibili cose che un anno fa erano un lusso: un assistente che risponde ai clienti sul sito, la generazione di schede prodotto, la lettura automatica di preventivi e fatture. Con Luna a 50 centesimi per milione di token in uscita, un chatbot che gestisce migliaia di conversazioni al mese costa meno di un caffè al giorno.
C’è poi un effetto meno visibile ma più importante per chi vive di clienti che arrivano da internet. Più i modelli costano poco, più le risposte generate dall’intelligenza artificiale finiscono dappertutto: nei motori di ricerca, negli assistenti, nelle app. Essere la fonte che questi modelli citano diventa una parte del posizionamento, ed è il lavoro che faccio con la consulenza SEO e GEO. Se invece il tuo sito è su WordPress e vuoi collegarci un assistente o un’automazione, parte tutto da un sito fatto bene, come quelli che realizzo nello sviluppo di siti WordPress.
Cosa ne penso io
Da oltre dieci anni lavoro con siti, SEO e contenuti, e negli ultimi due uso questi modelli ogni giorno, per scrivere codice e per lavorare sui testi. La lezione di questa settimana per me è una: il livello di ragionamento conta quanto il modello. Opus 5.5 al massimo e Opus 5.5 al livello medio sono quasi due prodotti diversi, con un costo che cambia di quattro volte e mezzo per sette punti di differenza.
Sul fronte OpenAI apprezzo la scelta di abbassare i prezzi in modo netto, ma leggo con cautela i grafici del comunicato: confrontarsi con il modello vecchio del concorrente il giorno in cui ne esce uno nuovo è marketing, non misura. Lo stesso vale per Anthropic. Chi decide sulla base dei grafici delle aziende, questa settimana, decide su dati già superati.
Il post che gira sui social chiede “con quale resti?”. La risposta onesta è che non devi restare con uno solo. Per il lavoro difficile uso un modello forte a livello medio, per i compiti ripetitivi un modello piccolo, e cambio quando cambiano i prezzi. È esattamente quello che questa guerra dei prezzi ti permette di fare.
Conclusione
Opus 5.5 è oggi il modello più capace nell’indice indipendente e costa il 20% in meno di Opus 5, ma al massimo ragionamento consuma così tanti token da costare più di GPT-6 Astra a compito. Al livello medio, invece, è il miglior compromesso tra qualità e spesa della settimana. Sol dimezza il prezzo di GPT-5.6 Sol senza un vero salto di intelligenza, e resta la scelta più conveniente per gli agenti a budget. Luna è il modello da volumi, a sette centesimi a compito.
Il numero da guardare non è il prezzo per milione di token, è quanto spendi per portare a termine il tuo compito. E quello lo scopri solo provando.
FAQ
Quanto costa Claude Opus 5.5?
4 dollari per milione di token in entrata e 20 in uscita, con la lettura dalla cache a 20 centesimi. La modalità veloce costa 8 e 40 dollari. Rispetto a Opus 5 è il 20% in meno a token e il 60% in meno sulla cache.
È vero che sono tutti il 50% più economici?
No. Il 50% vale per GPT-6 Sol e Luna rispetto al prezzo promozionale dei GPT-5.6. Opus 5.5 costa il 20% in meno a token rispetto a Opus 5, e Anthropic stima un risparmio del 40% sui carichi di lavoro tipici perché usa meno token.
Qual è il più intelligente dei tre?
Claude Opus 5.5, con 58 punti nell’indice di Artificial Analysis, primo in assoluto. GPT-6 Sol ne fa 48 e GPT-6 Luna 37. Per contesto, GPT-6 Astra e Claude Fable 5.1 sono a 53.
Qual è il più economico da usare davvero?
GPT-6 Luna, a 7 centesimi medi per compito nell’indice. Tra i modelli di fascia alta, Opus 5.5 al livello medio costa 1,34 dollari a compito e Sol al massimo 1,06, mentre Opus 5.5 al massimo arriva a 5,98 dollari.
Posso usare GPT-6 Sol nella chat di ChatGPT?
Non ancora. Al lancio Sol e Luna sono in ChatGPT Work e Codex per gli abbonati Plus, Pro, Business, Enterprise ed Edu, e Luna anche nell’app desktop per gli utenti gratuiti e Go. Nell’API sono disponibili da subito.
Conviene passare da Opus 5 a Opus 5.5?
Nella maggior parte dei casi sì: costa meno, è più veloce e va meglio in quasi tutti i test. Controlla però il livello di ragionamento che usi, perché al massimo Opus 5.5 produce molti più token di Opus 5 e il risparmio può sparire.
Perché i grafici delle due aziende non si confrontano tra loro?
Perché i modelli sono usciti lo stesso giorno: Anthropic si confronta con GPT-6 Astra e GPT-5.6 Sol, OpenAI con Opus 5 e Fable 5.1. Il confronto diretto tra i nuovi modelli, per ora, lo trovi solo nei test indipendenti come quelli di Artificial Analysis.
Leggi anche:
Stai pagando l’AI 10 volte troppo: i 3 modelli che uso io ·
ChatGPT 6 Astra: novità, costi e benchmark ufficiali ·
GPT-6 Astra e Gemini 3.8 Flash a confronto
Fonti
- Anthropic, 22 settembre 2026: l’annuncio di Claude Opus 5.5 con prezzi e benchmark ufficiali.
- Listino della Claude Platform: i prezzi per token, cache e modalità veloce.
- OpenAI, 22 settembre 2026: l’annuncio di GPT-6 Sol e Luna con prezzi, benchmark e disponibilità.
- Artificial Analysis: l’indice indipendente, con le schede di GPT-6 Sol, GPT-6 Luna e GPT-6 Astra.
- The Decoder: i passi avanti e indietro di Sol e Luna rispetto ai GPT-5.6.
- Simon Willison, 22 settembre 2026: la prova pratica dei tre modelli e il consumo di token di Opus 5.5 al massimo.

7 risorse gratuite per sviluppatori: API di AI, database, email
7 risorse gratuite per sviluppatori: API di AI, database, email e monitoraggio Di Daniele Forciniti Queste sono 7 risorse gratuite per sviluppatori…

Gemini 4 Argon: tutte le novità, costi e benchmark
Gemini 4 Argon: tutte le novità, costi e benchmark Di Daniele Forciniti Gemini 4 Argon è il nuovo modello di punta di…
GPT-6.1 Sol: novità, benchmark e costi
GPT-6.1 Sol: novità, benchmark e costi Di Daniele Forciniti GPT-6.1 Sol è il nuovo modello di OpenAI presentato ieri, 29 settembre 2026,…
Gemini 4 Pro in prova su Arena sotto il nome
Gemini 4 Pro in prova su Arena sotto il nome Gemini 3.8 Flash: cosa sappiamo davvero Di Daniele Forciniti Secondo diversi sviluppatori,…
Ricerca multimodale: ora Search Console mostra chi ti trova con
Ricerca multimodale: ora Search Console mostra chi ti trova con una foto Di Daniele Forciniti Dal 24 settembre 2026 Google Search Console…
SEO, AEO, GEO, AIO e SXO: le 5 sigle della
SEO, AEO, GEO, AIO e SXO: le 5 sigle della SEO moderna spiegate in modo semplice Di Daniele Forciniti SEO, AEO, GEO,…