
Gemini 4 Argon: tutte le novità, costi e benchmark
Di Daniele Forciniti
Gemini 4 Argon è il nuovo modello di punta di Google, presentato il 30 settembre 2026. È fatto per i lavori lunghi e complicati (programmazione, finanza, documenti legali e sicurezza informatica), può scrivere fino a 1 milione di token in una sola risposta e al lancio costa 2 dollari per milione di token in entrata e 10 in uscita, un prezzo che poi raddoppia. Per ora però lo usano solo i difensori informatici selezionati da Google nel programma Fairwind: le API a pagamento e gli abbonati Google AI Ultra arriveranno dopo, senza una data.
In questo articolo trovi tutte le novità spiegate in modo semplice, la tabella ufficiale di Google con i 19 benchmark (anche quelli dove perde), il confronto con GPT-6.1 Sol e Claude Opus 5.5 e i costi reali. Visto che quasi nessuno può ancora usarlo, l’ho messo alla prova nell’unico modo serio che c’è oggi: ho messo i numeri di Google accanto ai test indipendenti di Artificial Analysis e Vals AI, e ho rifatto i conti su un lavoro vero da agente.
Perché questa notizia è importante
Per quasi un anno Google è rimasta un passo indietro nella fascia alta. Ha fatto uscire un modello Flash dopo l’altro, cioè la fascia veloce ed economica, mentre OpenAI e Anthropic presentavano i loro modelli di punta. Secondo Artificial Analysis, Argon è il primo modello di Google sopra la fascia Flash da oltre sette mesi, e nel loro indice fa 23 punti in più di Gemini 3.1 Pro.
Con Argon Google torna tra i tre laboratori con i modelli più capaci, insieme a OpenAI e Anthropic. Per chi usa l’AI per lavorare vuol dire più scelta e più concorrenza sui prezzi: il prezzo di lancio di Argon è identico a quello di GPT-6.1 Sol, uscito il giorno prima.
C’è anche un dettaglio che chi segue questo blog riconoscerà. A fine settembre avevo raccontato del modello misterioso provato su Arena sotto il nome Gemini 3.8 Flash, e tra le indiscrezioni c’era un nome in codice: “argon”. Il nome era giusto ed è diventato quello ufficiale. Che il modello provato su Arena fosse proprio Argon, invece, Google non l’ha mai confermato. E nel nome non c’è né “Pro” né “Flash”: Google non ha spiegato la scelta e per ora non ha annunciato altre versioni di Gemini 4.
Cos’è Argon e chi può usarlo oggi
Argon è un modello “di frontiera”, cioè della fascia più alta, sviluppato da Google DeepMind. Google lo descrive come un modello costruito per ragionare a lungo su lavori di molti passaggi: non per rispondere meglio a una domanda, ma per portare a termine un progetto intero.
| Caratteristica | Gemini 4 Argon |
|---|---|
| Presentato | 30 settembre 2026 |
| Risposta massima | 1 milione di token (i Gemini precedenti si fermavano a 64.000) |
| Memoria di lavoro | 1 milione di token, secondo Artificial Analysis |
| Cosa legge | testo, immagini, grafici, documenti e video; risponde con testo |
| Ragionamento | high, il livello più alto disponibile |
| Prezzo di lancio | 2 $ in entrata e 10 $ in uscita per milione di token |
| Prezzo pieno | 4 $ in entrata e 20 $ in uscita, quando finisce la promozione |
| Testo già in cache | sconto del 95% sul prezzo di entrata |
| Disponibilità | solo programma Fairwind e team interni di Google |
Chi lo può usare oggi
Argon arriva solo ai partner del Fairwind Program, il canale con cui Google DeepMind dà accesso anticipato ai suoi modelli più potenti a chi difende reti e infrastrutture. Sulla pagina ufficiale Google parla di oltre 650 partner nel mondo: governi e autorità nazionali di cybersicurezza, chi gestisce servizi essenziali come sanità, telecomunicazioni, energia e finanza, e le grandi piattaforme tecnologiche.
Le regole sono strette. Google verifica la storia delle organizzazioni che fanno domanda, chiede l’accesso con autenticazione a più fattori e permette di usare Argon solo ai team interni di sicurezza, di risposta agli incidenti e di test di penetrazione. Per loro il modello arriva senza i blocchi sui temi informatici, così possono sfruttarlo al massimo per difendersi. Lo possono usare da solo o dentro CodeMender, l’agente di Google che trova e corregge le falle nel codice.
Quando arriva per tutti gli altri
Il calendario annunciato da Google è questo, senza date:
- prima i difensori del programma Fairwind e i team interni di Google;
- poi un gruppo di tester selezionati, che aiutano a rifinire le protezioni;
- poi i clienti a pagamento delle API Gemini e gli abbonati Google AI Ultra;
- infine sviluppatori, aziende e utenti in generale, “il prima possibile”.
Nel frattempo Google partecipa al processo volontario del governo degli Stati Uniti che prevede l’accesso ai modelli prima del lancio. Ho controllato anche la documentazione delle API Gemini: oggi, 2 ottobre, Argon non compare ancora né tra i modelli né nel listino. Se apri l’app Gemini o Google AI Studio, il modello Google più capace che puoi usare resta Gemini 3.8 Flash.
Le novità di Argon spiegate in modo semplice
1. Fino a 1 milione di token in una sola risposta
È la novità più visibile. I token sono i pezzetti di parole con cui l’AI legge e scrive. I modelli Gemini precedenti potevano scrivere al massimo 64.000 token per risposta, Argon arriva a 1 milione: quasi sedici volte tanto. Per darti un’idea delle dimensioni, Artificial Analysis calcola che 1 milione di token corrisponde a circa 1.500 pagine A4 scritte in Arial 12.
Non vuol dire che ti scriverà un romanzo a ogni domanda. Vuol dire che può ragionare molto più a lungo prima di rispondere e produrre in un solo passaggio lavori enormi, come migliaia di righe di codice o un documento lungo con tutte le sue parti. Secondo Google, quando il modello ha lo spazio per generare centinaia di migliaia di token, riesce a risolvere problemi difficili in un colpo solo.
Per gestire risposte così lunghe le API di Gemini hanno una funzione nuova, che Artificial Analysis ha usato nei suoi test: la risposta si mette in pausa e riprende nelle chiamate successive, così non si interrompe per i limiti di tempo.
Il rovescio della medaglia è il consumo. Più il modello scrive e ragiona, più token paghi. Nei test di Artificial Analysis Argon usa in media 62.000 token in uscita per attività, contro i 27.000 di GPT-6 Astra. Ci torno nella parte sui costi, perché è il dettaglio che cambia il conto finale.
2. Programmazione su progetti lunghi e veri
Google dice che i suoi ingegneri usano Argon ogni giorno, dalla correzione dei bug alle grandi migrazioni di codice. Il risultato più forte è su DeepSWE v1.1, il test che fa lavorare l’AI su compiti di sviluppo lunghi e su codice reale: 77,9%, il miglior punteggio pubblicato finora.
L’esempio più concreto è il passaggio dal C e C++ al Rust, un linguaggio che protegge meglio dagli errori nella gestione della memoria, una delle cause più frequenti di falle di sicurezza. Gli agenti Argon ci stanno lavorando su codice che va dalle decine di migliaia di righe di librerie come re2 e libgav1 alle oltre 800.000 righe del kernel Zircon di Fuchsia.
Su libgav1, il decoder video open source di Google, gli agenti hanno sostituito 32.000 righe di codice ottimizzato a mano con Rust sicuro: il risultato è 2,7 volte più veloce della versione Rust di partenza, con un video identico in uscita. Google precisa che queste riscritture passano da controlli automatici e manuali, test e revisioni prima di andare in produzione.
3. Lavoro d’ufficio: finanza, legale, automazioni
Fuori dal codice, Google punta sul lavoro professionale. Argon è primo nel Vals Index, un indice indipendente che misura i modelli su compiti di finanza, programmazione, diritto e fisco, pesando ogni settore per quanto vale nell’economia degli Stati Uniti. Va forte anche nella ricerca finanziaria in più passaggi (Vals Finance Agent v2) e nella ricerca e scrittura legale (Harvey’s Legal Agent Benchmark).
Su AutomationBench, il test di Zapier che misura se un agente porta a termine processi aziendali completi (vendite, marketing, assistenza, finanza, risorse umane), è primo con il 51,3%. Letto al contrario, vuol dire che quasi metà dei processi non va a buon fine nemmeno con il modello migliore: l’automazione completa del lavoro d’ufficio è ancora lontana, ed è meglio saperlo prima di affidare un processo intero a un agente.
4. Grafici, documenti e video lunghi
Argon legge bene anche quello che si vede: analizza grafici professionali, trova dettagli dentro video lunghi e lavora su una serie di documenti. Su LVBench, che misura la comprensione dei video lunghi, fa 91,7%, il miglior risultato registrato. Su Chartography, un test sulla lettura dei grafici, fa 71,6% contro il 66,3% di Claude Opus 5.5.
5. Sicurezza informatica
È il motivo per cui il lancio parte dai difensori. Google ha addestrato Argon per trovare, verificare e correggere da solo le vulnerabilità gravi nel software. Su CWE-bench v1, che misura la capacità di correggere le falle di sicurezza, è primo a pari merito con GPT-6 Astra al 68%. Nel test interno di Google ha trovato vulnerabilità in progetti scritti in 20 linguaggi di programmazione diversi. Nel test di Wiz su siti web attivi, senza accesso al codice sorgente, supera Gemini 3.8 Flash Cyber, il modello di Google specializzato in sicurezza uscito prima.
Il caso concreto lo racconta Wiz, che usa Argon nella sua iniziativa Scan for Good per proteggere gratis infrastrutture pubbliche critiche: in una delle prime prove il modello ha trovato una falla grave in un software sanitario usato da ospedali in tutto il mondo, che esponeva dati personali sensibili. Secondo Google, i modelli precedenti non l’avevano vista.
6. Già al lavoro dentro Google
Google dice che migliaia di dipendenti lo usano già, soprattutto per programmare, fare ricerche approfondite e scrivere. Due esempi:
- Data center: un gruppo di agenti Argon ha analizzato i dati di funzionamento dei server e applicato da solo ottimizzazioni che liberano oltre 300 TiB di memoria, con un risparmio totale stimato tra 500 TiB e 1 PiB.
- Calcolo quantistico: ha aiutato i ricercatori a ridurre le risorse necessarie per alcune parti di algoritmi importanti, battendo in pochi minuti del 40% il miglior risultato pubblicato.
Sono risultati comunicati da Google e non verificati da terzi, ma danno l’idea del tipo di lavoro per cui il modello è pensato.
7. Le protezioni prima del lancio per tutti
Prima di aprirlo a tutti, Google sta rafforzando quattro protezioni:
- Contro gli abusi: il modello rifiuta le richieste utili ad attacchi informatici o con armi chimiche, biologiche, radiologiche e nucleari, ma lascia passare la ricerca scientifica legittima. Google controlla anche l’attività interna del modello per scoprire gli usi sospetti.
- Contro le istruzioni nascoste: sono comandi malevoli infilati dentro una pagina web o un documento per far fare all’AI cose che l’utente non ha chiesto (in gergo, prompt injection indiretta). Secondo Google Argon è il suo modello più resistente e guida il test di Gray Swan su questo tipo di attacchi.
- Contro le iniziative non richieste: un sistema controlla il ragionamento e le azioni del modello e lo ferma se prova a fare più di quello che l’utente voleva.
- Ambienti sigillati: i test più rischiosi si fanno in ambienti isolati e chiusi.
Per chi gestisce un sito o un’azienda il punto più pratico è il secondo: un agente che naviga e legge documenti al posto tuo è esposto proprio a questo tipo di trappole.
I benchmark ufficiali di Google, spiegati uno per uno
Google ha pubblicato una tabella con 19 risultati, confrontando Argon con GPT-6 Astra, Claude Fable 5.1 e Claude Opus 5.5. I numeri di Argon sono calcolati da Google con il ragionamento al massimo; quelli degli altri vengono dalle classifiche pubbliche o dai dati dichiarati dalle aziende, come spiega la nota ufficiale sul metodo. GPT-6.1 Sol non c’è, perché è uscito il giorno prima: lo confronto più sotto con i test indipendenti. In grassetto il migliore di ogni riga.
| Area | Test | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|---|
| Lavoro d’ufficio | Vals Index | 68,9% | 63,1% | 65,8% | 67,0% |
| Lavoro d’ufficio | AutomationBench | 51,3% | 41,4% | 31,4% | 42,5% |
| Lavoro d’ufficio | Vals Finance Agent v2 | 65,4% | 53,5% | 58,9% | 58,6% |
| Lavoro d’ufficio | Harvey’s Legal Agent | 19,6% | 5,4% | 6,7% | 3,8% |
| Programmazione | DeepSWE v1.1 | 77,9% | 74,1% | 67,4% | 74,2% |
| Programmazione | FrontierSWE v2 | 55,0% | 65,5% | 56,3% | 62,3% |
| Programmazione | Vibe Code Bench | 91,9% | 89,6% | 90,3% | 90,3% |
| Programmazione | Terminal-bench 4.0 | 57,4% | 58,2% | 57,9% | 66,4% |
| Machine learning | PostTrainBench | 45,3% | 44,3% | 40,2% | 49,3% |
| Scienza | Terminal-Bench Science 0.1 | 57,6% | 68,1% | 52,6% | 63,3% |
| Scienza | LABBench 2 | 88,8% | 85,4% | 68,6% | 73,1% |
| Matematica | RiemannBench | 76,0% | 72,0% | 65,6% | 69,6% |
| Testi lunghi | GraphWalks fino a 128.000 token | 99,7% | 98,7% | 91,4% | 90,6% |
| Testi lunghi | GraphWalks da 256.000 a 1 milione | 84,2% | 71,8% | 65,0% | 66,8% |
| Uso del computer | Agent’s Last Exam | 39,5% | 34,2% | n.d. | 38,2% |
| Uso del computer | OSWorld-2.0 (parte offline) | 69,2% | 72,6% | n.d. | n.d. |
| Immagini e video | Chartography | 71,6% | 71,0% | 46,2% | 66,3% |
| Immagini e video | LVBench | 91,7% | 87,5% | 79,7% | 83,7% |
| Sicurezza | CWE-bench v1 | 68,0% | 68,0% | 58,0% | 67,0% |
Il conto finale: Argon è primo da solo in 13 test su 19, primo a pari merito in uno (CWE-bench) e dietro in 5. Vediamo cosa misurano, in parole semplici.
Dove vince
- Lavoro d’ufficio: oltre al Vals Index e ad AutomationBench, vince nella ricerca finanziaria (65,4%) e soprattutto nel test legale di Harvey, che chiede di fare ricerche e scrivere documenti come in uno studio legale: 19,6% contro il 6,7% del secondo, Fable 5.1. I punteggi sono bassi per tutti, ma è il distacco più netto della tabella.
- Programmazione: DeepSWE v1.1 (77,9% contro il 74,2% di Opus) e Vibe Code Bench, che misura se l’AI sa costruire un’applicazione funzionante partendo da una descrizione (91,9%).
- Scienza e matematica: LABBench 2, ricerca in biologia con strumenti veri e accesso a internet (88,8%), e RiemannBench, matematica avanzata (76,0%).
- Testi lunghissimi: GraphWalks verifica se il modello riesce a seguire i collegamenti dentro testi enormi. Fino a 128.000 token sono bravi tutti; tra 256.000 e 1 milione di token Argon fa 84,2% e il secondo, Astra, si ferma al 71,8%.
- Uso del computer: Agent’s Last Exam, una serie di lavori lunghi da portare a termine al computer (39,5% contro il 38,2% di Opus).
- Immagini e video: Chartography, sulla lettura dei grafici (71,6%), e LVBench, sui video lunghi (91,7%).
Dove perde
- FrontierSWE v2 (programmazione molto difficile): 55,0% contro il 65,5% di Astra e il 62,3% di Opus. È la sconfitta più netta, dieci punti e mezzo.
- Terminal-bench 4.0 (lavorare dal terminale, cioè scrivendo comandi invece di cliccare): 57,4% contro il 66,4% di Opus.
- PostTrainBench (addestrare e migliorare altri modelli di AI): 45,3% contro il 49,3% di Opus.
- Terminal-Bench Science (ricerca scientifica dal terminale): 57,6% contro il 68,1% di Astra.
- OSWorld-2.0 (usare il computer come una persona, tra programmi e finestre): 69,2% contro il 72,6% di Astra.
Messo in fila, il quadro è chiaro: Argon è il più forte sul lavoro d’ufficio, sui testi lunghissimi e sui video, mentre nella programmazione più dura e nei lavori dal terminale Opus 5.5 e Astra restano avanti.
Gemini 4 Argon contro GPT-6.1 Sol e Claude Opus 5.5
Per confrontare modelli di aziende diverse mi fido poco delle tabelle delle aziende stesse: ognuna sceglie i test e le impostazioni. Per questo qui uso solo test indipendenti, fatti da terzi con lo stesso metodo per tutti. I due rivali sono GPT-6.1 Sol, il modello di fascia media che OpenAI ha presentato il 29 settembre, quasi al livello di Astra a un quinto del prezzo, e Claude Opus 5.5 di Anthropic, oggi primo nell’indice di Artificial Analysis. Argon è misurato con il ragionamento high, il massimo disponibile; GPT-6.1 Sol e Opus 5.5 al massimo.
Gli stessi test, con lo stesso metodo
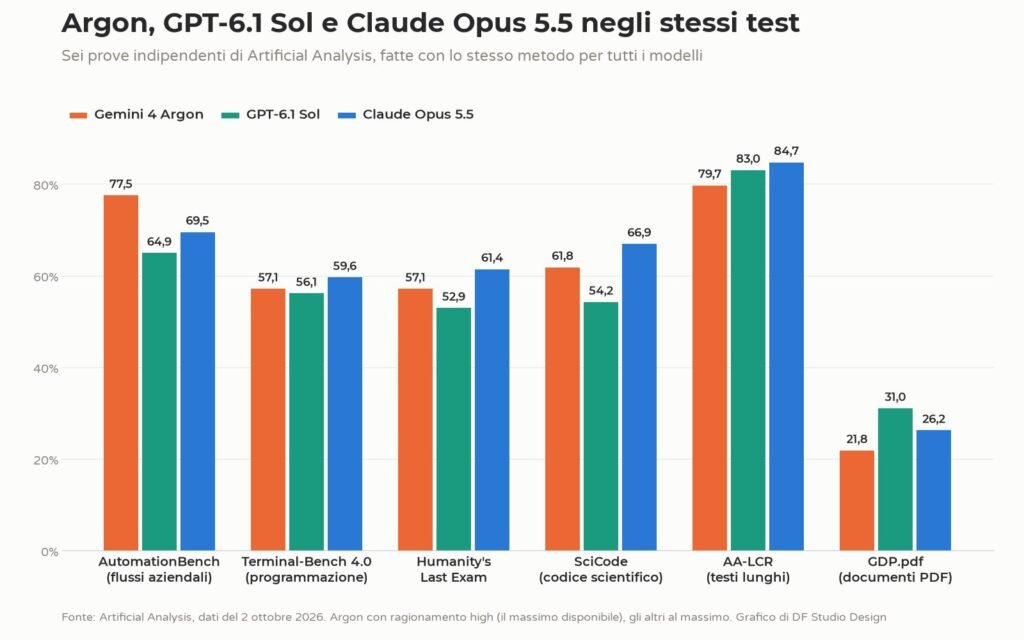
| Test | Cosa misura | Gemini 4 Argon | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|---|---|
| AutomationBench | processi aziendali completi tra più applicazioni | 77,5% | 64,9% | 69,5% |
| Terminal-Bench 4.0 | programmazione dal terminale | 57,1% | 56,1% | 59,6% |
| Humanity’s Last Exam | domande difficilissime di ragionamento e conoscenza | 57,1% | 52,9% | 61,4% |
| SciCode | codice per la ricerca scientifica | 61,8% | 54,2% | 66,9% |
| AA-LCR | ragionare su documenti molto lunghi | 79,7% | 83,0% | 84,7% |
| GDP.pdf | domande di lavoro su PDF complessi | 21,8% | 31,0% | 26,2% |
| Intelligence Index | media di 10 test | 53 | 52 | 58 |
- Argon contro GPT-6.1 Sol: Argon vince in 4 test su 6, con il distacco più grande nelle automazioni aziendali (quasi 13 punti). Sol vince sui documenti lunghi e soprattutto sui PDF complessi. Nell’indice generale sono praticamente pari: 53 a 52.
- Argon contro Opus 5.5: Opus vince in 5 test su 6 e resta il più capace nell’indice, con 58 punti. Argon lo batte solo nelle automazioni aziendali, dove però il distacco è netto: 8 punti.
Una nota per chi confronta le due tabelle: su Terminal-Bench 4.0 Google dà a Opus 5.5 il 66,4%, Artificial Analysis il 59,6%. Non è un errore: Google riporta il miglior risultato della classifica ufficiale, Artificial Analysis rifà il test con le sue condizioni. È il motivo per cui i numeri vanno sempre letti insieme a chi li ha prodotti.
Il test sul lavoro professionale: Vals Index
Vals AI misura i modelli su compiti di finanza, programmazione, diritto e fisco, con test in gran parte privati. Qui Argon è primo su 41 modelli. Al secondo posto c’è Claude Sonnet 5.5 con il 67,04%; nella tabella metto i modelli di cui parliamo in questo articolo:
| Modello | Punteggio | Costo per test | Durata |
|---|---|---|---|
| Gemini 4 Argon | 68,90% | 15,68 $ | 46 minuti |
| Claude Opus 5.5 | 66,97% | 32,14 $ | 1 ora e 19 minuti |
| GPT-6 Astra | 63,13% | 18,46 $ | 28 minuti |
| GPT-6.1 Sol | 61,15% | 3,24 $ | 43 minuti |
Vals calcola il costo di Argon con il prezzo pieno (4 e 20 dollari), non con quello di lancio. Anche così costa meno della metà di Opus 5.5 per un punteggio più alto. GPT-6.1 Sol resta un’altra storia sul prezzo: costa quasi cinque volte meno di Argon, con 7,75 punti in meno.
Intelligenza e costo per attività
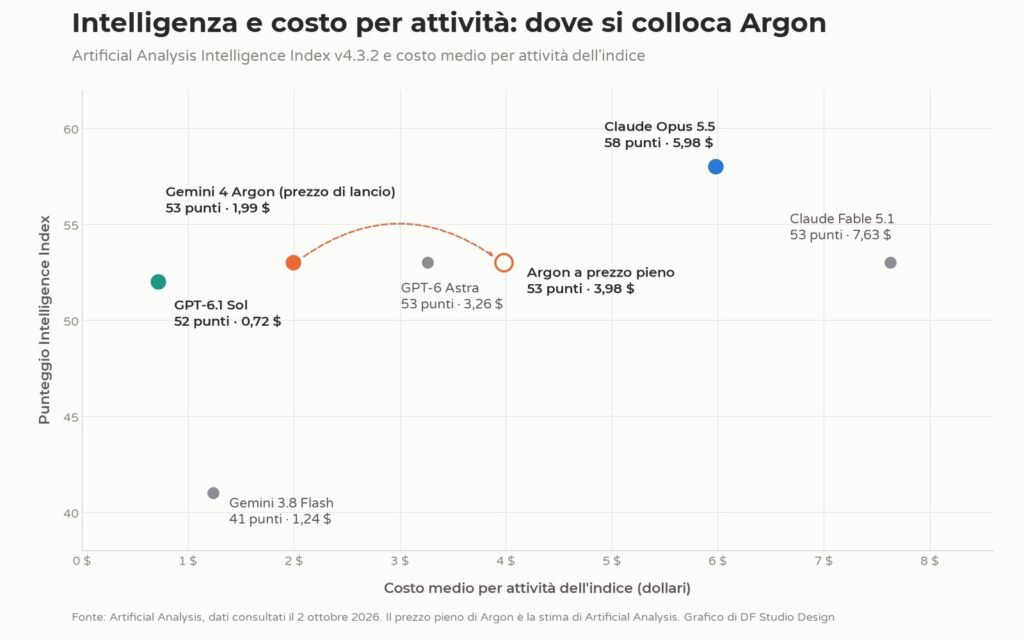
Artificial Analysis riassume 10 test in un solo indice e misura quanto costa, in media, far fare al modello ogni attività. Argon prende 53 punti, come GPT-6 Astra e uno sopra GPT-6.1 Sol. Opus 5.5 resta davanti con 58.
Sul costo il quadro cambia. Al prezzo di lancio Argon costa 1,99 dollari per attività: il 60% di Astra, ma 2,7 volte GPT-6.1 Sol, che ne costa 0,72. Quando finisce la promozione, secondo la stima di Artificial Analysis, salirà a 3,98 dollari: più di Astra e circa due terzi di Opus 5.5, che costa 5,98 dollari.
Il dato più interessante: Argon inventa meno
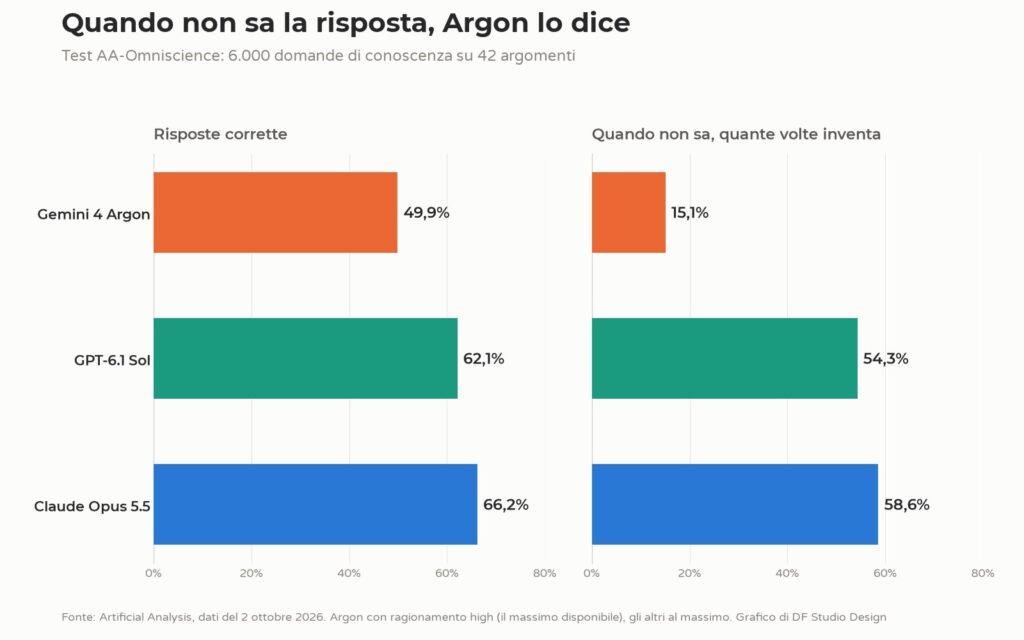
Nel test AA-Omniscience, 6.000 domande di conoscenza su 42 argomenti, Artificial Analysis misura due cose: quante risposte sono giuste e quante volte il modello, quando non sa la risposta, ne inventa una invece di dire “non lo so”.
Argon inventa nel 15,1% dei casi, il valore più basso tra i modelli di questo livello. GPT-6.1 Sol arriva al 54,3% e Opus 5.5 al 58,6%.
Va letto bene, però. Argon risponde giusto solo al 49,9% delle domande, contro il 62,1% di Sol e il 66,2% di Opus. Il motivo è che si lancia molto meno spesso: risponde nel 61% dei casi, gli altri sopra l’84%. In pratica sa meno cose a memoria, ma quando non è sicuro lo dice. Nel punteggio complessivo del test, che premia le risposte giuste e penalizza quelle inventate, i tre finiscono vicini: Opus 46, Argon 42, Sol 42.
Per chi usa l’AI per scrivere contenuti o fare ricerche è una differenza pratica: meglio un “non lo so” che un dato inventato scritto con sicurezza. Vuol dire anche, però, che con Argon le ricerche vanno fatte con la ricerca web attiva, perché da solo ricorda meno cose degli altri.
Quanto costa davvero
Il listino ufficiale nelle API, in dollari per milione di token:
| Voce | Prezzo di lancio | Dopo la promozione |
|---|---|---|
| Entrata | 2 $ | 4 $ |
| Entrata già in cache | 0,10 $ | 0,20 $ |
| Uscita | 10 $ | 20 $ |
Tre cose da sapere, che nei comunicati si leggono poco:
- Quanto dura la promozione non si sa. Google non l’ha detto. Artificial Analysis scrive che il prezzo scontato varrà “almeno un mese”.
- Argon si mette in mezzo ai due rivali. Il prezzo di lancio è identico a quello di GPT-6.1 Sol, quello pieno è identico a quello di Claude Opus 5.5.
- Il listino completo non c’è ancora. Nella documentazione delle API mancano le voci che di solito fanno la differenza, come eventuali prezzi diversi per le richieste molto lunghe o gli sconti per i lavori non urgenti.
Il confronto dei listini
| Modello | Entrata | Uscita |
|---|---|---|
| Gemini 3.8 Flash (fino al 31 dicembre) | 0,75 $ | 3,75 $ |
| GPT-6.1 Sol | 2 $ | 10 $ |
| Gemini 4 Argon, prezzo di lancio | 2 $ | 10 $ |
| Gemini 4 Argon, prezzo pieno | 4 $ | 20 $ |
| Claude Opus 5.5 | 4 $ | 20 $ |
| GPT-6 Astra | 10 $ | 50 $ |
| Claude Fable 5.1 | 10 $ | 50 $ |
Un conto su un lavoro vero
Ho rifatto lo stesso conto dell’articolo su GPT-6.1 Sol, così i numeri si possono confrontare: un agente che fa 1.000 richieste da 20.000 token in entrata, di cui 16.000 già in cache perché rilegge lo stesso contesto, e 2.000 token in uscita. Senza contare la scrittura iniziale in cache:
| Modello | Costo di 1.000 richieste |
|---|---|
| Gemini 4 Argon, prezzo di lancio | 29,60 $ |
| GPT-6.1 Sol | 29,60 $ |
| Gemini 4 Argon, prezzo pieno | 59,20 $ |
| Claude Opus 5.5 | 59,20 $ |
| GPT-6 Astra | 156,00 $ |
Sulla carta, quindi, Argon al lancio costa come GPT-6.1 Sol. Ma il conto parte dall’ipotesi che tutti scrivano 2.000 token per risposta, e non è così. Argon è un modello che ragiona a lungo: per completare l’indice di Artificial Analysis ha prodotto 110 milioni di token in uscita, contro i 67 milioni di GPT-6.1 Sol. Opus 5.5 invece ne ha prodotti 260 milioni, più del doppio di Argon.
Per questo, sullo stesso lavoro, il costo che conta è quello per attività: 0,72 dollari per GPT-6.1 Sol, 1,99 per Argon al lancio, 3,98 per Argon a prezzo pieno e 5,98 per Opus 5.5. A parità di listino Argon costa quasi tre volte GPT-6.1 Sol, perché scrive di più.
Il consiglio pratico, per un’azienda, è semplice: quando sarà disponibile, provalo sui tuoi lavori veri e guarda la fattura, non il listino.
Cosa non sappiamo ancora
- Quando arriverà nelle API, in Google AI Ultra e nell’app Gemini: Google non ha dato date.
- Se e quando arriverà per chi usa Gemini in Italia, e con quali limiti di utilizzo.
- Quanto durerà il prezzo di lancio.
- Se ci saranno altre versioni di Gemini 4, per esempio più piccole ed economiche.
- Come si comporta sul lavoro vero. Bloomberg ha raccolto i dubbi di alcuni dipendenti di Google, secondo cui in certi compiti di programmazione il modello non è all’altezza dei benchmark; Google ha risposto che i suoi team lo usano molto e con buoni risultati. Lo capiremo solo quando potremo provarlo in tanti.
Per chi è davvero utile
Argon ha senso soprattutto per:
- Team di sicurezza informatica: oggi sono gli unici che possono usarlo, e il modello è stato addestrato proprio per loro.
- Aziende con agenti che fanno lavori lunghi: automazioni tra più applicazioni, ricerche finanziarie e legali, migrazioni di codice. È dove Argon vince anche nei test indipendenti.
- Chi lavora con video lunghi, grafici e documenti enormi: il distacco su LVBench e GraphWalks è netto.
- Chi ha bisogno di risposte affidabili su fatti e dati: inventa molto meno degli altri, a patto di dargli accesso al web.
Per ora non serve, invece, a:
- Chi usa l’AI per scrivere, riassumere e chattare tutti i giorni: oggi non può usarlo, e per questi lavori Gemini 3.8 Flash, GPT-6.1 Sol o Claude bastano.
- Chi guarda prima di tutto al budget: GPT-6.1 Sol fa quasi lo stesso punteggio generale a circa un terzo del costo per attività.
- Chi programma su progetti molto difficili o lavora tanto dal terminale: lì Opus 5.5 e Astra restano davanti.
La mia opinione dopo averlo messo alla prova sui numeri
Lavoro con siti web, SEO e contenuti da oltre dieci anni, e negli ultimi due anni l’AI è entrata nel mio lavoro di tutti i giorni: la uso per scrivere codice, controllare siti e analizzare dati. Su Argon non posso raccontarti una prova diretta, perché oggi Google lo dà solo ai difensori informatici. Ho fatto la cosa più onesta che si può fare adesso: ho preso i 19 numeri di Google e li ho messi accanto ai test di chi non ha interessi in gioco, poi ho rifatto i conti dei costi.
Due cose mi hanno sorpreso. La prima è il dato sulle risposte inventate: un modello che dice “non lo so” invece di inventare è quello che chiedo di più a un’AI quando la uso per lavoro, e su questo oggi Argon non ha rivali. La seconda è il costo: il prezzo di lancio fa notizia, ma Argon scrive tanto, e sullo stesso lavoro costa quasi tre volte GPT-6.1 Sol. Quando lo sconto finisce, la differenza raddoppia.
Detto questo, Google è tornata davvero. Argon non è il più intelligente in assoluto, perché nell’indice indipendente Opus 5.5 resta davanti, ma è il migliore sul lavoro d’ufficio e sui testi lunghissimi, e inventa molto meno degli altri. Chi lavora sulla visibilità nelle risposte delle AI, come faccio io con la consulenza SEO e GEO, farebbe bene a tenerlo d’occhio: la mia impressione è che modelli così prudenti avranno ancora più bisogno di trovare sul web fonti chiare e verificabili da citare.
Conclusione
Gemini 4 Argon è il ritorno di Google tra i modelli di punta: primo sul lavoro professionale secondo Vals, pari a GPT-6 Astra nell’indice di Artificial Analysis, fortissimo sui testi lunghi e sui video, e con il tasso di risposte inventate più basso tra i modelli di questo livello. Nella programmazione più dura e nei lavori dal terminale Claude Opus 5.5 e GPT-6 Astra restano davanti, e GPT-6.1 Sol fa quasi lo stesso punteggio generale spendendo molto meno.
Il limite più grande oggi è un altro: quasi nessuno può usarlo. Finché non arriva nelle API e in Google AI Ultra, i numeri restano numeri. Quando arriverà, la prova che conta sarà sui propri lavori veri, guardando la fattura oltre al punteggio.
FAQ
Cos’è Gemini 4 Argon?
È il nuovo modello di punta di Google DeepMind, presentato il 30 settembre 2026. È pensato per i lavori lunghi e complessi: programmazione, finanza, legale e sicurezza informatica. Può scrivere fino a 1 milione di token in una sola risposta.
Posso già usare Argon?
No, a meno che la tua organizzazione non faccia parte del programma Fairwind di Google, riservato a governi, infrastrutture critiche e grandi piattaforme tecnologiche. Dopo arriverà ai clienti a pagamento delle API Gemini e agli abbonati Google AI Ultra, ma Google non ha dato date.
Quanto costa Gemini 4 Argon?
Nelle API costa 2 dollari per milione di token in entrata e 10 in uscita durante la promozione di lancio, poi 4 e 20 dollari. Il testo già in cache ha uno sconto del 95% sul prezzo di entrata. Google non ha detto quanto dura la promozione.
Gemini 4 Argon è meglio di GPT-6.1 Sol e Claude Opus 5.5?
Dipende dal lavoro. Nei test indipendenti di Artificial Analysis batte GPT-6.1 Sol in 4 prove su 6 ed è primo nelle automazioni aziendali, ma Claude Opus 5.5 resta più capace nel complesso. GPT-6.1 Sol costa circa un terzo per attività.
Cosa vuol dire 1 milione di token in uscita?
Che il modello può ragionare e scrivere molto più a lungo in una sola risposta: prima il limite dei modelli Gemini era 64.000 token. Serve per lavori enormi, come migrazioni di codice o documenti lunghi, ma più token vuol dire anche una spesa più alta.
Perché si chiama Argon?
Google non l’ha spiegato. “Argon” era il nome in codice che circolava già a metà settembre tra chi segue i test dei modelli, ed è diventato il nome ufficiale. Per ora Google non ha annunciato versioni Pro o Flash di Gemini 4.
Leggi anche:
ChatGPT 6 Astra: novità, costi e benchmark ufficiali ·
GPT-6 Astra e Gemini 3.8 Flash: benchmark ufficiali, prezzi veri e quale conviene ·
Claude Fable 5.1 e Mythos 5.1: benchmark, prezzi e taglio del 75%
Fonti
- Google, Gemini 4 Argon: our next era of frontier intelligence, 30 settembre 2026: novità, prezzi e disponibilità.
- Google DeepMind, Gemini 4 Argon Model evaluation: metodo e tabella dei 19 benchmark.
- Google DeepMind, Fairwind Program: chi può usare Argon oggi e con quali regole.
- Artificial Analysis, analisi di Gemini 4 Argon, 30 settembre 2026: test indipendenti, costo per attività e risposte inventate.
- Vals AI, Vals Index: la classifica sul lavoro professionale.
- Bloomberg, 30 settembre 2026: i dubbi di alcuni dipendenti di Google.

7 risorse gratuite per sviluppatori: API di AI, database, email
7 risorse gratuite per sviluppatori: API di AI, database, email e monitoraggio Di Daniele Forciniti Queste sono 7 risorse gratuite per sviluppatori…

GPT-6.1 Sol: novità, benchmark e costi
GPT-6.1 Sol: novità, benchmark e costi Di Daniele Forciniti GPT-6.1 Sol è il nuovo modello di OpenAI presentato ieri, 29 settembre 2026,…
Gemini 4 Pro in prova su Arena sotto il nome
Gemini 4 Pro in prova su Arena sotto il nome Gemini 3.8 Flash: cosa sappiamo davvero Di Daniele Forciniti Secondo diversi sviluppatori,…
Ricerca multimodale: ora Search Console mostra chi ti trova con
Ricerca multimodale: ora Search Console mostra chi ti trova con una foto Di Daniele Forciniti Dal 24 settembre 2026 Google Search Console…
SEO, AEO, GEO, AIO e SXO: le 5 sigle della
SEO, AEO, GEO, AIO e SXO: le 5 sigle della SEO moderna spiegate in modo semplice Di Daniele Forciniti SEO, AEO, GEO,…
Claude Opus 5.5, GPT-6 Sol e Luna: prezzi e benchmark
Claude Opus 5.5, GPT-6 Sol e Luna: prezzi e benchmark a confronto Di Daniele Forciniti Il 22 settembre 2026 Anthropic ha pubblicato…