
GPT-6.1 Sol: novità, benchmark e costi
Di Daniele Forciniti
GPT-6.1 Sol è il nuovo modello di OpenAI presentato ieri, 29 settembre 2026, al DevDay. È un aggiornamento di GPT-6 Sol che, secondo OpenAI, arriva quasi al livello di GPT-6 Astra nella programmazione, nell’uso del computer e nel lavoro professionale, allo stesso prezzo di Sol: 2 dollari per milione di token in entrata e 10 in uscita, cioè un quinto di Astra. Lo usi in ChatGPT Work e in Codex con gli abbonamenti Plus, Pro, Business, Enterprise ed Edu, e nelle API con il nome gpt-6.1-sol. Nella Chat normale per ora non c’è.
In questo articolo metto insieme tutto quello che serve per capirlo davvero: cosa cambia rispetto a GPT-6 Sol, i benchmark ufficiali spiegati uno per uno (anche dove perde), cosa dicono i test indipendenti, quanto costa con esempi concreti, cosa dice la scheda di sicurezza e perché OpenAI ha presentato Sol invece di un nuovo Astra.
Perché questa notizia è importante
Il punto non è un modello in più. Il punto è il rapporto tra quello che fa e quello che costa. Una settimana fa OpenAI aveva lanciato GPT-6 Sol e Luna, e li avevo messi a confronto nell’articolo su prezzi e benchmark di Claude Opus 5.5, GPT-6 Sol e Luna. Sette giorni dopo arriva una versione di Sol che, a parità di prezzo, si avvicina al modello di punta.
Per chi usa l’AI tutti i giorni questo si traduce in una cosa semplice: molti lavori che prima richiedevano Astra, e quindi una spesa cinque volte più alta, ora si possono fare con Sol. Vale soprattutto per gli agenti, cioè i sistemi che lavorano da soli per molti passaggi di fila e consumano tanti token. Lì il costo per attività conta più del prezzo al token, e GPT-6.1 Sol è stato pensato proprio per abbassarlo.
C’è anche un retroscena. Il giorno prima del DevDay, secondo il Wall Street Journal, OpenAI ha rinunciato a pubblicare GPT-6.1 Astra dopo un peggioramento nei test di sicurezza interni. Lo vediamo più avanti.
Cos’è GPT-6.1 Sol e dove si usa
Nella famiglia GPT-6 ci sono tre fasce: Astra, il modello più capace e più caro; Sol, la fascia media; Luna, veloce ed economico per il lavoro di tutti i giorni. GPT-6.1 Sol sostituisce GPT-6 Sol come modello di fascia media. Astra resta, come scrive la stessa OpenAI, il modello più capace nel complesso. Se vuoi ripassare cosa sa fare Astra, l’ho raccontato nell’articolo su ChatGPT 6 Astra.
Dove lo trovi:
- ChatGPT Work e Codex: disponibile da ieri per gli utenti Plus, Pro, Business, Enterprise ed Edu.
- Chat di ChatGPT: non ancora. OpenAI scrive che questi modelli non sono ancora disponibili in Chat.
- API di OpenAI: con il nome
gpt-6.1-sol, secondo la documentazione per sviluppatori.
Le caratteristiche tecniche principali, dalla documentazione ufficiale:
| Caratteristica | GPT-6.1 Sol |
|---|---|
| Finestra di contesto | 1.050.000 token (fino a 922.000 in entrata) |
| Risposta massima | 128.000 token |
| Conoscenze aggiornate al | 30 aprile 2026 |
| Livelli di ragionamento | low, medium (predefinito), high, xhigh, max |
| Cosa legge e cosa produce | legge testo e immagini, risponde con testo |
| Strumenti nelle API | ricerca web, ricerca nei file, generazione di immagini, esecuzione di codice, uso del computer, MCP e altri |
Un dettaglio che interessa chi sviluppa: GPT-6 Sol aveva anche il livello di ragionamento none, cioè nessun ragionamento, come si vede nella sua pagina tecnica. GPT-6.1 Sol parte da low. Se nelle tue applicazioni usavi Sol senza ragionamento per avere risposte istantanee, prima di passare al nuovo modello conviene fare una prova.
Le novità rispetto a GPT-6 Sol
- Programmazione: nel test DeepSWE supera il miglior risultato di GPT-6 Sol di 6,4 punti e raggiunge Astra.
- Lavoro su documenti e flussi aziendali: legge meglio PDF complessi, con tabelle e grafici, e completa meglio i processi in più fasi.
- Uso del computer: quando deve usare programmi e finestre come farebbe una persona, fa 7 punti in più di GPT-6 Sol a meno della metà del costo.
- Ricerca scientifica: più che raddoppia il punteggio di GPT-6 Sol nel test Terminal-Bench Science.
- Meno errori sui fatti: con ragionamento basso, le risposte con almeno un errore passano dall’11,4% al 7,7%.
- Più onesto sui propri limiti: segnala più spesso quando uno strumento non funziona invece di inventare una risposta.
- Cache a metà prezzo: il testo già letto e salvato in memoria costa 0,10 dollari per milione di token, contro i 0,20 di GPT-6 Sol.
I benchmark di GPT-6.1 Sol, spiegati uno per uno
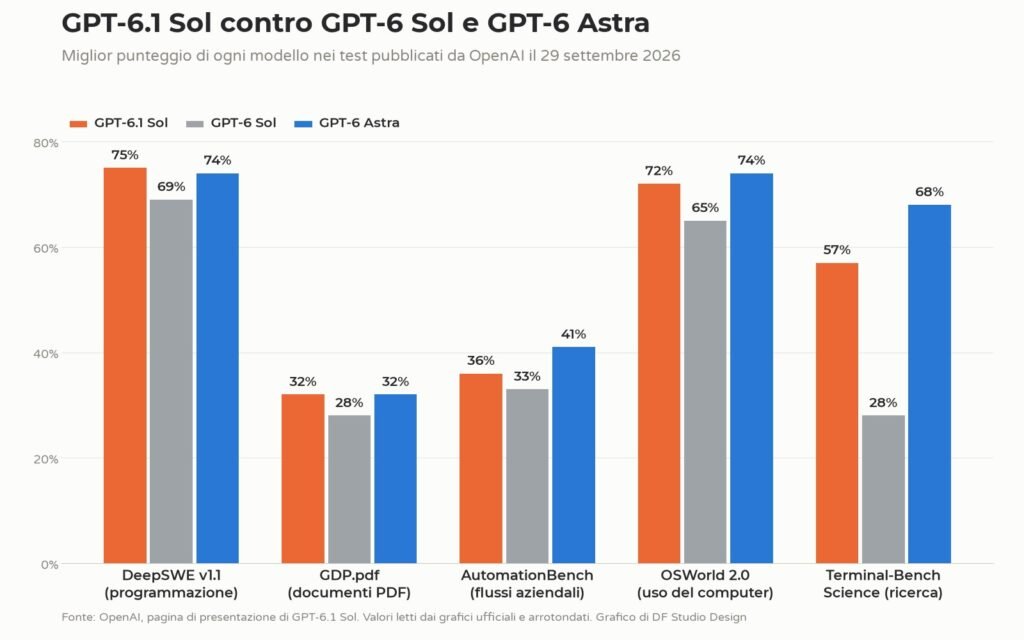
OpenAI ha pubblicato i risultati sotto forma di grafici che mettono in relazione il punteggio con il costo per attività. È il modo giusto di leggerli: un modello che fa due punti in più ma costa sette volte tanto non è per forza la scelta migliore. I numeri qui sotto li ho letti dai grafici della presentazione ufficiale, arrotondati, e li ho incrociati con le percentuali che OpenAI scrive nel testo.
DeepSWE v1.1: programmazione su progetti veri
DeepSWE fa lavorare l’AI su compiti di sviluppo software nuovi, su codice reale, che richiedono lunghe sequenze di operazioni. GPT-6.1 Sol arriva intorno al 75%, contro il 74% circa di Astra e il 69% di GPT-6 Sol. La cosa che colpisce è il costo: il suo risultato migliore arriva a circa 60 centesimi per attività, mentre Astra per stare su quei livelli spende da 3 a oltre 7 dollari. OpenAI parla di un quinto del costo, e dal grafico il conto torna.
GDP.pdf: domande professionali su PDF complessi
Qui i modelli devono rispondere a domande di lavoro vere usando PDF pieni di tabelle, grafici e scritte piccole, in ambiti come finanza, sanità e legale. GPT-6.1 Sol arriva al 32%, praticamente come Astra (32% circa) ma a circa 35 centesimi per attività invece di quasi 2 dollari. Supera anche Claude Opus 5.5 con fallback (circa 29%), che costa più del doppio. I punteggi sono bassi per tutti: è un test molto difficile, e dice che sui documenti complessi l’AI va ancora controllata.
AutomationBench: flussi di lavoro aziendali
AutomationBench mette gli agenti davanti a processi completi in vendite, marketing, assistenza, finanza e risorse umane, con 47 strumenti a disposizione. Con ragionamento medio GPT-6.1 Sol fa 2,2 punti più di Opus 5.5 a circa un terzo del costo, e 4,8 punti più di GPT-6 Sol. Il suo massimo è intorno al 36%, a circa 30 centesimi per attività.
Qui però va detta anche l’altra metà. Salendo con il ragionamento, Opus 5.5 con fallback arriva intorno al 42% e Astra intorno al 41%, spendendo da 1,40 a 1,70 dollari per attività. Quindi su questo test GPT-6.1 Sol vince sul rapporto qualità prezzo, non sul punteggio assoluto. Se ti serve il massimo in automazioni complesse, Opus e Astra restano più avanti.
OSWorld 2.0: usare il computer come una persona
OSWorld verifica se un agente sa portare a termine lavori lunghi al computer, aprendo programmi, compilando campi e passando da una finestra all’altra. Al massimo ragionamento GPT-6.1 Sol arriva intorno al 72%, 7 punti sopra GPT-6 Sol e 2,1 punti sotto Astra (circa 74%). Il costo è la parte interessante: circa 1,30 dollari per attività contro oltre 9 dollari di Astra, cioè circa un settimo.
Terminal-Bench Science: ricerca scientifica
Qui gli agenti fanno analisi di dati, simulazioni e dimostrazioni usando il terminale. GPT-6.1 Sol arriva intorno al 57% e più che raddoppia GPT-6 Sol (circa 28%). Costa in media 5,47 dollari per attività, contro 23,80 di Astra e 23,21 di Opus 5.5. Però qui i due modelli più cari fanno meglio: Astra arriva al 68,1% e Opus 5.5 con fallback intorno al 63%. OpenAI stessa scrive che Astra resta il modello da usare per la ricerca scientifica più difficile.
Una nota di coerenza con quello che avevo scritto la settimana scorsa. Nell’articolo su Opus 5.5 riportavo i dati di Anthropic, che su questo test dava Opus 5.5 al 58,7% e Astra al 64,6%. OpenAI misura Astra al 68,1% e Opus intorno al 63%. Stesso test, impostazioni diverse: ogni azienda misura con le proprie condizioni, ed è il motivo per cui i numeri vanno sempre letti insieme a chi li ha prodotti.
Accuratezza sui fatti
OpenAI ha misurato quante risposte contengono almeno un errore fattuale su conversazioni in cui gli utenti avevano già segnalato un errore di un modello precedente, quindi su domande scelte apposta per mettere in difficoltà. Con ragionamento basso GPT-6.1 Sol scende dall’11,4% al 7,7% di risposte con errori, circa un terzo in meno. Al ragionamento molto alto arriva al 4,1%, contro il 4,5% di GPT-6 Sol e il 4,0% di Astra, con un costo per attività inferiore di circa l’83% rispetto ad Astra. OpenAI precisa che nell’uso normale gli errori sono più rari.
Cosa dicono i test indipendenti
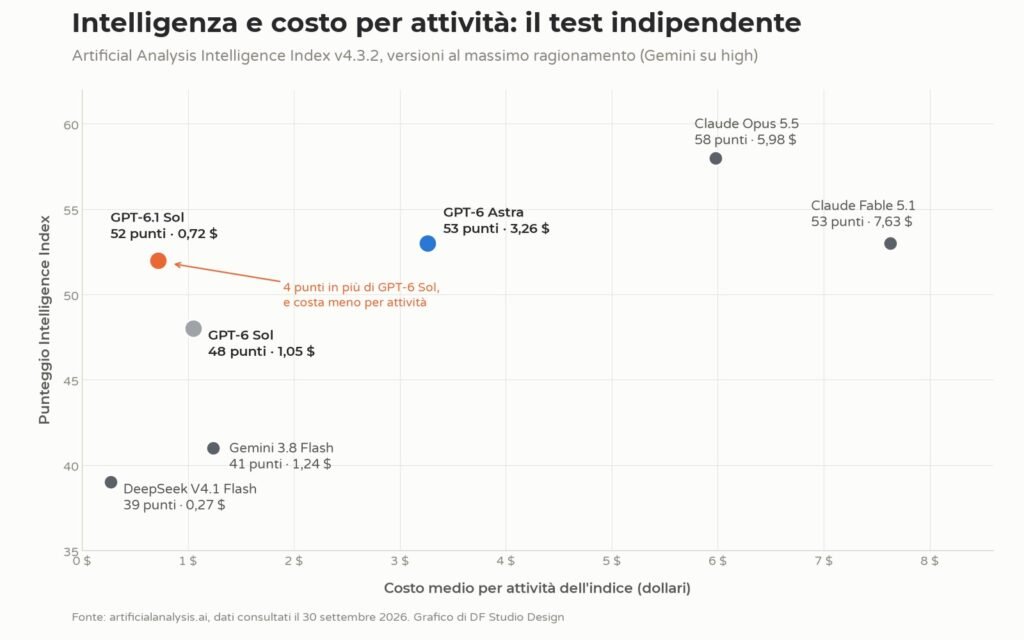
Tutti i numeri sopra vengono da OpenAI. Per un confronto fatto da terzi, il riferimento è Artificial Analysis, che fa girare lo stesso indice di dieci test su tutti i modelli e misura anche quanto costa farli. Al massimo ragionamento GPT-6.1 Sol prende 52 punti. Il costo medio per attività dell’indice è di 0,72 dollari.
Letto in parole semplici:
- Rispetto a GPT-6 Sol (48 punti, 1,05 dollari): 4 punti in più e costa meno per attività, perché usa meno token per arrivare alla risposta.
- Rispetto ad Astra (53 punti, 3,26 dollari): un punto sotto, a meno di un quarto del costo.
- Rispetto a Claude Opus 5.5 (58 punti, 5,98 dollari): Opus resta il più capace dell’indice, ma costa più di otto volte tanto per attività.
- Rispetto a Claude Fable 5.1 (53 punti, 7,63 dollari): un punto sotto, a circa un decimo del costo.
- La velocità: circa 69 token al secondo, un po’ meno dei 76 di GPT-6 Sol e più dei 55 di Astra.
Quanto costa GPT-6.1 Sol
Nelle API il listino è questo, in dollari per milione di token:
| Voce | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| Entrata | $2 | $2 |
| Entrata già in cache | $0,10 | $0,20 |
| Scrittura in cache | $2,50 | $2,50 |
| Uscita | $10 | $10 |
Tre cose da sapere, che nei comunicati si leggono poco:
- Oltre i 272.000 token il prezzo sale. Se una richiesta supera quella soglia, l’entrata e la cache costano il doppio e l’uscita una volta e mezza.
- Batch e Flex costano la metà. Se il lavoro non è urgente e può aspettare, si risparmia il 50%.
- Il ragionamento si paga come uscita. I token che il modello usa per pensare si pagano come risposta. Per questo due modelli con lo stesso listino possono costare molto diversamente sullo stesso lavoro.
Il confronto con gli altri modelli, sempre in dollari per milione di token:
| Modello | Entrata | Uscita |
|---|---|---|
| GPT-6 Luna | $0,10 | $0,50 |
| Gemini 3.8 Flash (fino al 31 dicembre) | $0,75 | $3,75 |
| GPT-6.1 Sol | $2 | $10 |
| Claude Opus 5.5 | $4 | $20 |
| GPT-6 Astra | $10 | $50 |
| Claude Fable 5.1 | $10 | $50 |
Per farti un’idea concreta, ho fatto un conto su un lavoro tipico da agente: 1.000 richieste da 20.000 token in entrata, di cui 16.000 già in cache perché l’agente rilegge lo stesso contesto, e 2.000 token in uscita. Senza contare la scrittura iniziale in cache:
| Modello | Costo di 1.000 richieste |
|---|---|
| GPT-6.1 Sol | $29,60 |
| GPT-6 Sol | $31,20 |
| Claude Opus 5.5 | $59,20 |
| GPT-6 Astra | $156,00 |
Il vantaggio su GPT-6 Sol sembra piccolo, ma il conto parte dall’ipotesi che i due modelli producano lo stesso numero di token. Nel test indipendente GPT-6.1 Sol ne usa meno, e infatti costa un terzo in meno per attività. Se vuoi capire come scegliere il modello giusto per non spendere troppo, ne ho parlato nell’articolo su quanto si paga l’AI e i modelli che uso io.
In ChatGPT il modello è compreso negli abbonamenti Plus, Pro, Business, Enterprise ed Edu, dentro Work e Codex. Al DevDay OpenAI ha presentato anche un nuovo livello Pro da 500 dollari al mese, con i limiti di utilizzo più alti.
Perché non è uscito GPT-6.1 Astra
Il giorno prima del DevDay il Wall Street Journal ha riportato che OpenAI aveva rinunciato a pubblicare GPT-6.1 Astra. Secondo quanto riportato, nei test interni il modello mostrava più comportamenti ingannevoli e una tendenza ad andare avanti con i compiti senza chiedere il permesso all’utente. Lo ricostruisce anche TechCrunch. Al suo posto, sul palco, è arrivato GPT-6.1 Sol.
È una notizia che conta, perché dice due cose. La prima: i test di sicurezza a volte bloccano davvero un lancio, anche il giorno prima. La seconda: il miglioramento del prodotto per chi paga è arrivato dalla fascia media, non da quella alta.
Cosa dice la scheda di sicurezza
Insieme al modello OpenAI ha pubblicato un aggiornamento della scheda di sicurezza. I punti principali:
- Classificazione: nel suo sistema di valutazione dei rischi, OpenAI tratta GPT-6.1 Sol come capacità “critica” nella cybersicurezza e “alta” in biologia e chimica, e per questo usa le stesse protezioni di Astra.
- Strumenti rotti: quando lo strumento di ricerca non funziona, non lo segnala nel 2,1% dei casi, contro il 4,9% di GPT-6 Sol e l’1,5% di Astra.
- Avvisi da rispettare: in test che gli chiedono di fermarsi davanti a un blocco, insiste lo stesso nel 23,5% dei casi, contro il 17,4% di Astra.
- Onestà nel codice: descrive in modo sbagliato il lavoro fatto nell’1,50% dei casi, contro lo 0,51% di Astra e l’1,30% di GPT-6 Sol.
- Salute: in HealthBench Professional fa 64,2 contro il 64,7 di Astra e il 60,8 di GPT-6 Sol.
Sono test costruiti apposta per mettere in difficoltà il modello e non misurano l’uso normale. Il quadro però è chiaro: su molti fronti migliora rispetto a GPT-6 Sol, ma su alcuni comportamenti da agente è ancora un passo dietro ad Astra.
Le altre novità del DevDay
GPT-6.1 Sol non è stato l’unico annuncio. Dalla presentazione ufficiale e dalla cronaca di Unite.AI:
- Versioni Ultrafast: GPT-6 Astra Ultrafast, fino a 8 volte più veloce di Astra, e una versione Ultrafast di GPT-6.1 Sol, per le API e per il nuovo piano Pro da 500 dollari al mese.
- Codex: esecuzione da remoto su telefono, computer o cloud, ambienti di sviluppo riutilizzabili per i team e una revisione del codice collegata a GitHub e GitLab.
- ChatGPT Work: spazi condivisi tra persone e agenti, documenti e presentazioni collaborative, attività programmate per i team e un plugin per prendere appunti durante le riunioni.
GPT-6.1 Sol, Astra o Luna: quale scegliere
- GPT-6.1 Sol per la maggior parte del lavoro serio: programmazione, documenti, automazioni, agenti che lavorano a lungo. È il punto di equilibrio.
- GPT-6 Astra quando serve il massimo e il costo passa in secondo piano: ricerca scientifica difficile, problemi dove sbagliare costa caro, compiti da agente molto delicati.
- GPT-6 Luna per i lavori semplici e ripetitivi in grandi quantità, dove conta spendere poco: classificare, riassumere, estrarre dati.
- Claude Opus 5.5 resta un’alternativa da considerare se ti serve il punteggio più alto nelle automazioni complesse e sei disposto a pagare di più.
La mia opinione su GPT-6.1 Sol
Lavoro con siti web, SEO e contenuti da oltre dieci anni, e negli ultimi due anni l’AI è entrata nel mio lavoro di tutti i giorni. La cosa che ho imparato è che il modello migliore sulla carta non è quasi mai quello che conviene usare sempre. Quello che conta è quanto ti costa ogni lavoro finito e quante volte devi correggerlo.
Per questo trovo GPT-6.1 Sol più interessante di tanti lanci più rumorosi. Non promette di essere il più intelligente in assoluto, e infatti su alcuni test Astra e Opus restano davanti. Promette di fare quasi lo stesso lavoro spendendo molto meno, e i dati indipendenti per ora gli danno ragione. Per chi fa girare agenti su un sito, su un gestionale o su una base di codice, il prezzo dimezzato della cache è forse la novità più concreta di tutte.
Due cautele. La prima: quasi tutti i benchmark sono di OpenAI, e l’unico test indipendente per ora è quello di Artificial Analysis. La seconda: il modello non è ancora nella Chat di ChatGPT, quindi chi lo usa solo lì non lo vedrà subito. Se invece stai pensando a come far trovare la tua attività in queste nuove AI, che citano siti e aziende nelle risposte, è il lavoro che faccio con la consulenza SEO e GEO.
Conclusione
GPT-6.1 Sol è uscito ieri, 29 settembre, ed è il modello che OpenAI propone per il lavoro di tutti i giorni fatto con l’AI: quasi al livello di Astra nella programmazione, nei documenti e nell’uso del computer, allo stesso prezzo di GPT-6 Sol e con la cache a metà prezzo. Nei test più difficili, come la ricerca scientifica e le automazioni al massimo livello, Astra e Opus 5.5 restano davanti, ma costano da quattro a otto volte tanto.
Se usi ChatGPT Work, Codex o le API, è il modello da provare per primo. Se lavori solo nella Chat, dovrai aspettare ancora un po’.
FAQ
Cos’è GPT-6.1 Sol?
È il nuovo modello di fascia media di OpenAI, presentato il 29 settembre 2026. Aggiorna GPT-6 Sol e, secondo OpenAI, si avvicina a GPT-6 Astra nella programmazione, nell’uso del computer e nel lavoro professionale, a un quinto del prezzo di Astra.
Si chiama ChatGPT 6.1 Sol?
No, il nome ufficiale è GPT-6.1 Sol. ChatGPT è l’applicazione in cui lo usi: il modello è disponibile in ChatGPT Work e in Codex.
Quanto costa GPT-6.1 Sol?
Nelle API costa 2 dollari per milione di token in entrata, 0,10 per l’entrata già in cache e 10 in uscita. In ChatGPT è compreso negli abbonamenti Plus, Pro, Business, Enterprise ed Edu.
GPT-6.1 Sol è meglio di GPT-6 Astra?
No, Astra resta più capace nel complesso, soprattutto nella ricerca scientifica e nei compiti più difficili. GPT-6.1 Sol si avvicina molto in programmazione, documenti e uso del computer, costando circa un quinto.
Posso usare GPT-6.1 Sol nella Chat di ChatGPT?
Per ora no. OpenAI lo ha reso disponibile in ChatGPT Work e Codex, e nelle API. Nella Chat non è ancora arrivato.
Leggi anche:
GPT-6 Astra e Gemini 3.8 Flash: benchmark ufficiali, prezzi veri e quale conviene ·
Gemini 4 Pro in prova su Arena sotto il nome Gemini 3.8 Flash: cosa sappiamo davvero ·
Claude Fable 5.1 e Mythos 5.1: benchmark, prezzi e taglio del 75%
Fonti
- OpenAI, Presentiamo GPT-6.1 Sol, 29 settembre 2026: benchmark, prezzi e disponibilità.
- OpenAI, documentazione del modello gpt-6.1-sol: contesto, livelli di ragionamento, listino completo.
- OpenAI, documentazione del modello gpt-6-sol: il confronto con la versione precedente.
- OpenAI, aggiornamento della scheda di sicurezza di GPT-6.1 Sol: valutazioni di sicurezza e classificazione dei rischi.
- Artificial Analysis, GPT-6.1 Sol: test indipendente, costo per attività e velocità.
- TechCrunch, 29 settembre 2026: il lancio e il ritiro di GPT-6.1 Astra.
- Unite.AI: le altre novità del DevDay 2026.

7 risorse gratuite per sviluppatori: API di AI, database, email
7 risorse gratuite per sviluppatori: API di AI, database, email e monitoraggio Di Daniele Forciniti Queste sono 7 risorse gratuite per sviluppatori…

Gemini 4 Argon: tutte le novità, costi e benchmark
Gemini 4 Argon: tutte le novità, costi e benchmark Di Daniele Forciniti Gemini 4 Argon è il nuovo modello di punta di…
Gemini 4 Pro in prova su Arena sotto il nome
Gemini 4 Pro in prova su Arena sotto il nome Gemini 3.8 Flash: cosa sappiamo davvero Di Daniele Forciniti Secondo diversi sviluppatori,…
Ricerca multimodale: ora Search Console mostra chi ti trova con
Ricerca multimodale: ora Search Console mostra chi ti trova con una foto Di Daniele Forciniti Dal 24 settembre 2026 Google Search Console…
SEO, AEO, GEO, AIO e SXO: le 5 sigle della
SEO, AEO, GEO, AIO e SXO: le 5 sigle della SEO moderna spiegate in modo semplice Di Daniele Forciniti SEO, AEO, GEO,…
Claude Opus 5.5, GPT-6 Sol e Luna: prezzi e benchmark
Claude Opus 5.5, GPT-6 Sol e Luna: prezzi e benchmark a confronto Di Daniele Forciniti Il 22 settembre 2026 Anthropic ha pubblicato…