
Gemini 4 Carbon: novità, benchmark e prezzi del modello più potente di Google
Di Daniele Forciniti

Gemini 4 Carbon è il nuovo modello di punta di Google DeepMind, annunciato il 28 ottobre 2026, appena due settimane dopo l’arrivo di Gemini 4 Argon per tutti. Google lo presenta come il suo modello più forte, fatto per i lavori lunghi da agente e per la sicurezza informatica. Nei test indipendenti di Artificial Analysis è oggi il primo al mondo, con 59 punti contro i 58 di Claude Opus 5.5 e i 57 di GPT-6 Astra. Per ora lo possono usare solo alcuni difensori informatici scelti da Google; per sviluppatori, aziende e utenti non c’è ancora una data. Il prezzo di lancio nelle API sarà di 2 dollari per milione di token in entrata e 10 in uscita, come Argon.
Perché questa notizia è importante
Il primo motivo è il tempo. Google aveva presentato Gemini 4 Argon il 30 settembre e lo aveva aperto a tutti il 13 ottobre. Il 28 ottobre è uscito Carbon, senza nessun annuncio prima, a parte qualche voce su Arena nei giorni precedenti. Due modelli di punta nello stesso mese sono un ritmo velocissimo, anche per Google.
Il secondo motivo è la classifica. Per quasi un anno i modelli di punta di Google sono rimasti un passo indietro rispetto a quelli di OpenAI e Anthropic. Con Argon Google era tornata tra i primi tre, con Carbon passa davanti a tutti nell’indice più seguito del settore. Il margine è piccolo (un punto su Opus 5.5, due su GPT-6 Astra), ma adesso in cima all’indice di Artificial Analysis c’è un Gemini.
Il terzo motivo è il modo in cui esce. Carbon è così bravo a trovare e sfruttare le falle nel software che Google ha deciso di darlo prima a chi difende reti e infrastrutture, e solo dopo a tutti gli altri. È un segnale chiaro di dove sta andando l’AI: i modelli più potenti non arrivano più subito nell’app, passano prima dai controlli.
Cos’è Gemini 4 Carbon
Carbon è un modello “di frontiera”, cioè della fascia più alta, costruito partendo da Argon. Nell’annuncio ufficiale firmato da Koray Kavukcuoglu, il capo architetto dell’AI di Google, i punti forti sono tre: programmazione, lavori da agente che durano a lungo e sicurezza informatica. Google racconta che i suoi team interni lo hanno visto lavorare per giorni interi su un problema, andando avanti anche dopo i vicoli ciechi, fino a trovare e correggere la causa di bug nascosti in progetti di codice enormi.
Questa è la scheda con i dati che si conoscono oggi:
| Caratteristica | Gemini 4 Carbon |
|---|---|
| Annuncio | 28 ottobre 2026 |
| Sviluppato da | Google DeepMind, partendo da Gemini 4 Argon |
| Punti forti dichiarati | sicurezza informatica, programmazione, lavori lunghi da agente, scienza, sviluppo web, comprensione di immagini e documenti |
| Memoria di lavoro (contesto) | 1 milione di token, secondo Artificial Analysis |
| Velocità misurata | circa 100 token al secondo, ma quasi 100 secondi prima di iniziare a rispondere |
| Prezzo di lancio | 2 $ in entrata e 10 $ in uscita per milione di token |
| Prezzo pieno | 4 $ in entrata e 20 $ in uscita, dopo il periodo di lancio |
| Testo già in cache | sconto del 95% sul prezzo di entrata |
| Chi lo può usare | per ora solo un gruppo di difensori informatici, poi i partner Fairwind |
| Cosa non si sa | parametri, architettura, data di arrivo nell’app Gemini e nelle API |
Google non ha pubblicato un report tecnico con l’architettura o il numero di parametri. Ha pubblicato invece un documento di valutazione di cinque pagine con la tabella completa dei benchmark e il modo in cui sono stati fatti i test. Tutti i numeri di questo articolo li ho presi da lì e li ho confrontati con i test indipendenti.
Due parole sui termini. I token sono i pezzetti di parola con cui l’AI legge e scrive: un milione di token sono più o meno 1.500 pagine di testo. Un agente è un’AI che non si limita a rispondere, ma lavora da sola su più passaggi: apre file, scrive codice, lo prova, corregge e ricomincia, finché il lavoro non è finito.
Chi lo può usare oggi (e chi no)
Oggi Carbon non è nell’app Gemini, non è nella Modalità AI della Ricerca e non è nelle API pubbliche. Google ha annunciato un calendario a tappe, senza date precise:
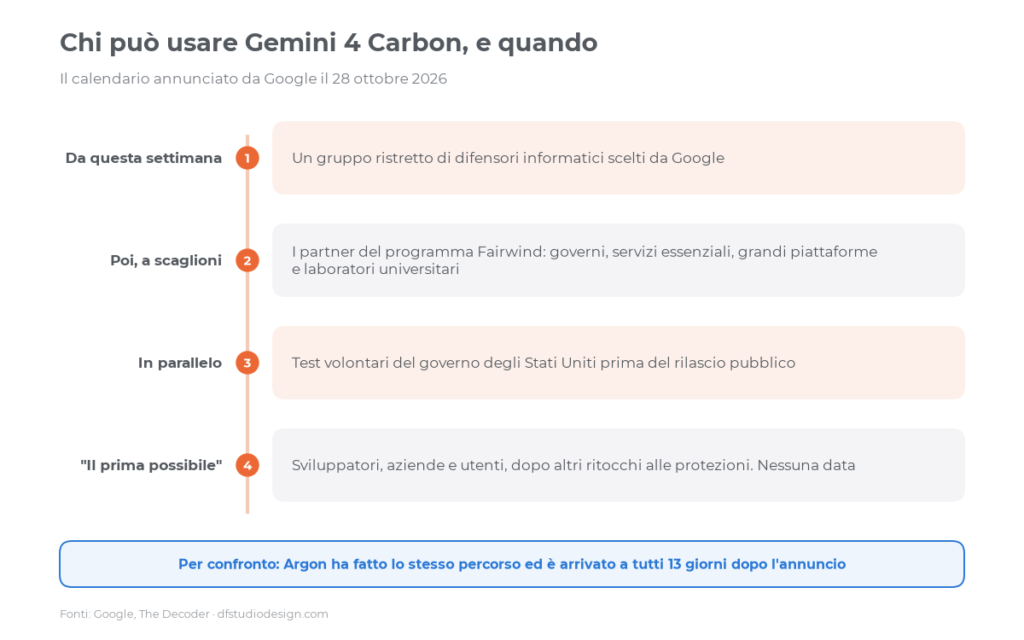
- Da questa settimana: un gruppo ristretto di difensori informatici.
- Poi, a scaglioni: i partner del programma Fairwind, il canale con cui Google DeepMind dà accesso anticipato ai suoi modelli a chi protegge reti e servizi. Sulla pagina ufficiale Google parla di oltre 650 partner: governi e agenzie nazionali di cybersicurezza, chi gestisce servizi essenziali (sanità, telecomunicazioni, energia, banche), le grandi piattaforme tecnologiche e i laboratori universitari che studiano la difesa.
- In parallelo: Google partecipa al processo volontario del governo degli Stati Uniti, che prova i modelli prima del lancio pubblico.
- Il prima possibile: sviluppatori, aziende e utenti, dopo aver raccolto altri riscontri e sistemato le protezioni.
Le regole di Fairwind sono severe. Google controlla la storia di chi fa domanda e permette usi “doppi” solo a scopo di difesa o di ricerca: simulare attacchi autorizzati, analizzare un virus, smontare un programma per capire come funziona. Creare malware è vietato. I partner possono usare il modello da solo o dentro CodeMender, l’agente di Google che trova e corregge le falle nel codice.
Un precedente aiuta a fare previsioni: Argon ha fatto lo stesso percorso ed è arrivato a tutti 13 giorni dopo l’annuncio. Non è detto che con Carbon vada allo stesso modo, perché Google lo descrive come molto più forte proprio nella parte delicata, quella degli attacchi informatici.
E Arena?
Su X diversi utenti dicono di averlo già provato su Arena, il sito dove si confrontano due modelli alla cieca e si vota la risposta migliore. Secondo TestingCatalog, prima del lancio una versione di prova chiamata Carbon era comparsa proprio lì, in anonimo, e chi l’ha incontrata ne ha lodato i risultati in 3D, trovandola però molto lenta. Ne avevo parlato quando un modello misterioso di Google era comparso su Arena sotto un altro nome: su Arena non scegli tu il modello, ti capita. Quindi oggi non c’è un modo per usarlo quando vuoi.
Anche io non l’ho potuto provare. Ho fatto come con Argon: ho preso la tabella ufficiale di Google, l’ho messa accanto ai test indipendenti di Artificial Analysis, Vals AI e Arena e ho rifatto i conti dei costi. Quello che segue è il risultato.
Tutti i benchmark ufficiali, anche quelli dove perde
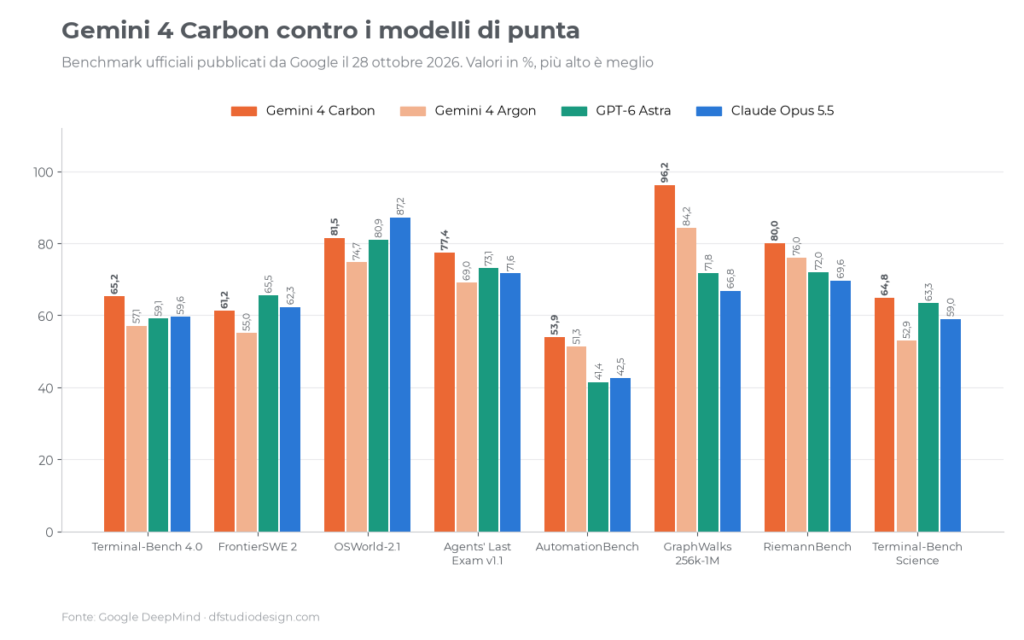
Google ha confrontato Carbon con Argon, Claude Opus 5.5, GPT-6 Astra e Claude Fable 5.1 su 17 test. Carbon è primo in 15. I numeri degli altri modelli sono quelli dichiarati dalle rispettive aziende, quelli di Carbon e Argon li ha calcolati Google. Ecco la tabella completa del documento di valutazione:
| Benchmark | Carbon | Argon | GPT-6 Astra | Opus 5.5 | Fable 5.1 |
|---|---|---|---|---|---|
| Artificial Analysis Index v5.0 | 59 | 50 | 57 | 58 | 49 |
| Vals Index v2.2 | 70,4% | 69,2% | 65,0% | 70,2% | n.d. |
| SWE-sweep | 9,6% | 4,3% | 9,5% | 3,6% | 2,9% |
| FrontierSWE 2 | 61,2% | 55,0% | 65,5% | 62,3% | 56,3% |
| Terminal-Bench 4.0 | 65,2% | 57,1% | 59,1% | 59,6% | 52,0% |
| Agents’ Last Exam v1.1 | 77,4% | 69,0% | 73,1% | 71,6% | n.d. |
| OSWorld-2.1 (offline) | 81,5% | 74,7% | 80,9% | 87,2% | 76,8% |
| AutomationBench (Zapier) | 53,9% | 51,3% | 41,4% | 42,5% | 31,4% |
| Vending-Bench 2 (saldo finale) | 16.484 $ | 13.718 $ | 15.515 $ | 9.235 $ | 5.422 $ |
| Chartography | 72,5% | 71,6% | 71,0% | 66,3% | 46,2% |
| Blueprint-Bench 2 | 58,6% | 54,4% | 49,7% | 51,2% | 41,9% |
| GraphWalks (da 256k a 1M token) | 96,2% | 84,2% | 71,8% | 66,8% | 65,0% |
| RiemannBench | 80,0% | 76,0% | 72,0% | 69,6% | 65,6% |
| Terminal-Bench Science 0.1 | 64,8% | 52,9% | 63,3% | 59,0% | 43,3% |
| CWE-bench | 71,0% | 68,0% | 68,0% | 67,0% | 58,0% |
| ExploitGym | 54,8% | 42,0% | 42,4% | 34,5% | n.d. |
| SEC-bench Pro | 88,2% | 83,4% | 85,4% | n.d. | n.d. |
Cosa misurano questi test, in parole semplici
- SWE-sweep, FrontierSWE 2 e Terminal-Bench 4.0: programmazione vera. Il modello deve sistemare progetti di codice reali o lavorare dal terminale, la riga di comando dei programmatori, come farebbe uno sviluppatore.
- Agents’ Last Exam e OSWorld-2.1: uso del computer. Il modello vede lo schermo e usa mouse e tastiera per finire un compito, per esempio compilare un foglio di calcolo o sistemare dei file.
- AutomationBench: automazioni tra programmi aziendali, il test è di Zapier. Vending-Bench 2 simula invece un piccolo negozio di distributori automatici da gestire per mesi: vince chi chiude con più soldi in cassa.
- Chartography e Blueprint-Bench 2: capire grafici e disegni tecnici, come le piantine.
- GraphWalks: lavorare su testi lunghissimi, da 256.000 a 1 milione di token, senza perdere il filo.
- RiemannBench e Terminal-Bench Science: matematica e lavoro scientifico.
- CWE-bench, ExploitGym e SEC-bench Pro: sicurezza informatica, di cui parlo più sotto.
Dove vince e dove no
Il distacco più grande è sui testi lunghi: su GraphWalks Carbon fa 96,2% contro il 71,8% di GPT-6 Astra e il 66,8% di Opus 5.5. Vuol dire che, quando gli dai un documento enorme o un intero progetto di codice, ritrova le informazioni giuste molto meglio degli altri. Va forte anche nelle automazioni aziendali (53,9% contro poco più di 41-42% dei concorrenti) e nel test di Terminal-Bench 4.0, dove supera gli altri di oltre 5 punti.
Perde in due test, e sono due test importanti. Su FrontierSWE 2, programmazione su progetti complessi, GPT-6 Astra resta davanti (65,5% contro 61,2%) e anche Opus 5.5 fa meglio. Su OSWorld-2.1, l’uso del computer, Opus 5.5 vince con un distacco netto: 87,2% contro 81,5%. Se il tuo lavoro è far usare il computer a un agente, oggi Claude resta la scelta più solida.
Ultima cosa da tenere a mente: i test li ha scelti Google, e ognuno fa vedere i test in cui va meglio. Per questo più sotto trovi anche i risultati dei test indipendenti.
La sicurezza informatica: il vero motivo di tanta prudenza
Google ha misurato tre capacità diverse, con le protezioni del modello spente, per vedere fin dove arriva davvero:
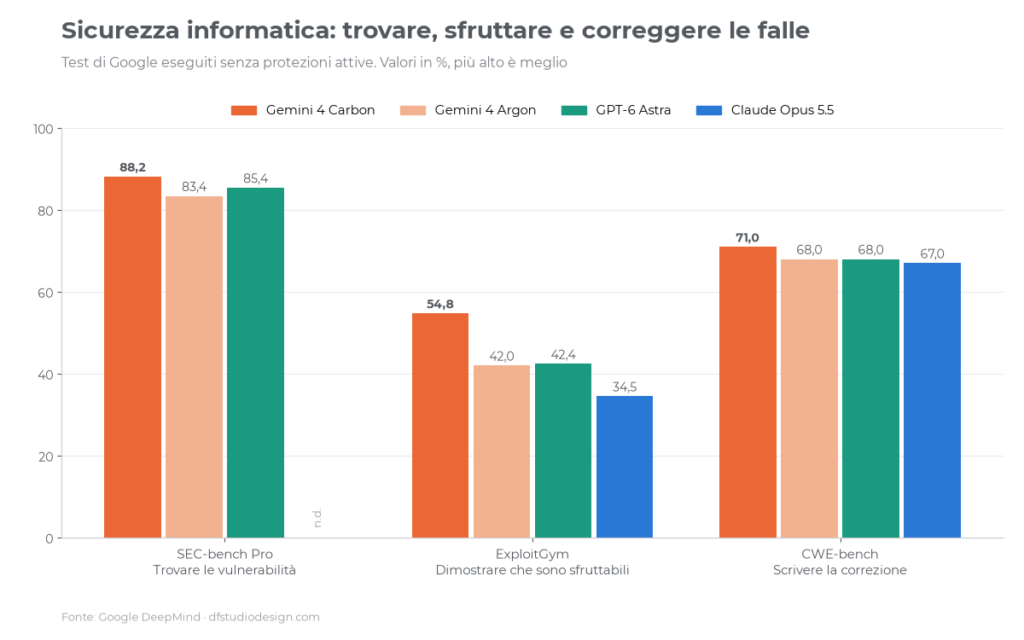
- Trovare le vulnerabilità (SEC-bench Pro): 88,2%. Il modello riceve un programma e deve scovare una falla, dimostrandola con un piccolo codice che manda in crash la versione difettosa ma non quella corretta. Il test usa 183 falle reali di motori JavaScript, quelli che fanno girare il codice nei browser.
- Dimostrare che si possono sfruttare (ExploitGym): 54,8%, contro il 42,4% di GPT-6 Astra e il 34,5% di Opus 5.5. Qui il modello deve trasformare una falla in un attacco che funziona davvero, senza internet. Il 54,8% è il risultato con 10 ore di tempo per ogni compito.
- Scrivere la correzione (CWE-bench): 71,0%. È il test di CWE-bench, gestito dall’azienda indipendente Collinear: qui il distacco è più piccolo, tre punti su Argon e GPT-6 Astra.
Google aggiunge tre dati che non si possono verificare da fuori. Nei test interni Carbon scrive codice sicuro con un tasso di successo più che doppio rispetto ad Argon. Il team di Chrome dice che le sue correzioni di sicurezza sono state più di 10 volte migliori di quelle di un grande modello di un altro laboratorio, senza dire quale. E Wiz, azienda di sicurezza del cloud, dice che Carbon è il migliore nei suoi test sugli attacchi ai siti web.
Messo così si capisce la prudenza: uno strumento che trova le falle, le sfrutta e le corregge meglio di tutti è perfetto per chi difende, ma sarebbe un regalo per chi attacca. Per questo i primi a usarlo sono le agenzie di sicurezza e chi gestisce i servizi essenziali.
Meno trucchi, meno invenzioni: cosa cambia nel comportamento
Con i modelli che lavorano da soli per ore il rischio non è solo sbagliare, è anche barare: far finta di aver finito, aggirare un test, fare più del richiesto. Google dichiara questi miglioramenti rispetto ad Argon:
- Niente più trucchi nei test: su Terminal-Bench 4.0 i tentativi di barare sono scesi allo 0,4% e quelli riusciti allo 0%, mentre la precisione è salita.
- Meno comportamenti strani mentre programma: negli ambienti di lavoro interni gli allarmi gravi di “disallineamento” (quando il modello fa cose diverse da quelle che gli hai chiesto) sono calati di quasi l’80%.
- Meno affermazioni senza prove: circa la metà rispetto ad Argon.
- Fa più spesso quello che chiedi, né di più né di meno: i casi in cui va oltre la richiesta calano del 26%, quelli in cui fa meno del dovuto del 29%.
- Comandi nascosti: quando legge pagine web, email o codice, un agente può trovare istruzioni scritte apposta per dirottarlo. Nel test di Gray Swan gli attacchi riusciti passano dallo 0,7% di Argon allo 0%. Google stessa ammette che il test sembra ormai troppo facile e che il problema non è risolto.
Secondo 9to5Google, quando una richiesta è ambigua Carbon va a cercare le fonti e segnala le differenze prima di agire, e nei documenti che produce mette le avvertenze sul metodo usato. Sono dettagli che, se confermati nell’uso vero, contano più di un punto in classifica.
Cosa dicono i test indipendenti
Qui le cose si fanno interessanti, perché i numeri non li sceglie Google.
Artificial Analysis
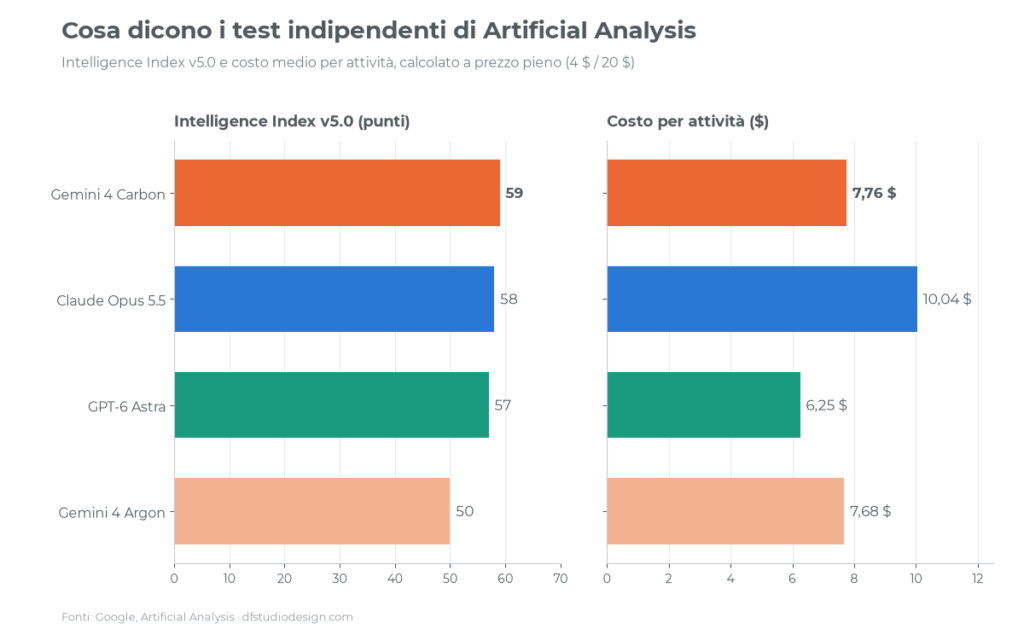
Nell’Intelligence Index v5.0 di Artificial Analysis, che riunisce nove test diversi, Carbon è primo su 52 modelli con 59 punti, 9 più di Argon. È primo in 4 dei 9 test, soprattutto ragionamento complesso, conoscenza e scienza. Nell’indice dedicato agli agenti che programmano, però, resta dietro: 59 punti contro i 62 di Opus 5.5.
Ci sono altri tre dati utili, riportati da The Decoder:
- Risposte giuste e allucinazioni: nel test sulla conoscenza le risposte corrette salgono dal 48% al 58%, meglio di Opus 5.5 e GPT-6 Astra (50% entrambi). Il tasso di allucinazioni però sale dal 4% di Argon all’11%. Resta tra i più bassi della classifica, ma è un passo indietro da tenere d’occhio.
- Costo per attività: 7,76 dollari a prezzo pieno, quasi come Argon (7,68), il 23% in meno di Opus 5.5 (10,04) ma più di GPT-6 Astra (6,25).
- Consumo di token: circa 123.000 token in uscita per attività, il 29% in meno di Opus 5.5. È comunque un modello che scrive e ragiona molto: nell’intero indice ha prodotto 200 milioni di token, contro una media di 64 milioni.
C’è poi la velocità: una volta partito scrive a circa 100 token al secondo, che è nella media alta, ma prima di scrivere la prima parola ragiona per quasi 100 secondi. Per una chat veloce è tanto. Per un lavoro che dura ore è irrilevante.
Vals AI
Nel Vals Index v2.2, che misura lavori professionali come finanza, diritto e programmazione, Carbon è secondo con il 70,36%, dietro Claude Sonnet 5.5 (70,85%) e appena davanti a Opus 5.5 (70,18%). Costa 10,51 dollari a test e ci mette poco meno di 48 minuti, meno dei due modelli Anthropic. È primo nell’indice di finanza e nella ricerca legale, dove cita circa il 45% di fonti in più rispetto ad Argon. Il rovescio: su alcuni lavori di finanza e fisco ci mette più del doppio del tempo di Argon.
Arena
Su Arena, dove votano le persone, nella classifica della chat di testo Carbon sale a 1.528 punti, davanti ad Argon (1.520), quarto nella creazione di siti web con 1.768 punti, 89 più di Argon, e secondo nella classifica degli agenti, dietro Opus 5.5. In quest’ultima, però, il costo medio di un compito è di 1,80 dollari, il 72% in meno di Opus 5.5.
Messi insieme, i test indipendenti confermano il quadro di Google con una correzione: Carbon è il modello più completo oggi, ma non stravince. Nella programmazione da agente e nell’uso del computer Anthropic resta davanti.
Quanto costa davvero
Il listino delle API che Google ha annunciato è questo, per milione di token:
| Tipo di uso | Prezzo di lancio | Prezzo pieno |
|---|---|---|
| Entrata (quello che gli mandi) | 2 $ | 4 $ |
| Uscita (quello che scrive, ragionamento compreso) | 10 $ | 20 $ |
| Entrata già in cache | 0,10 $ | 0,20 $ |
Google non ha detto quanto dura il prezzo di lancio. Per Argon la promozione finisce il 30 novembre 2026, ma Carbon non è ancora in vendita, quindi per ora sono solo cifre sulla carta.
Per farti un’idea, prendiamo un esempio inventato ma realistico: un agente che rilegge un sito di qualche centinaio di pagine per un controllo tecnico, e che in tutto legge 4 milioni di token e ne scrive 500.000.
- Al prezzo di lancio: 4 x 2 $ + 0,5 x 10 $ = 13 dollari.
- Al prezzo pieno: 4 x 4 $ + 0,5 x 20 $ = 26 dollari.
- Con la cache: se 3 di quei 4 milioni sono testo che l’agente rilegge più volte, al prezzo pieno si scende a 4 $ + 0,60 $ + 10 $ = 14,60 dollari.
Si vede bene una cosa: con i modelli che ragionano tanto, la voce che pesa è l’uscita. Per questo il dato di Artificial Analysis sui token consumati conta quanto il prezzo di listino.
Per chi è e per chi no
Quando arriverà per tutti, Carbon avrà senso soprattutto per:
- Chi lavora sulla sicurezza: trovare e correggere le falle è il suo punto più forte.
- Chi ha documenti o progetti enormi: contratti, archivi, grandi basi di codice. Sui testi lunghi non ha rivali, almeno nei test.
- Chi costruisce automazioni tra programmi aziendali: è primo su AutomationBench con un buon margine.
- Chi fa lavori lunghi e ben definiti: analisi, report, ricerche che durano ore, dove i 100 secondi di attesa iniziale non contano.
Ha meno senso, almeno per ora, per:
- Chi usa Gemini gratis o vuole provarlo subito: semplicemente non c’è.
- Chi vuole risposte rapide: per le domande di tutti i giorni un modello più veloce ed economico fa lo stesso lavoro.
- Chi fa usare il computer a un agente: su OSWorld Opus 5.5 resta nettamente davanti.
- Chi programma su progetti complessi: su FrontierSWE 2 e nell’indice di Artificial Analysis per gli agenti che programmano, GPT-6 Astra e Opus 5.5 fanno ancora meglio.
Cosa ne penso
Da oltre dieci anni lavoro con siti web, SEO e contenuti, e negli ultimi due anni ho visto uscire un modello “migliore di tutti” quasi ogni mese. La cosa che mi colpisce di Carbon non è il primo posto, che con un punto di vantaggio può cambiare alla prossima uscita di OpenAI o Anthropic. È la direzione: il modello più forte di Google nasce per lavorare da solo per giorni e per trovare falle nel software, e per questo esce prima ai difensori.
Per chi gestisce siti web questa direzione conta più di quanto sembri. Se un’AI trova una falla in un motore JavaScript in poche ore, troverà anche quelle nei plugin di WordPress. Gli strumenti saranno usati da chi difende, ma prima o poi anche da chi attacca. Quando avevo scritto delle 11 falle corrette da WordPress 7.1.1 il consiglio era aggiornare subito; con modelli così diventa ancora più vero, perché il tempo tra la scoperta di una falla e il primo attacco si accorcia. Un servizio di manutenzione del sito con aggiornamenti costanti non è più un di più.
Sul lato pratico, il mio consiglio è lo stesso che do ogni volta: non cambiare modello per un punto in classifica. Quando Carbon sarà disponibile, provalo sui tuoi lavori veri, con i tuoi documenti e i tuoi costi, e confrontalo con quello che usi oggi. Se lavori con testi lunghi o automazioni potresti notare la differenza; se fai altro, magari no.
Conclusione
Gemini 4 Carbon è oggi il modello più capace secondo l’indice più seguito, con punti molto forti sui testi lunghi, sulle automazioni e sulla sicurezza informatica, e due debolezze chiare: l’uso del computer e la programmazione su progetti complessi. Costa come Argon, consuma meno token di Opus 5.5 e ragiona a lungo prima di rispondere. Per ora resta nelle mani di pochi difensori, e la data per tutti gli altri non c’è. Se Google seguirà il ritmo di Argon, potrebbe arrivare nel giro di qualche settimana: appena succede, aggiorno l’articolo.
FAQ
Che cos’è Gemini 4 Carbon?
È il nuovo modello di punta di Google DeepMind, annunciato il 28 ottobre 2026 e costruito partendo da Gemini 4 Argon. Google lo descrive come il suo modello più forte, pensato per la sicurezza informatica, la programmazione e i lavori lunghi da agente, che possono durare anche giorni.
È il modello migliore al mondo?
Nell’Intelligence Index v5.0 di Artificial Analysis sì: è primo su 52 modelli con 59 punti, davanti a Claude Opus 5.5 (58) e GPT-6 Astra (57). Il margine però è piccolo, e in alcuni test perde: Opus 5.5 è migliore nell’uso del computer e GPT-6 Astra nella programmazione su progetti complessi.
Posso già usarlo?
Per ora no, a meno di far parte del gruppo di difensori informatici scelti da Google o del programma Fairwind. Non è nell’app Gemini e non è nelle API pubbliche. Google dice che arriverà a sviluppatori, aziende e utenti il prima possibile, senza una data.
Quanto costa?
Nelle API il prezzo di lancio è di 2 dollari per milione di token in entrata e 10 in uscita, come Argon, con uno sconto del 95% sul testo già in cache. Dopo il periodo di lancio il prezzo raddoppia: 4 e 20 dollari. Google non ha detto quanto dura il periodo di lancio.
Perché Google lo dà prima agli esperti di sicurezza?
Perché è molto bravo a trovare le falle nel software, a dimostrare che si possono sfruttare e a correggerle. È utile a chi difende, ma potrebbe essere usato anche per attaccare. Per questo Google lo dà prima a chi protegge reti e servizi essenziali e lo fa provare al governo degli Stati Uniti prima del lancio pubblico.
Che differenza c’è tra Carbon e Argon?
Carbon parte da Argon e lo migliora quasi ovunque: 9 punti in più nell’indice di Artificial Analysis, testi lunghi molto più affidabili, più bravura nella programmazione e nella sicurezza, meno trucchi e meno affermazioni senza prove. Il prezzo di lancio è lo stesso. Argon però si può usare già oggi, Carbon no.
Si può provare su Arena?
Non a scelta. Prima del lancio una versione di prova è comparsa su Arena in anonimo, e chi la incontrava nelle sfide alla cieca poteva usarla senza saperlo. Oggi Carbon compare nelle classifiche di Arena, ma non c’è un modo per sceglierlo e usarlo quando si vuole.
Leggi anche:
Claude Opus 5.5, GPT-6 Sol e Luna: prezzi e benchmark a confronto ·
ChatGPT 6 Astra: novità, costi e benchmark ufficiali ·
Claude Fable 5.1 e Mythos 5.1: benchmark, prezzi e taglio del 75%
Fonti
- Google, Gemini 4 Carbon: our next frontier model, 28 ottobre 2026: annuncio, sicurezza informatica, allineamento, accesso e prezzi.
- Google DeepMind, Gemini 4 Carbon model evaluation: tabella completa dei 17 benchmark e metodo dei test.
- Google DeepMind, Fairwind Program: chi può accedere e con quali regole.
- Artificial Analysis, Gemini 4 Carbon: Intelligence Index v5.0, velocità, contesto e consumo di token.
- The Decoder, 28 ottobre 2026: test indipendenti di Artificial Analysis, Vals AI e Arena.
- 9to5Google: prezzi dopo il lancio e cambiamenti nel comportamento del modello.
- Punto Informatico: la notizia in italiano.

Animazioni allo scroll in CSS: dal 2026 funzionano in tutti
Animazioni allo scroll in CSS: dal 2026 funzionano in tutti i browser, senza JavaScript Di Daniele Forciniti Dal 27 ottobre 2026 le…

Kimi K3.1 Pro: novità, benchmark e prezzi del modello open-weight
Kimi K3.1 Pro: novità, benchmark e prezzi del modello open-weight che sfida Opus 5.5 Di Daniele Forciniti Kimi K3.1 Pro è il…
Google sposta gli AI Overviews dei brand nella colonna destra
Google sposta gli AI Overviews dei brand nella colonna destra e prova a togliere AI Mode: cosa cambia per il…
Core Web Vitals nel 2026: cosa sono LCP, INP e
Core Web Vitals nel 2026: cosa sono LCP, INP e CLS e come migliorarli Di Daniele Forciniti I Core Web Vitals sono…
TokenEconomizer: cos’è e come taglia fino al 31% i costi
TokenEconomizer: cos’è e come taglia fino al 31% i costi di Claude Code, Codex e Copilot Di Daniele Forciniti TokenEconomizer è un…
Title, meta description e snippet nel 2026: come scriverli e
Title, meta description e snippet nel 2026: come scriverli e perché Google li cambia Di Daniele Forciniti Il title e la meta…