
Kimi K3.1 Pro: novità, benchmark e prezzi del modello open-weight che sfida Opus 5.5
Di Daniele Forciniti
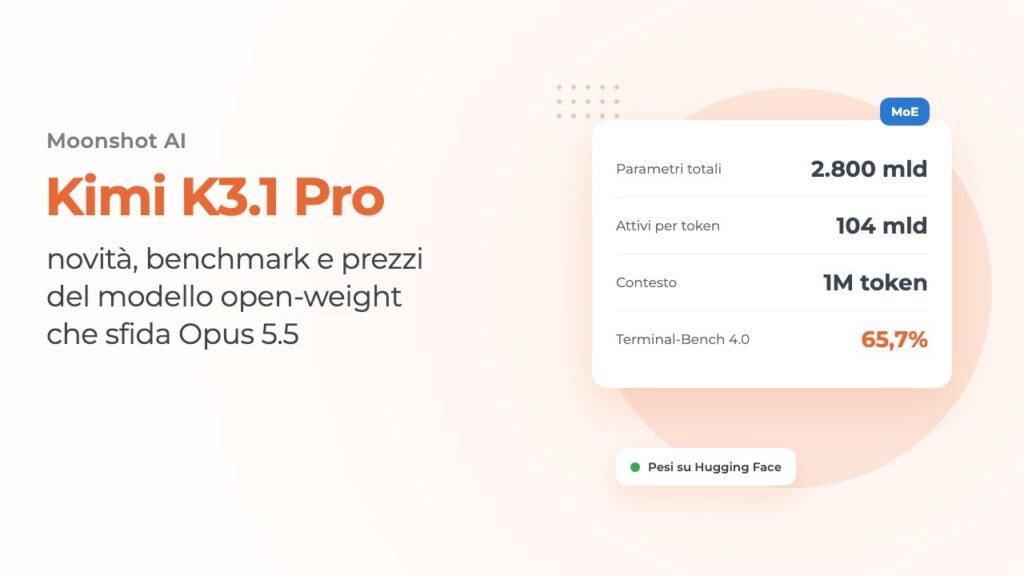
Kimi K3.1 Pro è il nuovo modello di punta di Moonshot AI: un modello a esperti (MoE) da 2.800 miliardi di parametri, di cui 104 miliardi attivi per ogni token, che legge testo e immagini e lavora con un contesto da 1 milione di token. È uscito il 23 ottobre 2026 su Kimi e via API, e dal 4 novembre i pesi completi sono scaricabili da Hugging Face, come promesso. Su Terminal-Bench 4.0, il test che misura quanto un agente sa lavorare da terminale, fa 65,7%, quasi come Claude Opus 5.5 (66,4%) e più di GPT-6 Astra (58,2%), e costa 2 dollari per milione di token in input e 10 in output.
Cosa cambia rispetto a Kimi K3
K3.1 Pro non è un modello costruito da zero. È Kimi K3, uscito a luglio, ripreso e allenato ancora a lungo con l’apprendimento per rinforzo su centinaia di ambiti diversi: programmazione, modellazione 3D, finanza, ricerca. Il blog tecnico di Moonshot parla di un aumento consistente della potenza di calcolo usata in questa seconda fase, ed è lì che arrivano i miglioramenti.
L’unica modifica all’architettura riguarda il modo in cui il modello “guarda” i testi lunghi. Su 24 dei suoi 93 strati Moonshot ha sostituito l’attenzione completa con un’attenzione sparsa (Gated DSA, la tecnica introdotta da DeepSeek), che invece di confrontare ogni parola con tutte le altre sceglie le 2.048 più rilevanti. Serve a reggere il milione di token di contesto senza far esplodere i costi.
| Caratteristica | Kimi K3.1 Pro |
|---|---|
| Architettura | Mixture-of-Experts (modello a esperti) |
| Parametri totali | 2.800 miliardi |
| Parametri attivi per token | 104 miliardi |
| Esperti | 896, di cui 16 scelti per ogni token, più 2 sempre attivi |
| Contesto | 1.048.576 token (circa 1 milione) |
| Input | Testo e immagini (l’API accetta anche video) |
| Formato dei pesi | MXFP4, allenato già in quel formato (1,56 TB su Hugging Face) |
| Uscita | 23 ottobre 2026 (app e API), pesi pubblici dal 4 novembre 2026 |
| Licenza | Kimi K3.1-Pro License, tipo MIT con due condizioni per i grandi |
Un modello a esperti funziona come un ufficio con 896 specialisti: per ogni parola da scrivere ne vengono chiamati solo 16, più due generalisti sempre presenti. Per questo, pur avendo 2.800 miliardi di parametri in totale, per ogni token ne usa “solo” 104 miliardi, e risponde a un costo molto più basso di un modello denso della stessa taglia.
I benchmark: vicino a Opus 5.5, ma non dappertutto
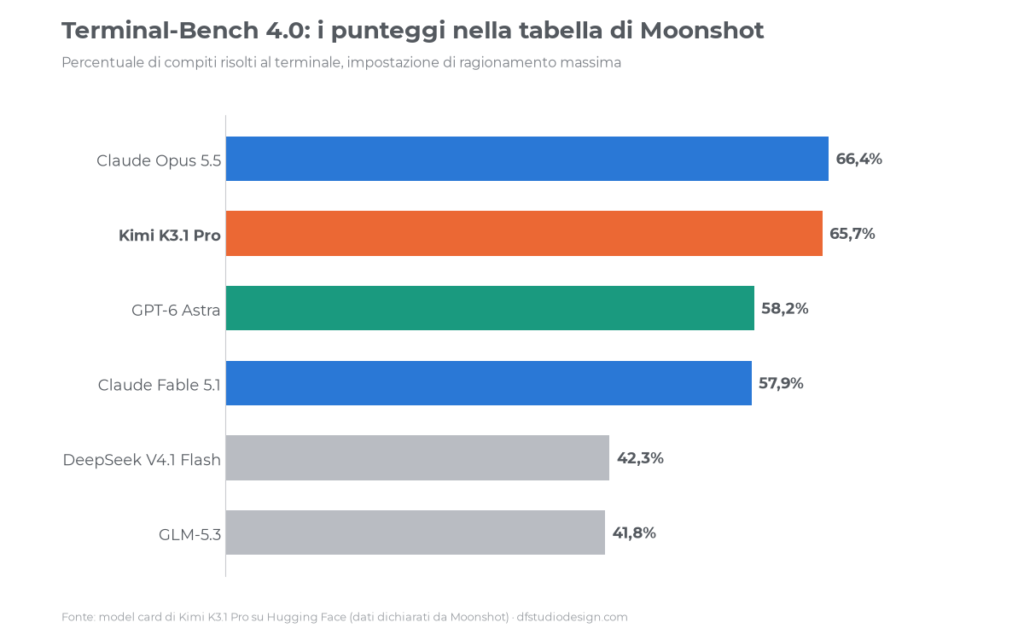
Il numero che Moonshot mette in prima pagina è quello di Terminal-Bench 4.0: 65,7%, contro il 66,4% di Claude Opus 5.5 e il 58,2% di GPT-6 Astra. Il test fa lavorare il modello come un agente dentro un terminale reale, con risorse limitate e verifiche severe, quindi è uno dei più vicini al lavoro vero di chi programma con l’AI.
Un dettaglio che quasi nessuno ha notato: Moonshot ha misurato K3.1 Pro usando Claude Code come ambiente di lavoro, cioè lo stesso programma che Anthropic usa per i suoi modelli. Funziona perché l’API di Kimi è compatibile con il formato di Anthropic: chi usa già Claude Code può provarlo cambiando solo l’indirizzo e la chiave dell’API.
Il 65,7% su Terminal-Bench regge?
I numeri dichiarati da chi vende il modello vanno sempre controllati, così sono andato a vedere chi l’ha misurato in modo indipendente. Artificial Analysis, che rifà i test con un suo metodo, ha ottenuto il 67,2%. Vals AI ha ottenuto il 63,6% (con un margine di errore di più o meno 1,75 punti) e lo mette al terzo posto su 61 modelli in quel test.
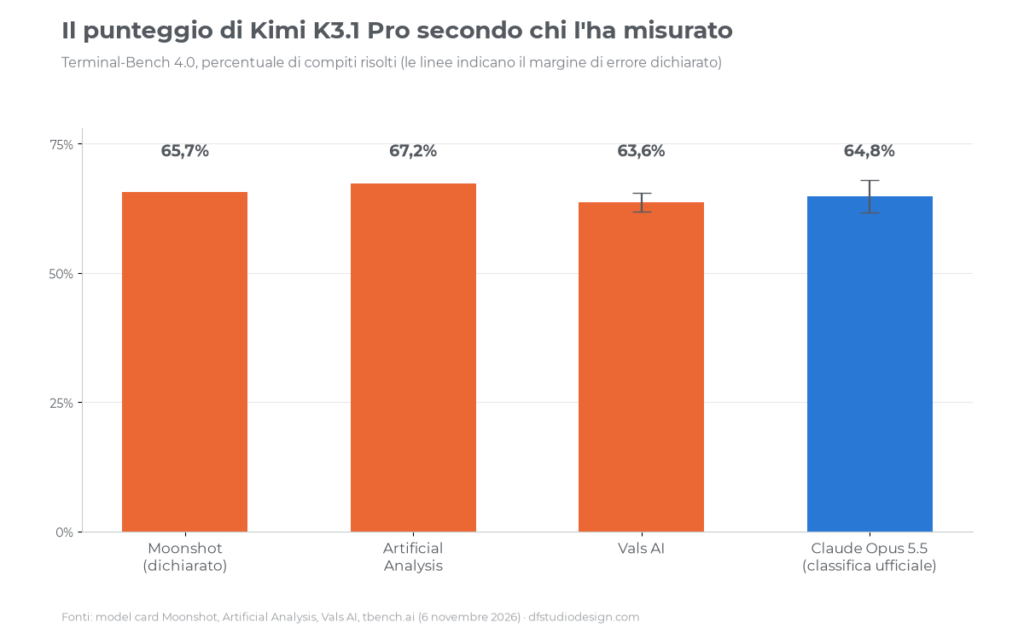
C’è anche un dettaglio sul confronto con Opus 5.5. Moonshot usa il 66,4%, cioè il valore più alto pubblicato da Anthropic, mentre nella classifica ufficiale di Terminal-Bench Opus 5.5 risulta al 64,8%, con un margine di errore di 3,1 punti. Tradotto: su questo test Kimi K3.1 Pro e Opus 5.5 sono praticamente alla pari, e le differenze di un punto stanno dentro il margine di errore. Al 6 novembre Kimi non compare ancora nella classifica ufficiale.
Dove vince e dove perde
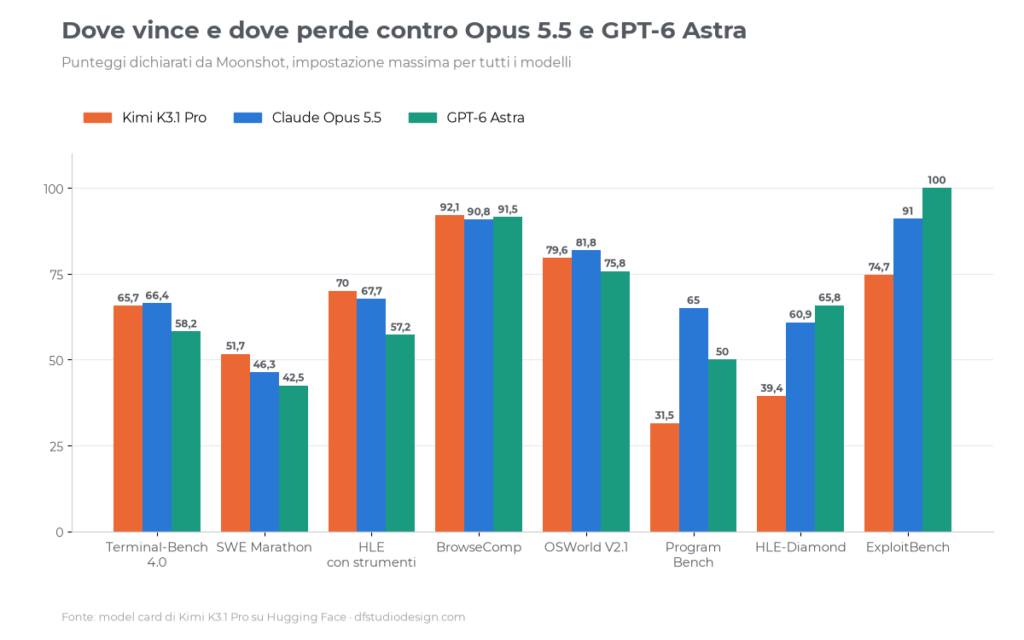
La tabella completa della model card ha più di 40 test, e il quadro è meno uniforme di quanto dica il titolo dell’annuncio. Ho scelto otto test che raccontano bene i punti forti e quelli deboli.
| Test | Cosa misura | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|---|
| SWE Marathon v1.1 | Lavori di programmazione molto lunghi | 51,7 | 46,3 | 42,5 |
| HLE-Full con strumenti | Domande difficilissime, con ricerca e codice | 70,0 | 67,7 | 57,2 |
| BrowseComp | Trovare informazioni difficili sul web | 92,1 | 90,8 | 91,5 |
| OfficeQA Pro v2 | Analisi di documenti finanziari reali | 64,4 | 62,2 | 54,4 |
| OSWorld V2.1 | Usare un computer come una persona | 79,6 | 81,8 | 75,8 |
| HLE-Full senza strumenti | Le stesse domande, solo ragionando | 51,1 | 59,8 | 53,6 |
| Program Bench | Ricostruire programmi completi | 31,5 | 65,0 | 50,0 |
| PerceptionBench | Capire bene le immagini | 68,3 | 72,1 | 77,6 |
Il disegno è chiaro. Quando il modello può usare strumenti (cercare sul web, eseguire codice, lavorare per ore su un compito lungo) se la gioca con i migliori, e in alcuni casi li supera. Quando deve ragionare “a mani nude”, ricostruire programmi interi o leggere immagini con precisione, resta dietro ai modelli chiusi di Anthropic e OpenAI. Su HLE-Diamond, la parte più difficile di quel test, fa 39,4 contro il 60,9 di Opus 5.5 e il 65,8 di GPT-6 Astra.
Allucinazioni e sicurezza informatica
Due numeri del blog meritano attenzione. Il primo riguarda le informazioni inventate: su un test interno costruito apposta per far sbagliare i modelli, la quota di affermazioni false scende dal 23,4% di Kimi K3 all’8,3%. Moonshot stessa precisa che non è il tasso di errore nell’uso di tutti i giorni, ma la direzione è quella giusta, soprattutto per chi lo vuole usare su documenti finanziari.
Il secondo è più insolito. Prima di pubblicare i pesi, Moonshot ha tolto dai dati di addestramento i contenuti di sicurezza informatica offensiva, per non regalare a chiunque un modello capace di scrivere exploit. Il risultato si vede: su un test interno di sfruttamento di vulnerabilità la versione “pulita” risolve l’81% dei casi, contro il 90,5% che avrebbe raggiunto senza quel filtro, e su ExploitBench resta sotto Opus 5.5 e GPT-6 Astra.
Quanto costa Kimi K3.1 Pro e dove si usa
Secondo il listino ufficiale, via API costa 2 dollari per milione di token in input e 10 dollari per milione in output, con l’input già in memoria (cache) a 0,20 dollari. È meno di Kimi K3, che costava 3 e 15 dollari. Per i lavori che non devono rispondere subito c’è l’elaborazione in blocco (batch) al 60% del prezzo.
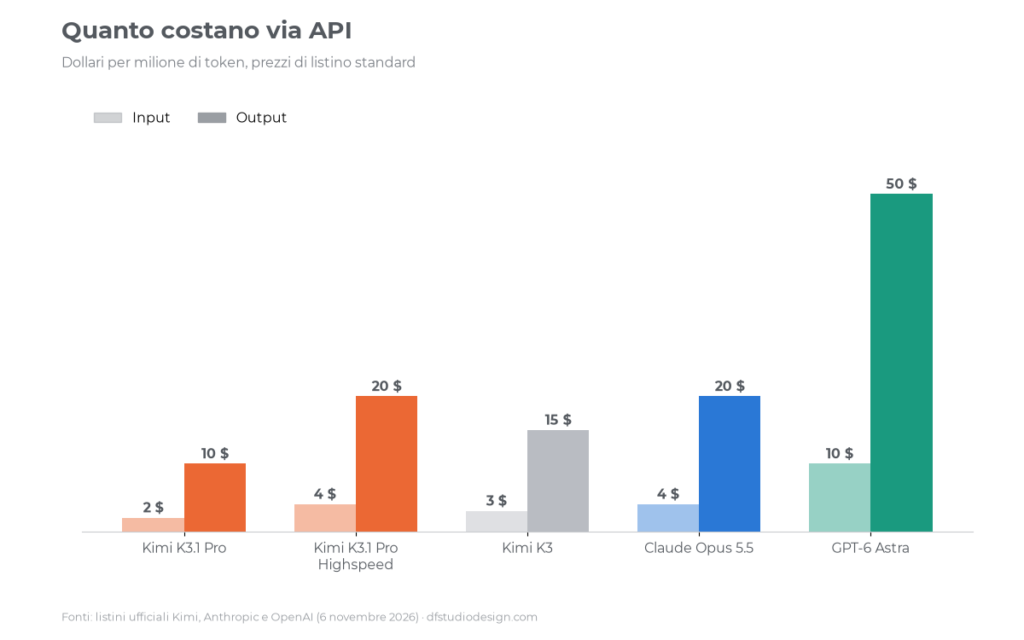
| Modello | Input | Output | Input in cache |
|---|---|---|---|
| Kimi K3.1 Pro | 2 $ | 10 $ | 0,20 $ |
| Kimi K3.1 Pro Highspeed | 4 $ | 20 $ | 0,20 $ |
| Kimi K3 | 3 $ | 15 $ | 0,30 $ |
| Claude Opus 5.5 | 4 $ | 20 $ | 0,20 $ |
| GPT-6 Astra | 10 $ | 50 $ | 1 $ |
Rispetto a GPT-6 Astra costa un quinto, e a parità di risultati su Terminal-Bench è un risparmio enorme. Rispetto a Opus 5.5 il discorso è diverso: Kimi costa la metà, ma la versione Highspeed, due o tre volte più veloce, costa esattamente quanto Opus 5.5. Nel confronto che avevo fatto tra Claude Opus 5.5 e GPT-6 il prezzo di Opus era già sceso parecchio, e qui si vede.
C’è poi la velocità, che il prezzo per token non racconta. Artificial Analysis misura circa 33 token al secondo, quasi tre minuti prima della prima risposta nelle domande difficili e 36 minuti in media per completare uno dei suoi compiti, contro i 13,5 della media dei modelli simili. Con il ragionamento al massimo (l’impostazione predefinita) è un modello lento e prolisso, e i token in più si pagano. Per abbassare i tempi si può scegliere il livello di ragionamento “low” o “high”, oppure passare alla versione Highspeed.
Dove si usa:
- Kimi.ai e app Kimi per iOS, Android e HarmonyOS, per chattare e usare gli agenti;
- Kimi Work, l’app desktop per Windows e Mac con chip Apple (dalla versione 3.1.0);
- Kimi Code, l’agente per programmare: si sceglie il modello con il comando /model;
- API con il nome kimi-k3.1-pro, compatibile con il formato di OpenAI e di Anthropic (la guida rapida spiega i parametri), con conservazione zero dei dati su richiesta;
- Kimi Business per le aziende: l’amministratore deve attivarlo, perché all’inizio è spento.
I pesi su Hugging Face: cosa puoi farci davvero
Moonshot aveva promesso i pesi entro il 4 novembre e ha mantenuto: il repository su Hugging Face è pubblico, senza moduli da compilare, e contiene 1,56 TB divisi in 96 file. È una buona notizia per chi fa ricerca e per le aziende che vogliono tenere i dati in casa. Ma “open-weight” non vuol dire che puoi farlo girare sul tuo computer.
Secondo la guida ufficiale di vLLM, la configurazione minima è un gruppo di 8 GPU di fascia altissima: due vassoi NVIDIA GB300 o un server B300, in alternativa un server AMD MI355X o 16 chip TPU di Google. Sono macchine da data center che costano centinaia di migliaia di euro. Se cerchi un modello da usare in locale sul PC, la strada resta quella dei modelli piccoli che si installano con Ollama.
Anche la licenza va letta. È una MIT modificata: puoi usare, modificare e rivendere il modello liberamente, con due eccezioni pensate per i grandi:
| Chi | Cosa deve fare |
|---|---|
| Aziende che vendono il modello come servizio (API) con più di 20 milioni di dollari di ricavi in 12 mesi | Firmare un accordo separato con Moonshot prima dell’uso commerciale |
| Prodotti con più di 100 milioni di utenti al mese o più di 20 milioni di dollari di ricavi al mese | Mostrare in modo visibile “Kimi K3.1-Pro” nell’interfaccia |
| Uso interno, o tramite i prodotti ufficiali di Moonshot e i partner certificati | Nessuna delle due condizioni |
Per una PMI, un’agenzia o uno sviluppatore, in pratica, la licenza non pone limiti.
A chi conviene
- A chi programma con agenti e spende molto con Opus o GPT-6 Astra: su Terminal-Bench e sui lavori lunghi dà risultati simili a un costo più basso, e si collega anche a Claude Code.
- A chi lavora su documenti e dati finanziari, dove ha i risultati migliori e meno informazioni inventate rispetto a K3.
- A chi fa modellazione 3D e progettazione parametrica: Moonshot ha puntato molto su Blender, CAD e motori di gioco come Unity, Unreal e Godot.
- Alle aziende che vogliono un modello di alto livello sui propri server, purché abbiano (o noleggino) l’hardware adatto.
Conviene meno a chi ha bisogno di risposte rapide, a chi lavora molto con le immagini e a chi deve ragionare su problemi difficili senza strumenti: lì i modelli chiusi restano davanti.
Cosa ne penso dopo aver messo in fila i numeri
Non ho ancora usato K3.1 Pro sui miei lavori, quindi quello che scrivo è una prova sui numeri: ho incrociato la tabella di Moonshot con i test indipendenti, i listini e la documentazione tecnica. Da più di dieci anni costruisco siti e li porto su Google, e negli ultimi due ho visto passare un modello “che batte tutti” quasi ogni mese: la differenza la fanno sempre i dettagli che non finiscono nel titolo.
Qui i dettagli sono buoni. Il punteggio su Terminal-Bench è confermato da due enti indipendenti, i pesi sono arrivati nella data promessa e la licenza è davvero permissiva per chi non è un colosso. Non capita spesso di vedere un modello aperto a un punto da Opus su un test così vicino al lavoro reale. Detto questo, non è “il nuovo Opus a metà prezzo”: è più lento, consuma più token e perde dove serve ragionare senza strumenti. Lo vedo bene come motore per agenti che lavorano a lungo, magari accanto a un modello chiuso per le parti più delicate, più che come sostituto unico. E se lavori già con GPT-6 Astra, è il primo confronto da fare sul serio, perché la differenza di prezzo è di cinque volte.
In due parole
Kimi K3.1 Pro è un modello open-weight da 2.800 miliardi di parametri che su Terminal-Bench 4.0 arriva al livello di Claude Opus 5.5 e supera GPT-6 Astra, con conferme indipendenti tra il 63,6% e il 67,2%. Costa 2 e 10 dollari per milione di token, ha i pesi pubblici su Hugging Face con una licenza permissiva, ma servono 8 GPU da data center per farlo girare. È forte negli agenti e nei lavori lunghi, più debole nel ragionamento puro e nella visione, ed è lento con il ragionamento al massimo.
FAQ
Cos’è Kimi K3.1 Pro?
È il modello di punta di Moonshot AI, uscito il 23 ottobre 2026. È una versione di Kimi K3 allenata più a lungo, con 2.800 miliardi di parametri totali, 104 miliardi attivi per token e un contesto da 1 milione di token.
I pesi sono davvero scaricabili?
Sì. Dal 4 novembre 2026 i pesi completi sono pubblici su Hugging Face, senza registrazione, sotto la licenza Kimi K3.1-Pro. Occupano circa 1,56 TB.
Quanto costa usarlo via API?
2 dollari per milione di token in input e 10 in output, 0,20 dollari per l’input in cache. La versione Highspeed costa il doppio (4 e 20 dollari) ed è due o tre volte più veloce.
È meglio di Claude Opus 5.5?
Su Terminal-Bench 4.0 sono praticamente alla pari, e Kimi vince in alcuni test con strumenti come SWE Marathon e BrowseComp. Opus 5.5 resta avanti nel ragionamento senza strumenti, nella ricostruzione di programmi completi e nella visione.
Posso farlo girare sul mio computer?
No. Servono almeno 8 GPU di fascia data center, come due vassoi NVIDIA GB300 o un server B300. Per usarlo senza quell’hardware c’è l’API o l’app Kimi.
Si può usare con Claude Code?
Sì. L’API di Kimi è compatibile con il formato di Anthropic, e Moonshot stessa ha misurato i benchmark di programmazione usando Claude Code.
Si può usare per lavoro, anche in un prodotto commerciale?
Sì. La licenza permette l’uso commerciale. Le uniche condizioni riguardano chi vende il modello come servizio con più di 20 milioni di dollari di ricavi annui e i prodotti con più di 100 milioni di utenti al mese.
Leggi anche:
Kimi Work: cos’è, come funziona e quanto costa l’agente desktop di Moonshot AI ·
MiniMax M3.1 Flash: novità, prezzi e benchmark del modello cinese per agenti AI ·
TokenEconomizer: cos’è e come taglia fino al 31% i costi di Claude Code, Codex e Copilot
Fonti
- Model card di Kimi K3.1 Pro su Hugging Face: architettura, tabella completa dei benchmark e note sui metodi.
- Moonshot AI, blog tecnico di Kimi K3.1 Pro: novità, disponibilità e scelte sulla sicurezza informatica.
- Listino ufficiale della piattaforma Kimi e licenza Kimi K3.1-Pro.
- vLLM Recipes, Kimi-K3.1-Pro: hardware necessario per farlo girare.
- Artificial Analysis e Vals AI: test indipendenti su Terminal-Bench 4.0, velocità e costi.
- Classifica ufficiale di Terminal-Bench 4.0.

Animazioni allo scroll in CSS: dal 2026 funzionano in tutti
Animazioni allo scroll in CSS: dal 2026 funzionano in tutti i browser, senza JavaScript Di Daniele Forciniti Dal 27 ottobre 2026 le…

Google sposta gli AI Overviews dei brand nella colonna destra
Google sposta gli AI Overviews dei brand nella colonna destra e prova a togliere AI Mode: cosa cambia per il…
Core Web Vitals nel 2026: cosa sono LCP, INP e
Core Web Vitals nel 2026: cosa sono LCP, INP e CLS e come migliorarli Di Daniele Forciniti I Core Web Vitals sono…
TokenEconomizer: cos’è e come taglia fino al 31% i costi
TokenEconomizer: cos’è e come taglia fino al 31% i costi di Claude Code, Codex e Copilot Di Daniele Forciniti TokenEconomizer è un…
Title, meta description e snippet nel 2026: come scriverli e
Title, meta description e snippet nel 2026: come scriverli e perché Google li cambia Di Daniele Forciniti Il title e la meta…
Gemini 4 Carbon: novità, benchmark e prezzi del modello più
Gemini 4 Carbon: novità, benchmark e prezzi del modello più potente di Google Di Daniele Forciniti Gemini 4 Carbon è il nuovo…