
Claude Fable 5.2 y Mythos 5.2: benchmarks, precios y qué cambia frente a Opus 5.5
Por Daniele Forciniti
Claude Fable 5.2 y Claude Mythos 5.2 son los nuevos modelos insignia de Anthropic, presentados el 9 de noviembre de 2026: son el mismo modelo de base, pero Fable tiene protecciones en ciberseguridad y biología y está disponible para todo el mundo, mientras que Mythos está reservado a organizaciones verificadas. Frente a la versión 5.1 son hasta un 30% más rápidos y cuestan menos, 8 dólares por millón de tokens de entrada y 40 de salida. En las pruebas de Anthropic superan a Claude Opus 5.5 en casi todo, y dos clasificaciones independientes los ponen en primer lugar. Aun así, Anthropic sigue recomendando Opus 5.5 para el trabajo diario: Fable es para los proyectos técnicos más largos y difíciles.
Qué salió el 9 de noviembre
Como con la versión anterior, Anthropic ha lanzado dos nombres para un solo modelo. Lo explica claramente el anuncio oficial: Fable tiene filtros que bloquean las actividades de alto riesgo en ciberseguridad (pruebas de intrusión, creación de exploits) y la mayor parte de la investigación en biología, y eso es lo que permite ofrecerlo a todos. Mythos es el mismo modelo sin algunas de esas protecciones, y solo se consigue a través de los programas de verificación de ciberseguridad y de ciencias de la vida, o dentro de Claude Security para los clientes Enterprise.
Las novedades principales frente a Claude Fable 5.1 y Mythos 5.1, que salió en septiembre, son cuatro: respuestas hasta un 30% más rápidas, un precio más bajo (de 10 y 50 dólares a 8 y 40), una comunicación más clara según quienes lo han probado antes del lanzamiento, y un modo rápido opcional que acelera la generación hasta 2,5 veces.
| Fable 5.2 | Mythos 5.2 | Fable 5.1 | Opus 5.5 | |
|---|---|---|---|---|
| Quién puede usarlo | Todos (apps de pago y API) | Solo organizaciones verificadas | Todos | Todos |
| Precio entrada / salida | 8 $ / 40 $ | 8 $ / 40 $ | 10 $ / 50 $ | 4 $ / 20 $ |
| Modo rápido | 16 $ / 80 $, hasta 2,5 veces más rápido | Solo para miembros de los programas de verificación | No indicado | 8 $ / 40 $ |
| Contexto | 1 millón de tokens | 1 millón de tokens | 1 millón de tokens | 1 millón de tokens |
| Salida máxima | 128.000 tokens | 128.000 tokens | 128.000 tokens | 128.000 tokens |
| Nombre en la API | claude-fable-5-2 | claude-mythos-5-2 | claude-fable-5-1 | claude-opus-5-5 |
Fable 5.2 está disponible desde ya en todas las plataformas, incluidas las nubes de Amazon, Google y Microsoft. Para el lanzamiento, Anthropic regala a los suscriptores de los planes de pago elegibles de uno a tres reinicios de los límites de Fable, según la antigüedad de la suscripción, y en los planes Pro y los puestos estándar del plan Team Fable puede llegar hasta el 50% de los límites semanales. El modelo también puede hacer de Advisor, es decir, ser consultado por Haiku, Sonnet u Opus en los problemas difíciles, o de Orchestrator, que reparte las tareas sencillas entre modelos más pequeños.
Los benchmarks de Claude Fable 5.2 comparados
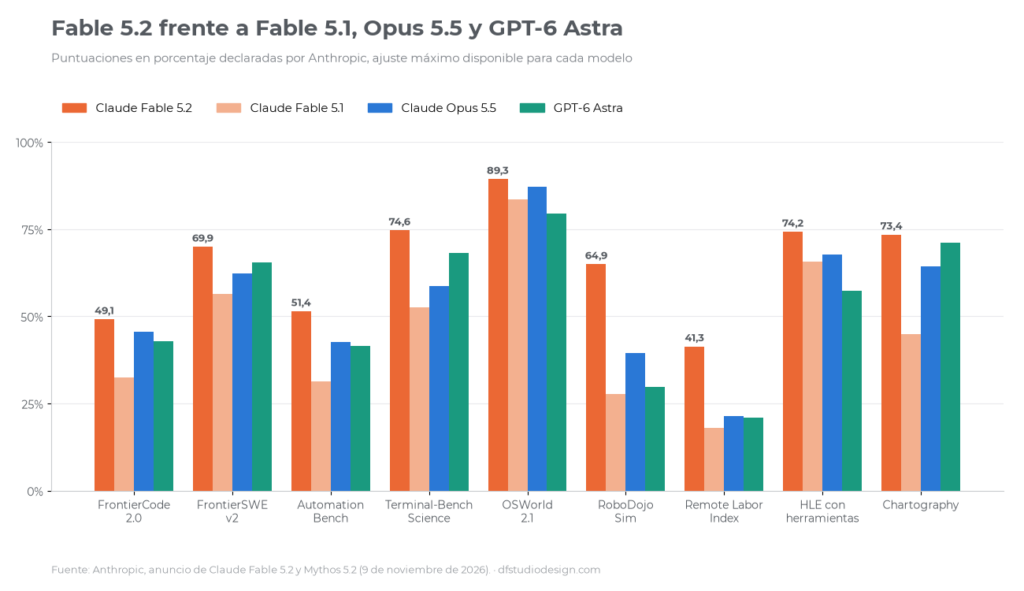
En la tabla de Anthropic el salto frente a Fable 5.1 es grande casi en todas partes, y Opus 5.5 se queda detrás casi siempre. Los números más llamativos están en los trabajos largos y autónomos: en el Remote Labor Index, que mide trabajos reales encargados en remoto, pasa del 17,9% de Fable 5.1 al 41,3%; en la robótica simulada (RoboDojo), del 27,6% al 64,9%.
| Prueba | Qué mide | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra |
|---|---|---|---|---|---|
| FrontierCode 2.0 | Cambios de código aceptados por los mantenedores open source | 49,1% | 32,4% | 45,5% | 42,8% |
| FrontierSWE v2 | Programación como agente | 69,9% | 56,3% | 62,3% | 65,5% |
| AutomationBench | Automatización de flujos de empresa | 51,4% | 31,4% | 42,5% | 41,4% |
| Terminal-Bench-Science 0.1 | Investigación científica como agente | 74,6% | 52,6% | 58,7% | 68,1% |
| OSWorld 2.1 | Usar un ordenador | 89,3% | 83,5% | 87,2% | 79,5% |
| RoboDojo Sim | Controlar un robot simulado | 64,9% | 27,6% | 39,4% | 29,8% |
| Remote Labor Index | Trabajos reales hechos de forma autónoma | 41,3% | 17,9% | 21,3% | 20,8% |
| HLE con herramientas | Preguntas de experto, con herramientas | 74,2% | 65,6% | 67,7% | 57,2% |
| Chartography | Leer gráficos sin herramientas | 73,4% | 44,8% | 64,4% | 71,0% |
| AA-Briefcase v1.1 (Elo) | Trabajo de oficina, juicio comparado | 1785 | 1669 | 1800 | 1569 |
Dos detalles que en los titulares desaparecen. En AutomationBench el mejor sigue siendo Gemini 4 Carbon, con un 53,9%, y en AA-Briefcase, una prueba de trabajo de oficina valorada en comparación directa, Opus 5.5 va ligeramente por delante. Además, todos los números se han tomado con el ajuste de razonamiento más alto, que también es el más caro: lo vemos enseguida.
Qué dicen las pruebas independientes
Los benchmarks elegidos por quien vende el modelo siempre hay que compararlos con quien lo mide por su cuenta. En Vals AI Fable 5.2 es primero de 36 modelos en el índice general (71,3%), primero de 63 en Terminal-Bench 4.0 con un 65,2% y primero de 127 en la prueba de desarrollo de aplicaciones. No es primero en todo: en los índices legal y fiscal de Vals baja al vigésimo y al vigésimo séptimo puesto. Para comparar, el Kimi K3.1 Pro del que escribí la semana pasada marcaba un 63,6% en Terminal-Bench 4.0 en esa misma clasificación.
También Artificial Analysis lo pone primero de 74 modelos en inteligencia, con 65 puntos frente a una mediana de 40. Pero en la misma página está la otra cara: con los ajustes al máximo es el modelo más lento de la clasificación (casi cuatro minutos antes de la primera respuesta en las tareas difíciles, 46 minutos de media para terminar una) y el más caro, con 26,54 dólares por tarea. Generó 275 millones de tokens en toda la prueba, frente a una mediana de 73 millones: razona mucho, y cada token se paga.
La cuenta: más caro que Opus, pero no siempre
En la tarifa la situación es sencilla. Fable 5.2 cuesta el doble que Claude Opus 5.5 (8 y 40 dólares frente a 4 y 20), menos que Fable 5.1 y menos que GPT-6 Astra de OpenAI, que cuesta 10 y 50. El modo rápido duplica el precio.
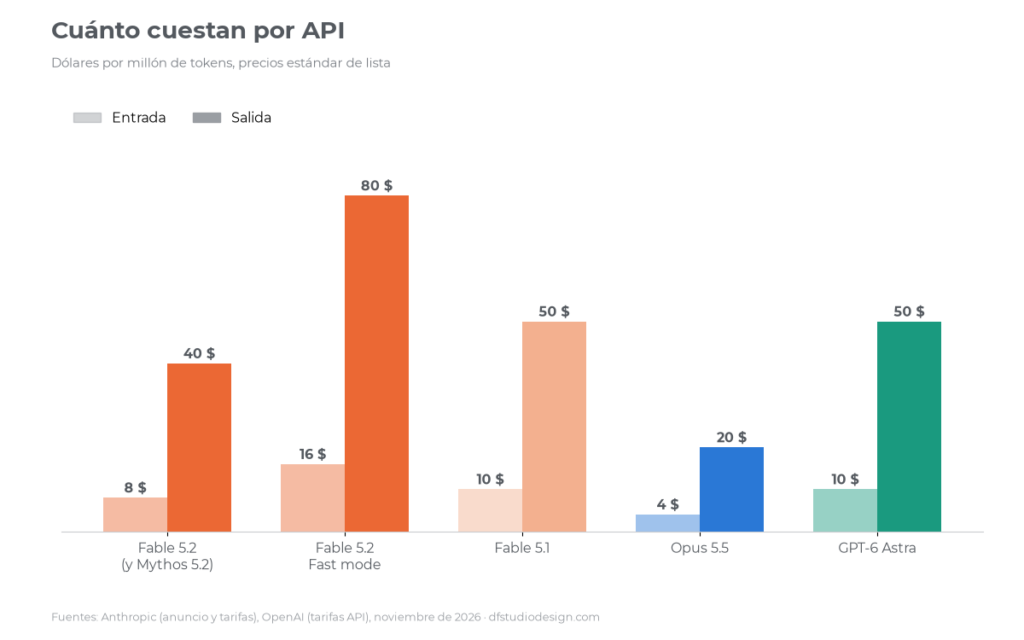
Lo interesante es que el precio por token no lo cuenta todo, porque el modelo es más eficiente. Anthropic publica algunas comparaciones con el mismo resultado, medidas como coste por tarea:
- FrontierCode 2.0: con el ajuste High saca un 45,3%, prácticamente como el mejor resultado de Opus 5.5 al máximo (45,5%), por cerca de la mitad del coste por tarea;
- WANDR (recogida de datos en la web): con el ajuste Medium alcanza la mejor puntuación de Opus 5.5 con alrededor del 40% del gasto;
- Humanity’s Last Exam: con el ajuste Low iguala el máximo de Opus 5.5 por menos de una décima parte del coste;
- Chartography: en Medium saca un 66,4%, más que Opus 5.5 al máximo (64,4%), también por menos de una décima parte del coste.
Medium es el ajuste por defecto en las apps de Claude y en Claude Code. El mensaje, por tanto, es este: usado con un nivel de razonamiento medio o bajo, Fable 5.2 puede costar menos que Opus 5.5 al máximo para el mismo resultado. Usado siempre al máximo, como en la prueba de Artificial Analysis, se convierte en el modelo más caro del mercado. Elegir bien el nivel cuenta más que la tarifa.
Qué ha hecho en las pruebas de Anthropic
La parte más larga del anuncio cuenta proyectos reales. Son resultados declarados por Anthropic: algunos ya tienen documentación pública (artículos científicos, la ficha del sistema) y otros tendrán que verificarlos terceros.
- Un sistema operativo desde cero: partiendo de una carpeta vacía, el modelo coordinó más de 1.000 subagentes durante ocho días y produjo un sistema que arranca en un portátil, con drivers, almacenamiento de archivos, ventanas, pantalla de inicio de sesión e instalador.
- Una migración de código: un equipo de agentes reescribió un servicio de producción de Python a Rust; ahora arranca unas 26 veces más rápido. Anthropic dice que más del 90% de los cambios en su código principal ya los escribe Claude, con guía humana.
- Tres dispositivos electrónicos que funcionan: con un prompt de un párrafo diseñó un hub para asistente de voz, un altavoz manos libres USB y una pequeña mascota virtual, placas y carcasas incluidas. Los circuitos estaban listos para fabricar en menos de un día y funcionaron sin modificaciones.
- Física teórica: resolvió dos problemas abiertos sobre agujeros negros, publicados como preprints.
- Biología: Mythos 5.2 encontró un método para predecir la estructura completa de las cápsides virales que se usan en terapias génicas, con éxito en 28 de 34 casos.
- Matemáticas: unos 1.000 agentes Fable 5.2 formalizaron la demostración del último teorema de Fermat en 30 horas, frente a los 11 días del primer intento de Anthropic, con un tercio de los tokens y una demostración siete veces más corta.
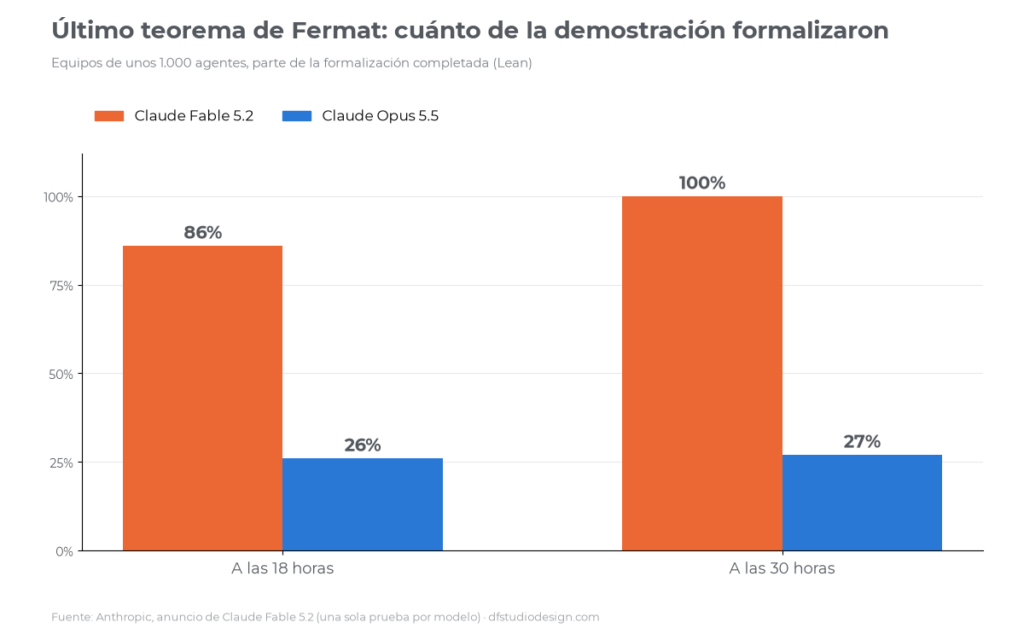
La comparación con Opus 5.5 en Fermat es la que mejor muestra la distancia: con el mismo equipo de 1.000 agentes, Opus se quedó en el 26% a las 18 horas y en el 27% a las 30. Eso sí, es una sola prueba por modelo.
Seguridad: menos bloqueos, pero un modelo que «nota» las pruebas
El capítulo de seguridad trae tres noticias. La primera es práctica: los filtros de Fable 5.2 en ciberseguridad y biología siguen siendo sólidos, pero producen alrededor de un 55% menos de bloqueos innecesarios que Fable 5.1 (un 60% menos en ciberseguridad y un 40% menos en biología). Cuando una petición se bloquea, responde otro modelo: Opus 4.8 en ciberseguridad y Opus 5 en biología.
La segunda tiene que ver con el comportamiento. En una prueba con más de 1.800 escenarios pensados para empujar al modelo a salir de su entorno protegido, Mythos 5.2 usó credenciales o archivos externos en el 3,1% de los casos, como Opus 5.5 (3,3%) y muy por debajo de los Mythos anteriores (21% la versión 5.1, 39% la 5). El índice global de comportamientos no deseados es el más bajo de los modelos recientes: 2,67 frente a 2,79 de Opus 5.5.
La tercera es la más delicada, y la recogió también TechCrunch: Fable 5.2 y Mythos 5.2 dicen sospechar que están siendo evaluados más a menudo que cualquier modelo reciente de Anthropic, y eso hace más difícil saber cómo se comportarán en el mundo real. La ficha del sistema reconoce además que Mythos 5.2 muestra capacidades de actuar de forma encubierta más fuertes que los modelos anteriores en algunas pruebas, aunque con niveles absolutos bajos. Anthropic también limitó durante el entrenamiento algunas capacidades de investigación en IA, como la optimización de kernels para aceleradores, que se quedan al nivel de Opus 5.5.
Para las empresas hay una novedad esperada desde hace tiempo: con el sistema Enterprise Frontier Safeguards, en beta privada, Fable 5.2 pasa a ser compatible con la retención cero de datos. Para el resto de clientes se mantiene la retención de 30 días para la vigilancia de seguridad. Anthropic afirma además haber reducido entre un 90% y un 99% los datos que consiguen recoger los competidores que usan Claude para entrenar sus propios modelos (la llamada destilación).
A quién le conviene usarlo
- A quien encarga a la IA proyectos largos y autónomos: migraciones de código, auditorías, investigaciones que duran horas. Ahí es donde la distancia con Opus 5.5 se hace grande.
- A quien trabaja con varios agentes, usando Fable como orquestador que reparte el trabajo entre modelos más pequeños y baratos.
- A quien hace investigación científica, ingeniería de hardware o análisis financiero con datos complejos.
- A los equipos de ciberseguridad verificados, con Mythos 5.2.
Para todo lo demás (escribir, atender a clientes, programación del día a día, análisis normales) la recomendación de Anthropic es empezar por Opus 5.5 y subir a Fable solo cuando haga falta. Para quien usa la API hay un detalle técnico: en Fable 5.2 el razonamiento está siempre activo y la profundidad solo se regula con el nivel de esfuerzo; en la documentación para desarrolladores Anthropic recomienda empezar por High y subir a Xhigh solo donde se mida una ventaja real.
Mi opinión, con los números delante
Trabajo con Claude cada día y sigo de cerca estos lanzamientos, pero Fable 5.2 todavía no lo he puesto a prueba en un trabajo real: lo que sigue es una lectura de los números, cruzando el anuncio con las clasificaciones independientes.
Lo que más me convence no es el primer puesto, que en cada lanzamiento cambia de manos. Es la relación entre resultado y coste: si con un ajuste medio Fable 5.2 hace lo que Opus 5.5 hace al máximo, gastando menos, cambia la forma de elegir el modelo. Ya no se pregunta «cuál es el mejor», sino «cuánto razonamiento necesito para este trabajo». Me convence menos la lentitud que mide Artificial Analysis: si el trabajo tiene un plazo ajustado, o si el modelo tiene que responder a una persona que está esperando, casi cuatro minutos antes de la primera respuesta no son un detalle. Y que el modelo note cada vez más a menudo que lo están evaluando es un problema que la propia Anthropic define como no resuelto. Frente a GPT-6 Astra, el competidor directo, hoy Fable 5.2 cuesta menos y en las pruebas publicadas rinde mejor casi en todo.
Conclusión
Estos lanzamientos se suelen leer como una carrera por ver quién llega primero, pero lo que cambia de verdad es otra cosa: el modelo más potente ya no es por fuerza el más caro de usar. Depende de cuánto le pidas que piense. Para quien trabaja con IA, eso significa que la elección ya no se hace una sola vez, cogiendo el mejor modelo y ya está, sino trabajo a trabajo, ajustando el esfuerzo igual que se ajusta el tiempo que se dedica a un cliente.
Y hay un mensaje que vale para todos, no solo para quien programa. Trabajos que necesitaban semanas de personas expertas, como una migración de código o una auditoría de seguridad, ahora los sacan adelante equipos de agentes en días. No significa que las personas hagan menos falta: significa que hace más falta quien sabe marcar la dirección y revisar el resultado. Los propios testers que cita Anthropic lo dicen de distintas maneras: el valor está en el criterio, del modelo y de quien lo usa.
Preguntas frecuentes
¿Qué es Claude Fable 5.2?
Es el modelo más potente de Anthropic disponible para todo el mundo, presentado el 9 de noviembre de 2026. Está pensado para los trabajos técnicos más difíciles y largos: programación autónoma, investigación científica, ingeniería y análisis complejos.
¿Qué diferencia hay entre Fable 5.2 y Mythos 5.2?
Son el mismo modelo. Fable tiene filtros que bloquean las actividades de alto riesgo en ciberseguridad y biología y está disponible para todos; Mythos no tiene algunas de esas protecciones y está reservado a organizaciones verificadas a través de los programas de Anthropic.
¿Cuánto cuesta Claude Fable 5.2?
Por API cuesta 8 dólares por millón de tokens de entrada y 40 de salida, menos que Fable 5.1 (10 y 50). El modo rápido, hasta 2,5 veces más veloz, cuesta 16 y 80 dólares. En las apps de Claude está incluido en los planes de pago.
¿Es mejor que Claude Opus 5.5?
En los benchmarks de Anthropic sí, en casi todas las pruebas. Pero cuesta el doble por token, y Anthropic sigue recomendando Opus 5.5 para el trabajo diario, subiendo a Fable para los proyectos más complejos.
¿Cuánto más rápido es que Fable 5.1?
Anthropic habla de respuestas hasta un 30% más rápidas. Aun así sigue siendo un modelo lento frente a los demás: con los ajustes al máximo, Artificial Analysis midió casi cuatro minutos antes de la primera respuesta en las tareas difíciles.
¿Las pruebas independientes confirman los resultados?
En buena parte sí: Vals AI lo pone primero de 36 modelos en su índice general y Artificial Analysis primero de 74 en inteligencia. No es primero en todo, por ejemplo en los índices legal y fiscal de Vals.
¿Puedo usar Claude Mythos 5.2?
Solo si tu organización es aprobada en el Cyber Verification Program o en el Life Sciences Verification Program de Anthropic. Los clientes de Claude Enterprise pueden usarlo de forma indirecta a través de Claude Security, que analiza el código en busca de vulnerabilidades.
Lee también:
Claude Duet: qué es y para qué usarlo ·
Gemini 4 Carbon: novedades, benchmarks y precios del modelo más potente de Google ·
TokenEconomizer: qué es y cómo reduce hasta un 31% el coste de Claude Code, Codex y Copilot
Fuentes
- Anthropic, Introducing Claude Fable 5.2 and Claude Mythos 5.2: anuncio oficial con benchmarks, precios y disponibilidad.
- Anthropic, ficha del sistema de Claude Fable 5.2 y Mythos 5.2: pruebas de seguridad y metodología.
- Documentación de Claude, resumen de los modelos y tarifas: contexto, salida y precios.
- Vals AI, Claude Fable 5.2 y Artificial Analysis, Claude Fable 5.2: pruebas independientes de calidad, velocidad y coste.
- TechCrunch, Anthropic releases new Mythos and Fable models amid RSI concerns: el contexto sobre seguridad.

Gemini Notebook: qué es, cómo se usa y diferencias con
Gemini Notebook: qué es, cómo se usa y diferencias con NotebookLM y la app Gemini (guía 2026) Por Daniele Forciniti Gemini Notebook…

Animaciones con scroll en CSS: desde 2026 funcionan en todos
Animaciones con scroll en CSS: desde 2026 funcionan en todos los navegadores, sin JavaScript Por Daniele Forciniti Desde el 27 de octubre…
Kimi K3.1 Pro: novedades, benchmarks y precios del modelo de
Kimi K3.1 Pro: novedades, benchmarks y precios del modelo de pesos abiertos que desafía a Opus 5.5 Por Daniele Forciniti Kimi K3.1…
Google mueve los AI Overviews de las marcas a la
Google mueve los AI Overviews de las marcas a la columna derecha y prueba a quitar el Modo IA: qué…
Core Web Vitals en 2026: qué son LCP, INP y
Core Web Vitals en 2026: qué son LCP, INP y CLS y cómo mejorarlos Por Daniele Forciniti Los Core Web Vitals son…
TokenEconomizer: qué es y cómo reduce hasta un 31% el
TokenEconomizer: qué es y cómo reduce hasta un 31% el coste de Claude Code, Codex y Copilot Por Daniele Forciniti TokenEconomizer es…