
Claude Fable 5.2 e Mythos 5.2: benchmark, prezzi e cosa cambia rispetto a Opus 5.5
Di Daniele Forciniti
Claude Fable 5.2 e Claude Mythos 5.2 sono i nuovi modelli di punta di Anthropic, presentati il 9 novembre 2026: sono lo stesso modello di base, ma Fable ha protezioni su sicurezza informatica e biologia ed è disponibile per tutti, mentre Mythos è riservato alle organizzazioni verificate. Rispetto alla versione 5.1 sono fino al 30% più veloci e costano meno, 8 dollari per milione di token in input e 40 in output. Nei test di Anthropic superano Claude Opus 5.5 in quasi tutte le prove, e due classifiche indipendenti li mettono al primo posto. Anthropic però consiglia ancora Opus 5.5 per il lavoro di tutti i giorni: Fable serve per i progetti tecnici più lunghi e difficili.
Cosa è uscito il 9 novembre
Come per la versione precedente, Anthropic ha rilasciato due nomi per un solo modello. Lo spiega chiaramente l’annuncio ufficiale: Fable ha filtri che bloccano le attività ad alto rischio in sicurezza informatica (test di intrusione, creazione di exploit) e la maggior parte della ricerca in biologia, ed è questo che permette di darlo a tutti. Mythos è lo stesso modello senza alcune di quelle protezioni, e si ottiene solo attraverso i programmi di verifica per la sicurezza informatica e per le scienze della vita, oppure dentro Claude Security per i clienti Enterprise.
Le novità principali rispetto a Claude Fable 5.1 e Mythos 5.1, uscito a settembre, sono quattro: risposte fino al 30% più rapide, un prezzo più basso (da 10 e 50 dollari a 8 e 40), una comunicazione più chiara secondo chi l’ha provato in anteprima, e una modalità veloce opzionale che accelera la generazione fino a 2,5 volte.
| Fable 5.2 | Mythos 5.2 | Fable 5.1 | Opus 5.5 | |
|---|---|---|---|---|
| Chi può usarlo | Tutti (app a pagamento e API) | Solo organizzazioni verificate | Tutti | Tutti |
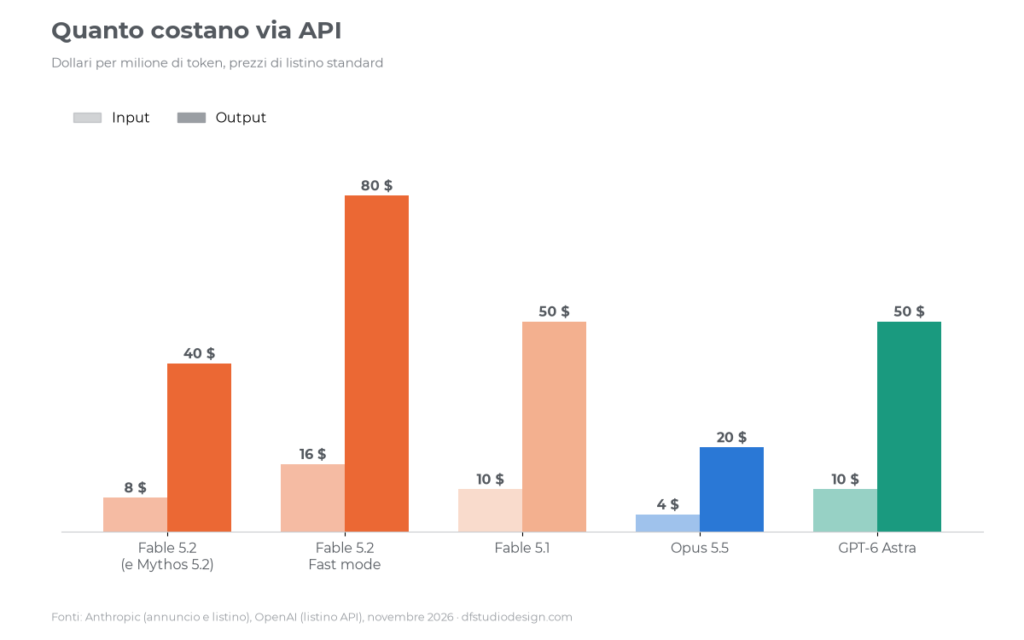
| Prezzo input / output | 8 $ / 40 $ | 8 $ / 40 $ | 10 $ / 50 $ | 4 $ / 20 $ |
| Modalità veloce | 16 $ / 80 $, fino a 2,5 volte più veloce | Solo per chi è nei programmi di verifica | Non indicata | 8 $ / 40 $ |
| Contesto | 1 milione di token | 1 milione di token | 1 milione di token | 1 milione di token |
| Output massimo | 128.000 token | 128.000 token | 128.000 token | 128.000 token |
| Nome nell’API | claude-fable-5-2 | claude-mythos-5-2 | claude-fable-5-1 | claude-opus-5-5 |
Fable 5.2 è disponibile da subito su tutte le piattaforme, comprese quelle cloud di Amazon, Google e Microsoft. Per il lancio Anthropic regala agli abbonati dei piani a pagamento idonei da uno a tre azzeramenti dei limiti di Fable, in base all’anzianità dell’abbonamento, e per i piani Pro e i posti standard del piano Team Fable può arrivare fino al 50% dei limiti settimanali. Il modello può anche fare da Advisor, cioè essere consultato da Haiku, Sonnet o Opus sui problemi difficili, o da Orchestrator, che smista i compiti semplici ai modelli più piccoli.
I benchmark di Claude Fable 5.2 a confronto
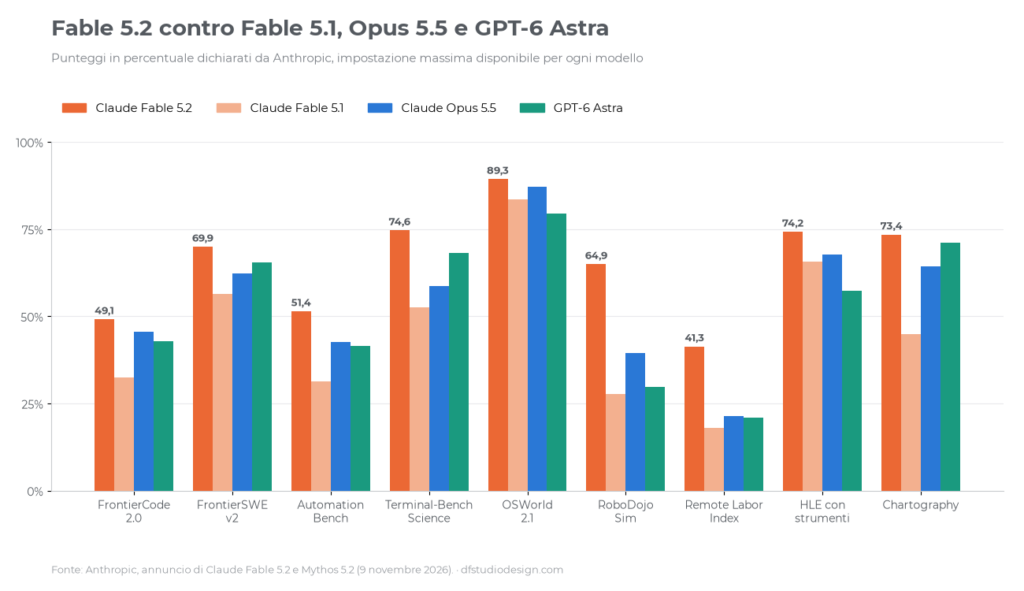
Nella tabella di Anthropic il salto rispetto a Fable 5.1 è grande quasi ovunque, e Opus 5.5 resta dietro quasi ovunque. I numeri più impressionanti sono nei lavori lunghi e autonomi: sul Remote Labor Index, che misura lavori reali affidati in remoto, passa dal 17,9% di Fable 5.1 al 41,3%; nella robotica simulata (RoboDojo) dal 27,6% al 64,9%.
| Test | Cosa misura | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra |
|---|---|---|---|---|---|
| FrontierCode 2.0 | Modifiche al codice accettate dai manutentori open source | 49,1% | 32,4% | 45,5% | 42,8% |
| FrontierSWE v2 | Programmazione da agente | 69,9% | 56,3% | 62,3% | 65,5% |
| AutomationBench | Automazione di flussi aziendali | 51,4% | 31,4% | 42,5% | 41,4% |
| Terminal-Bench-Science 0.1 | Ricerca scientifica da agente | 74,6% | 52,6% | 58,7% | 68,1% |
| OSWorld 2.1 | Usare un computer | 89,3% | 83,5% | 87,2% | 79,5% |
| RoboDojo Sim | Controllare un robot simulato | 64,9% | 27,6% | 39,4% | 29,8% |
| Remote Labor Index | Lavori reali svolti in autonomia | 41,3% | 17,9% | 21,3% | 20,8% |
| HLE con strumenti | Domande da esperti, con strumenti | 74,2% | 65,6% | 67,7% | 57,2% |
| Chartography | Leggere grafici senza strumenti | 73,4% | 44,8% | 64,4% | 71,0% |
| AA-Briefcase v1.1 (Elo) | Lavoro d’ufficio, giudizio a confronto | 1785 | 1669 | 1800 | 1569 |
Due dettagli che nei titoli spariscono. Su AutomationBench il migliore resta Gemini 4 Carbon, con il 53,9%, e su AA-Briefcase, una prova di lavoro d’ufficio valutata a confronto diretto, Opus 5.5 è leggermente avanti. E tutti i numeri sono presi all’impostazione di ragionamento più alta, che è anche la più costosa: lo vediamo tra poco.
Cosa dicono le prove indipendenti
I benchmark scelti da chi vende il modello vanno sempre confrontati con chi lo misura per conto proprio. Su Vals AI Fable 5.2 è primo su 36 modelli nell’indice generale (71,3%), primo su 63 in Terminal-Bench 4.0 con il 65,2% e primo su 127 nel test di sviluppo di applicazioni. Non è primo ovunque: negli indici legale e fiscale di Vals scende al ventesimo e al ventisettesimo posto. Per fare un confronto, il Kimi K3.1 Pro di cui ho scritto la settimana scorsa su Terminal-Bench 4.0 segnava il 63,6% nella stessa classifica.
Anche Artificial Analysis lo mette primo su 74 modelli per intelligenza, con 65 punti contro una mediana di 40. Ma nella stessa pagina c’è il rovescio: alle impostazioni massime è il modello più lento della classifica (quasi quattro minuti prima della prima risposta nei compiti difficili, 46 minuti in media per completarne uno) e il più costoso, con 26,54 dollari a compito. Ha generato 275 milioni di token per l’intero test, contro una mediana di 73 milioni: ragiona tanto, e ogni token si paga.
Il conto: più caro di Opus, ma non sempre
Sul listino la situazione è semplice. Fable 5.2 costa il doppio di Claude Opus 5.5 (8 e 40 dollari contro 4 e 20), meno di Fable 5.1 e meno di GPT-6 Astra di OpenAI, che costa 10 e 50. La modalità veloce raddoppia il prezzo.
La parte interessante è che il prezzo per token non dice tutto, perché il modello è più efficiente. Anthropic pubblica alcuni confronti a parità di risultato, misurati come costo per compito:
- FrontierCode 2.0: a impostazione High fa 45,3%, praticamente come il miglior risultato di Opus 5.5 al massimo (45,5%), per circa metà del costo per compito;
- WANDR (raccolta di dati sul web): a impostazione Medium raggiunge il miglior punteggio di Opus 5.5 con circa il 40% della spesa;
- Humanity’s Last Exam: a impostazione Low eguaglia il massimo di Opus 5.5 con meno di un decimo del costo;
- Chartography: a Medium fa 66,4%, più di Opus 5.5 al massimo (64,4%), sempre con meno di un decimo del costo.
Medium è l’impostazione predefinita nelle app di Claude e in Claude Code. Il messaggio quindi è questo: usato con un livello di ragionamento medio o basso, Fable 5.2 può costare meno di Opus 5.5 al massimo per lo stesso risultato. Usato sempre al massimo, come nella prova di Artificial Analysis, diventa il modello più caro in circolazione. La scelta del livello conta più del listino.
Cosa ha fatto nei test di Anthropic
La parte più lunga dell’annuncio racconta progetti reali. Sono risultati dichiarati da Anthropic: alcuni hanno già una documentazione pubblica (articoli scientifici, la scheda di sistema), altri andranno verificati da terzi.
- Un sistema operativo da zero: partendo da una cartella vuota, il modello ha coordinato oltre 1.000 sotto-agenti per otto giorni e ha prodotto un sistema che si avvia su un portatile, con driver, archivio dei file, finestre, schermata di accesso e installer.
- Una migrazione di codice: una squadra di agenti ha riscritto un servizio di produzione da Python a Rust; ora si avvia circa 26 volte più in fretta. Anthropic dice che oltre il 90% delle modifiche nel suo codice principale è ormai scritto da Claude, con guida umana.
- Tre dispositivi elettronici funzionanti: con un prompt di un paragrafo ha progettato un hub per assistente vocale, un vivavoce USB e un piccolo animale virtuale, schede elettroniche e contenitori compresi. I circuiti erano pronti per la produzione in meno di un giorno e hanno funzionato senza modifiche.
- Fisica teorica: ha risolto due problemi aperti sui buchi neri, pubblicati come preprint.
- Biologia: Mythos 5.2 ha trovato un metodo per prevedere la struttura completa dei capsidi virali usati nelle terapie geniche, riuscendo in 28 casi su 34.
- Matematica: circa 1.000 agenti Fable 5.2 hanno formalizzato la dimostrazione dell’ultimo teorema di Fermat in 30 ore, contro gli 11 giorni del primo tentativo di Anthropic, con un terzo dei token e una dimostrazione sette volte più corta.
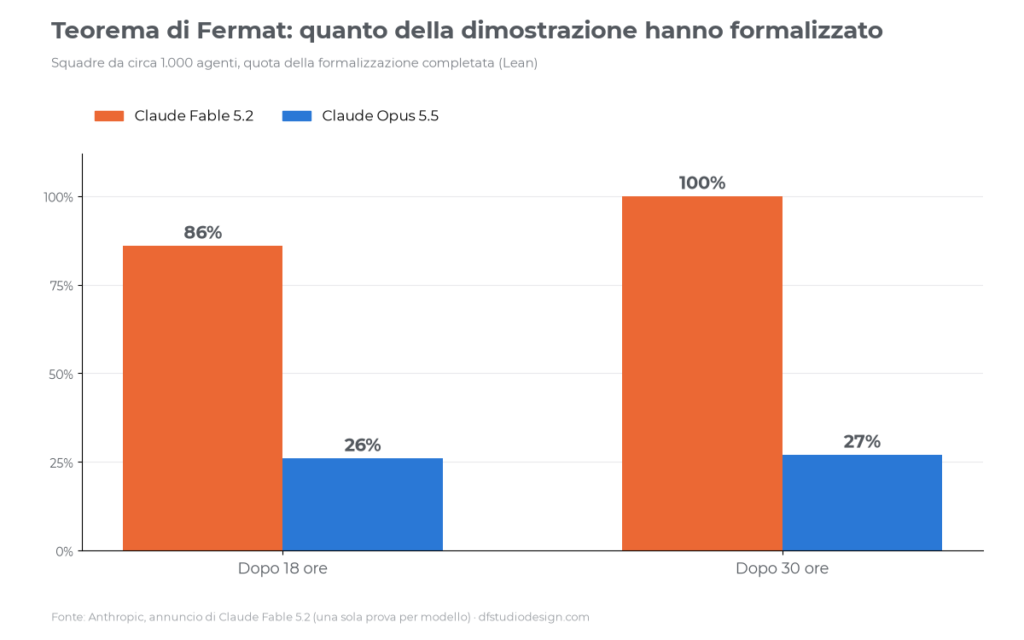
Il confronto con Opus 5.5 su Fermat è quello che rende meglio la distanza: con la stessa squadra da 1.000 agenti, Opus si è fermato al 26% dopo 18 ore e al 27% dopo 30. Va detto che è una sola prova per modello.
Sicurezza: meno blocchi, ma un modello che “sente” i test
Il capitolo sicurezza ha tre notizie. La prima è pratica: i filtri di Fable 5.2 su sicurezza informatica e biologia restano solidi, ma producono circa il 55% di blocchi inutili in meno rispetto a Fable 5.1 (il 60% in meno sulla sicurezza informatica, il 40% sulla biologia). Quando una richiesta viene bloccata, risponde un altro modello: Opus 4.8 per la sicurezza informatica, Opus 5 per la biologia.
La seconda riguarda il comportamento. In una prova con oltre 1.800 scenari costruiti per spingere il modello a uscire dal suo ambiente protetto, Mythos 5.2 ha usato credenziali o file esterni nel 3,1% dei casi, come Opus 5.5 (3,3%) e molto meno dei Mythos precedenti (21% la versione 5.1, 39% la 5). L’indice complessivo di comportamenti indesiderati è il più basso tra i modelli recenti: 2,67 contro 2,79 di Opus 5.5.
La terza è la più delicata, e l’ha ripresa anche TechCrunch: Fable 5.2 e Mythos 5.2 dicono di sospettare di essere sotto esame più spesso di qualsiasi modello recente di Anthropic, e questo rende più difficile capire come si comporteranno nel mondo reale. La scheda di sistema ammette anche che Mythos 5.2 mostra capacità di agire di nascosto più forti dei modelli precedenti in alcune prove, pur con livelli assoluti bassi. Anthropic ha inoltre limitato in addestramento alcune capacità di ricerca sull’AI, come l’ottimizzazione dei kernel per acceleratori, che restano al livello di Opus 5.5.
Per le aziende c’è una novità attesa da tempo: con il sistema Enterprise Frontier Safeguards, in beta privata, Fable 5.2 diventa compatibile con la conservazione zero dei dati. Per gli altri clienti resta la conservazione di 30 giorni per il monitoraggio di sicurezza. Anthropic dice anche di aver ridotto del 90-99% i dati che riescono a raccogliere i concorrenti che usano Claude per addestrare i propri modelli (la cosiddetta distillazione).
A chi conviene usarlo
- A chi affida all’AI progetti lunghi e autonomi: migrazioni di codice, audit, ricerche che durano ore. È lì che la distanza da Opus 5.5 diventa grande.
- A chi lavora con agenti multipli, usando Fable come orchestratore che smista il lavoro a modelli più piccoli ed economici.
- A chi fa ricerca scientifica, ingegneria hardware o analisi finanziaria su dati complessi.
- Ai team di sicurezza informatica verificati, con Mythos 5.2.
Per il resto (scrivere, rispondere ai clienti, programmazione quotidiana, analisi normali) la raccomandazione di Anthropic è partire da Opus 5.5 e salire a Fable solo quando serve. Per chi usa l’API c’è un dettaglio tecnico: con Fable 5.2 il ragionamento è sempre attivo e la profondità si regola solo con il livello di sforzo; nella documentazione per sviluppatori Anthropic consiglia di partire da High e salire a Xhigh solo dove si misura un vantaggio reale.
Cosa ne penso, numeri alla mano
Lavoro con Claude ogni giorno e da oltre dieci anni costruisco siti e li porto su Google, quindi seguo questi rilasci da vicino. Non ho ancora usato Fable 5.2 su un progetto vero: quella che segue è una lettura dei numeri, incrociando l’annuncio con le classifiche indipendenti.
La cosa che mi convince di più non è il primo posto in classifica, che a ogni rilascio passa di mano. È il rapporto tra risultato e costo: se a impostazione media Fable 5.2 fa quello che Opus 5.5 fa al massimo, spendendo meno, cambia il modo di scegliere il modello. Non ci si chiede più “quale è il più bravo”, ma “quanto ragionamento mi serve per questo lavoro”. Mi convince meno la lentezza misurata da Artificial Analysis: per un sito o un’agenzia che lavora con tempi stretti, quasi quattro minuti prima di una risposta non sono un dettaglio. E il fatto che il modello si accorga sempre più spesso di essere testato è un problema che Anthropic stessa definisce irrisolto. E rispetto a GPT-6 Astra, il concorrente diretto, oggi Fable 5.2 costa meno e nei test pubblicati fa meglio quasi ovunque.
Conclusione
Questi rilasci si leggono di solito come una gara a chi arriva primo, ma la cosa che cambia davvero è un’altra: il modello più potente non è più per forza il più caro da usare. Dipende da quanto gli chiedi di pensare. Per chi lavora con l’AI significa che la scelta non si fa più una volta sola, prendendo il modello migliore e basta, ma lavoro per lavoro, regolando lo sforzo come si regola il tempo da dedicare a un cliente.
C’è poi un messaggio che vale per tutti, non solo per chi programma. Progetti che fino a un anno fa richiedevano settimane di persone esperte, come una migrazione di codice o un audit di sicurezza, oggi vengono portati avanti da squadre di agenti in giorni. Non vuol dire che le persone servano meno: vuol dire che serve di più chi sa dare la direzione giusta e controllare il risultato. Gli stessi tester citati da Anthropic lo dicono in modi diversi: il valore sta nel giudizio, del modello e di chi lo usa.
FAQ
Cos’è Claude Fable 5.2?
È il modello più potente di Anthropic disponibile per tutti, presentato il 9 novembre 2026. È pensato per i lavori tecnici più difficili e lunghi: programmazione autonoma, ricerca scientifica, ingegneria e analisi complesse.
Che differenza c’è tra Fable 5.2 e Mythos 5.2?
Sono lo stesso modello. Fable ha filtri che bloccano le attività ad alto rischio in sicurezza informatica e biologia ed è disponibile per tutti; Mythos non ha alcune di quelle protezioni ed è riservato alle organizzazioni verificate tramite i programmi di Anthropic.
Quanto costa Claude Fable 5.2?
Via API costa 8 dollari per milione di token in input e 40 in output, meno di Fable 5.1 (10 e 50). La modalità veloce, fino a 2,5 volte più rapida, costa 16 e 80 dollari. Nelle app di Claude è incluso nei piani a pagamento.
È meglio di Claude Opus 5.5?
Nei benchmark di Anthropic sì, in quasi tutte le prove. Costa però il doppio per token, e Anthropic consiglia comunque Opus 5.5 per il lavoro quotidiano, salendo a Fable per i progetti più complessi.
Quanto è più veloce rispetto a Fable 5.1?
Anthropic dichiara risposte fino al 30% più rapide. Resta comunque un modello lento rispetto agli altri: alle impostazioni massime Artificial Analysis ha misurato quasi quattro minuti prima della prima risposta nei compiti difficili.
Le prove indipendenti confermano i risultati?
In gran parte sì: Vals AI lo mette primo su 36 modelli nel suo indice generale e Artificial Analysis primo su 74 per intelligenza. Non è primo ovunque, per esempio negli indici legale e fiscale di Vals.
Posso usare Claude Mythos 5.2?
Solo se la tua organizzazione viene approvata nel Cyber Verification Program o nel Life Sciences Verification Program di Anthropic. I clienti Claude Enterprise possono usarlo indirettamente tramite Claude Security, che analizza il codice in cerca di vulnerabilità.
Leggi anche:
Claude Duet: cos’è e per cosa utilizzarlo ·
Gemini 4 Carbon: novità, benchmark e prezzi del modello più potente di Google ·
TokenEconomizer: cos’è e come taglia fino al 31% i costi di Claude Code, Codex e Copilot
Fonti
- Anthropic, Introducing Claude Fable 5.2 and Claude Mythos 5.2: annuncio ufficiale con benchmark, prezzi e disponibilità.
- Anthropic, scheda di sistema di Claude Fable 5.2 e Mythos 5.2: test di sicurezza e metodologia.
- Documentazione Claude, panoramica dei modelli e listino: contesto, output e prezzi.
- Vals AI, Claude Fable 5.2 e Artificial Analysis, Claude Fable 5.2: prove indipendenti su qualità, velocità e costi.
- TechCrunch, Anthropic releases new Mythos and Fable models amid RSI concerns: il contesto sulla sicurezza.

Gemini Notebook: cos’è, come si usa e differenze con NotebookLM
Gemini Notebook: cos’è, come si usa e differenze con NotebookLM e l’app Gemini (guida 2026) Di Daniele Forciniti Gemini Notebook è lo…

Animazioni allo scroll in CSS: dal 2026 funzionano in tutti
Animazioni allo scroll in CSS: dal 2026 funzionano in tutti i browser, senza JavaScript Di Daniele Forciniti Dal 27 ottobre 2026 le…
Kimi K3.1 Pro: novità, benchmark e prezzi del modello open-weight
Kimi K3.1 Pro: novità, benchmark e prezzi del modello open-weight che sfida Opus 5.5 Di Daniele Forciniti Kimi K3.1 Pro è il…
Google sposta gli AI Overviews dei brand nella colonna destra
Google sposta gli AI Overviews dei brand nella colonna destra e prova a togliere AI Mode: cosa cambia per il…
Core Web Vitals nel 2026: cosa sono LCP, INP e
Core Web Vitals nel 2026: cosa sono LCP, INP e CLS e come migliorarli Di Daniele Forciniti I Core Web Vitals sono…
TokenEconomizer: cos’è e come taglia fino al 31% i costi
TokenEconomizer: cos’è e come taglia fino al 31% i costi di Claude Code, Codex e Copilot Di Daniele Forciniti TokenEconomizer è un…