
Qwen4-Max: novedades, benchmarks y precios del nuevo modelo insignia de Alibaba
Por Daniele Forciniti
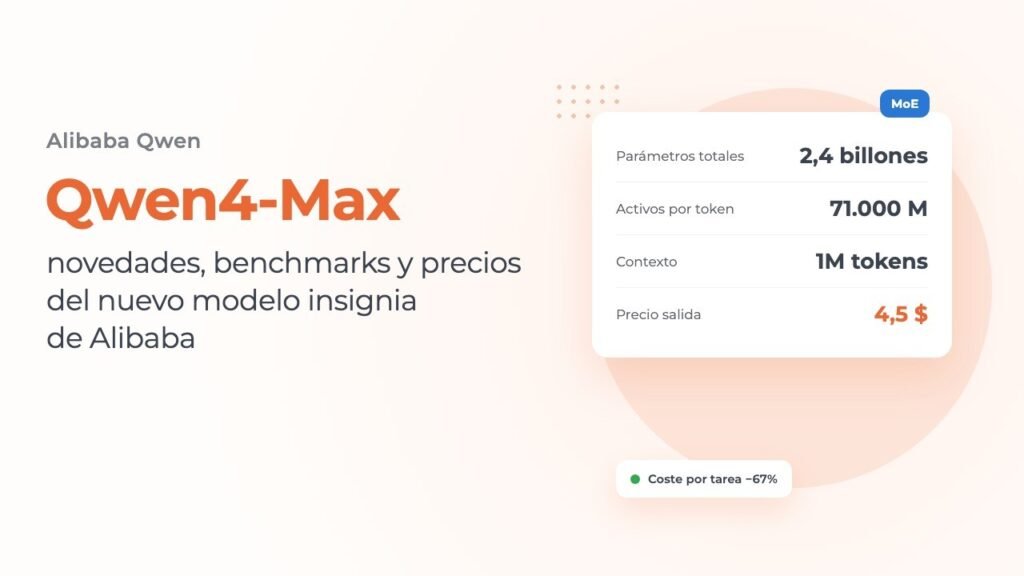
Qwen4-Max es el nuevo modelo insignia de Alibaba, lanzado el 16 de noviembre de 2026: un modelo de expertos (MoE) de 2,4 billones de parámetros, de los que 71.000 millones se activan en cada token, que entiende texto, imágenes y vídeo y trabaja con un contexto de 1 millón de tokens. No es de pesos abiertos: se usa por API en QwenCloud o dentro de las apps de Alibaba. Cuesta 1,5 dólares por millón de tokens de entrada y 4,5 de salida, menos que el modelo anterior, y según las pruebas independientes de Artificial Analysis completa una tarea por 3,27 dólares, un 67% menos que Qwen3.8-Max. En los benchmarks destaca en el trabajo como agente y en tareas legales, pero se queda por detrás de Claude Opus 5.5 y de los modelos de OpenAI en bastantes pruebas, sobre todo de programación.
Qué trae de nuevo frente a Qwen3.8-Max
Alibaba lo presenta como un «compañero de IA» que trabaja las 24 horas y saca adelante los proyectos por su cuenta. Más allá del eslogan, el blog oficial del equipo Qwen describe un cambio de verdad: Qwen4-Max es el primer modelo construido sobre la nueva arquitectura de la serie Qwen4, no una versión más entrenada de la generación anterior.
El tamaño total es el mismo que el de Qwen3.8-Max, 2,4 billones de parámetros, pero para cada palabra que escribe usa 71.000 millones en lugar de unos 95.000: un 25% menos. Un modelo de expertos funciona así: dentro hay muchos «especialistas» y en cada token solo se llama a unos pocos. Menos parámetros activos significa respuestas más baratas de producir, y de ahí viene buena parte de la bajada de precios.
Las novedades técnicas son tres, y las cuento de la forma más sencilla posible:
- Una nueva forma de leer textos largos. En lugar de releer todo el contexto en cada palabra, algunas capas (Gated DeltaNet) resumen el historial en un espacio fijo, y un sistema de atención dispersa (Qwen Sparse Attention) va a buscar solo los trozos que hacen falta. Es lo que le permite aguantar 1 millón de tokens sin que el coste se dispare.
- Conexiones internas más sólidas. Cuatro «carriles» en paralelo llevan la información de una capa a otra y hacen el entrenamiento más estable. Alibaba asegura que en todo el entrenamiento a 2,4 billones de parámetros no hubo picos anómalos en la curva de aprendizaje, algo poco habitual a esta escala.
- Una memoria de secuencias frecuentes. Hay otros 328.000 millones de parámetros (N-gram Embedding) que funcionan como un diccionario de combinaciones de palabras habituales, que se consulta casi sin coste.
| Característica | Qwen4-Max |
|---|---|
| Arquitectura | Mixture-of-Experts (modelo de expertos), nueva generación Qwen4 |
| Parámetros totales | 2,4 billones, más 328.000 millones de N-gram Embedding |
| Parámetros activos por token | 71.000 millones (Qwen3.8-Max, unos 95.000 millones) |
| Contexto | 1 millón de tokens (hasta 991.000 de entrada) |
| Respuesta máxima | 393.000 tokens |
| Qué entiende | Texto, imágenes y vídeo |
| Qué genera | Texto y código |
| Pesos | No descargables, modelo cerrado |
| Lanzamiento | 16 de noviembre de 2026 |
Menos tokens para el mismo trabajo
El punto en el que más insiste Alibaba es la eficiencia. Los modelos de razonamiento «piensan» escribiendo, y cada palabra pensada es un token que se paga. Qwen4-Max tiene varios niveles de esfuerzo (Low, High, Xhigh): en la prueba interna Work360 usa un 24% menos de tokens en nivel Xhigh y un 35% menos en nivel High que Qwen3.8-Max, y en Terminal-Bench 4.0 el ahorro llega al 48-49%. Con precios más bajos y menos tokens, el coste medio por tarea en Work360 baja de 4,43 a 1,67 dólares, según Alibaba.
Work360 es una prueba creada por la propia Alibaba: cubre 26 grandes sectores, 182 subsectores y 721 especialidades profesionales, y mide cómo resuelve el modelo trabajos reales de esos oficios. Qwen4-Max saca 52,69 puntos frente a los 47,74 de la versión anterior. Es buena señal, pero sigue siendo una prueba de casa: por eso más abajo miro también los números de quien no vende el modelo.
Seguridad: código más seguro y datos filtrados
Una parte del anuncio está dedicada a la seguridad, y es la que destacó la agencia EFE en su noticia. Alibaba explica que ha quitado de los datos de entrenamiento el material que sirve para atacar sistemas informáticos, y ha mantenido el que sirve para defenderse (detectar y corregir vulnerabilidades). En el código los números son concretos: en la prueba Last Secure Code Bench, el porcentaje de funciones correctas y seguras sube del 22,0% al 31,8%, y el código seguro en todos los niveles (función, archivo y proyecto) pasa del 8% al 14,7%. Casi el doble, pero también quiere decir que la gran mayoría del código generado hay que seguir revisándolo.
Los benchmarks: dónde gana y dónde se queda atrás
La tabla del anuncio enfrenta a Qwen4-Max con Qwen3.8-Max, Claude Opus 5.5, GPT-6.1 Sol, GPT-6 Astra y Kimi K3.1 Pro en 16 pruebas. Un detalle importante: no todos los números los ha medido Alibaba. Los de AA-Briefcase y AutomationBench vienen de Artificial Analysis, CodeArena y AgentArena de los rankings de Arena, HLAB del Vals Index y APEX-Agents del ranking de Mercor. Para la tabla de un fabricante, es más transparente de lo habitual.
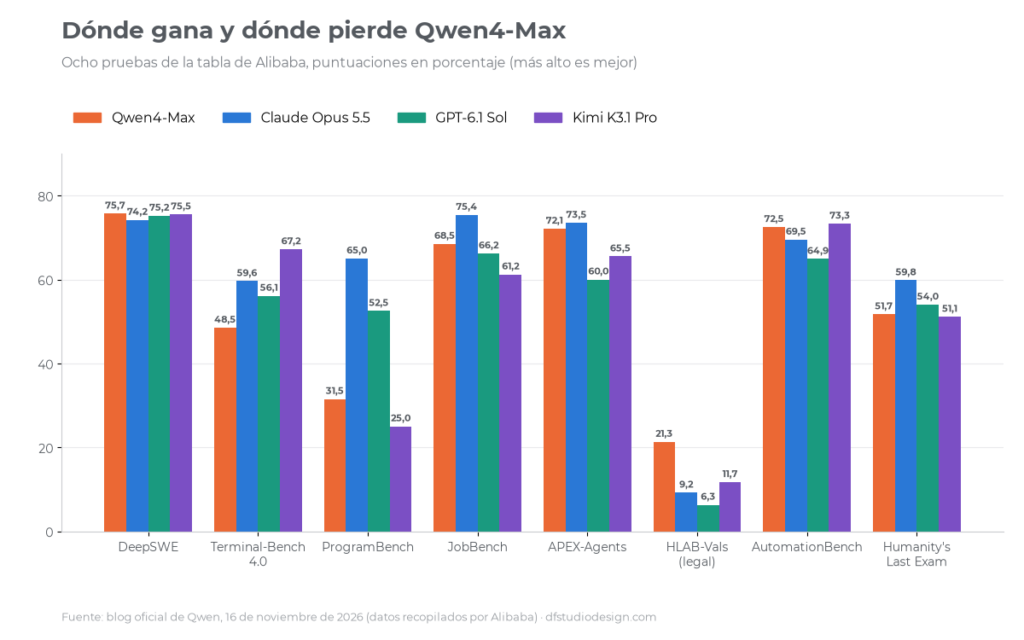
Aquí están las 16 pruebas, con el mejor resultado en negrita. CodeArena y AA-Briefcase son puntuaciones Elo, las de los rankings por enfrentamiento directo: más alto es mejor, pero no son porcentajes.
| Prueba | Qwen4-Max | Claude Opus 5.5 | GPT-6.1 Sol | GPT-6 Astra | Kimi K3.1 Pro |
|---|---|---|---|---|---|
| DeepSWE v1.1 programación como agente | 75,7 | 74,2 | 75,2 | 74,1 | 75,5 |
| CodeArena (Elo) desarrollo web | 1750 | 1816 | 1742 | 1763 | 1686 |
| Terminal-Bench 4.0 trabajo en terminal | 48,5 | 59,6 | 56,1 | 59,1 | 67,2 |
| ProgramBench reconstruir un software | 31,5 | 65,0 | 52,5 | 55,0 | 25,0 |
| AA-Briefcase (Elo) trabajo de oficina como agente | 1686 | 1801 | 1555 | 1569 | 1674 |
| Agents’ Last Exam tareas largas y de valor | 46,7 | 43,4 | n.d. | 42,6 | 43,4 |
| JobBench tareas de trabajo reales | 68,5 | 75,4 | 66,2 | 66,1 | 61,2 |
| APEX-Agents servicios profesionales | 72,1 | 73,5 | 60,0 | 64,7 | 65,5 |
| HLAB-Vals trabajo legal como agente | 21,3 | 9,2 | 6,3 | 7,1 | 11,7 |
| AutomationBench flujos en software de empresa | 72,5 | 69,5 | 64,9 | 68,5 | 73,3 |
| AgentArena tareas reales, mejora neta | 7,5 | 18,2 | 11,8 | 13,9 | 3,9 |
| BioMysteryBench investigación bioinformática | 85,0 | 81,9 | 84,4 | 78,9 | 80,6 |
| HealthBench Professional razonamiento clínico | 60,0 | 59,9 | 65,1 | 66,0 | 57,2 |
| Humanity’s Last Exam preguntas dificilísimas | 51,7 | 59,8 | 54,0 | 53,6 | 51,1 |
| Chartography leer gráficos | 54,2 | 66,3 | 67,8 | 71,1 | 50,0 |
| Video-Index entender vídeos | 68,1 | 74,8 | 73,8 | 76,7 | 63,2 |
En la tabla original, en Agents’ Last Exam aparece un solo modelo de OpenAI: por el color de la barra es GPT-6 Astra, así que para GPT-6.1 Sol he puesto «n.d.». Hechas las cuentas, Claude Opus 5.5 es el primero en 7 pruebas de 16, Qwen4-Max en 4, los modelos de OpenAI en 3 y Kimi K3.1 Pro en 2.
Dónde es fuerte de verdad
- Trabajo legal como agente (HLAB-Vals): 21,3 frente al 11,7 de Kimi y el 9,2 de Opus 5.5, casi el doble que el segundo. Ojo, eso sí, con los valores absolutos: incluso el mejor resuelve más o menos una tarea de cada cinco, así que ningún modelo está listo para hacer de abogado solo.
- Tareas largas (Agents’ Last Exam): 46,7, primero por delante de Opus 5.5 y Kimi (43,4). Frente a Qwen3.8-Max (27,9) es el mayor salto de toda la tabla.
- Investigación científica (BioMysteryBench): 85,0, primero por un margen pequeño.
- Programación como agente (DeepSWE): primero con 75,7, pero los seis modelos están entre 74 y 75,7. Es un empate, no una victoria.
Dónde se queda atrás
- Trabajo en terminal (Terminal-Bench 4.0): 48,5 frente al 67,2 de Kimi K3.1 Pro y el 59,6 de Opus 5.5. Es la prueba más parecida al día a día de quien programa con un agente, y aquí la distancia es grande.
- Reconstruir un software (ProgramBench): 31,5 frente al 65,0 de Opus 5.5, es decir, menos de la mitad.
- Visión: a pesar de la «visión nativa», en gráficos y vídeos está por detrás de todos los modelos occidentales de la tabla.
- Tareas reales evaluadas por personas (AgentArena): 7,5 de mejora neta frente al 18,2 de Opus 5.5.
Para situarlo, la comparación más útil es con Kimi K3.1 Pro: novedades, benchmarks y precios del modelo de pesos abiertos que desafía a Opus 5.5, el otro gran modelo chino que salió en octubre: Kimi es claramente más fuerte en terminal y Qwen4-Max en tareas profesionales y legales.
La nota de quien no lo vende
La comprobación que hago siempre es mirar un ranking independiente. Artificial Analysis ya ha medido Qwen4-Max con su Intelligence Index, que junta nueve pruebas de agentes, programación, conocimiento y ciencia. El resultado son 43 puntos: un salto claro frente a los 34 de Qwen3.8-Max, por encima del valor medio de los modelos de su franja de precio (41), pero lejos de los primeros.
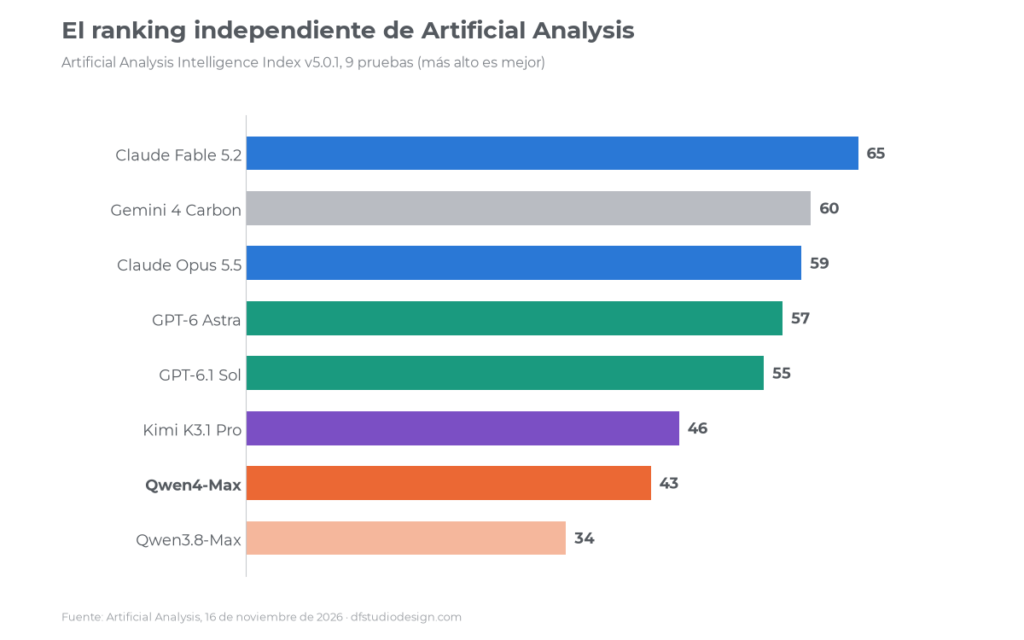
En este ranking Claude Fable 5.2 saca 65, Gemini 4 Carbon 60, Claude Opus 5.5 59, GPT-6 Astra 57, GPT-6.1 Sol 55 y Kimi K3.1 Pro 46. Qwen4-Max es, por tanto, un modelo de gama media alta, no uno que juegue de tú a tú con los mejores. El mensaje de algunos titulares («supera a Opus 5.5 en programación») solo se sostiene en DeepSWE, donde la diferencia es de punto y medio.
Precios de Qwen4-Max: la tarifa y el coste real por tarea
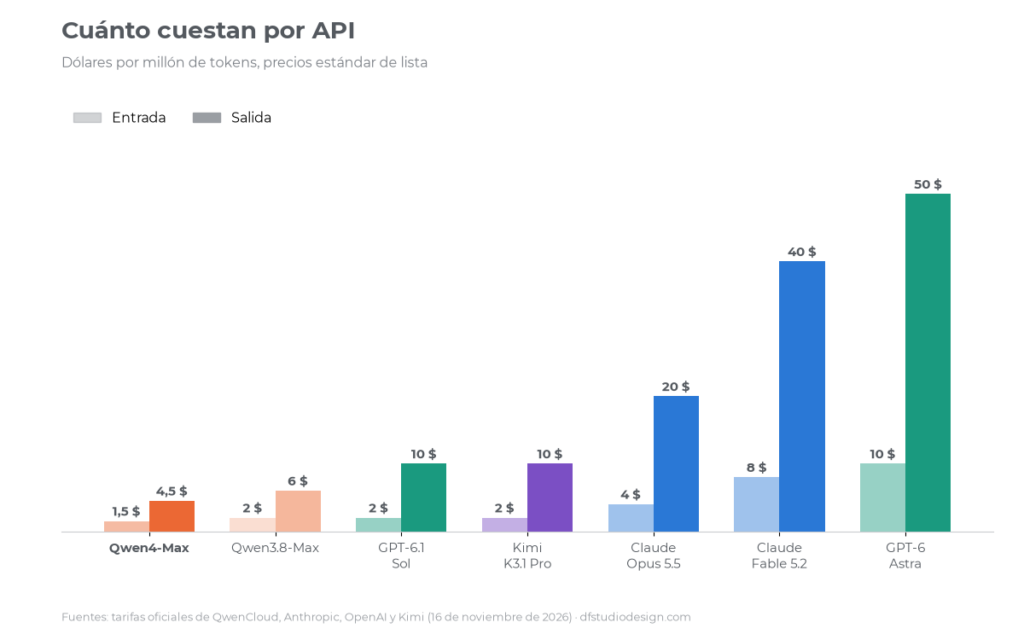
En la tarifa oficial de QwenCloud los precios son más bajos que los de Qwen3.8-Max en todas las partidas, y la caché (el descuento sobre las partes del texto que se repiten de una petición a otra) baja un 70%.
| Modelo | Entrada | Salida | Entrada en caché |
|---|---|---|---|
| Qwen4-Max | 1,5 $ | 4,5 $ | 0,075 $ |
| Qwen3.8-Max | 2 $ | 6 $ | 0,25 $ |
| GPT-6.1 Sol | 2 $ | 10 $ | 0,10 $ |
| Kimi K3.1 Pro | 2 $ | 10 $ | 0,20 $ |
| Claude Opus 5.5 | 4 $ | 20 $ | 0,20 $ |
| Claude Fable 5.2 | 8 $ | 40 $ | 0,20 $ |
| GPT-6 Astra | 10 $ | 50 $ | 1 $ |
Precios en dólares por millón de tokens, comprobados en las tarifas oficiales el 16 de noviembre de 2026. Qwen4-Max tiene también caché explícita, la que se activa a mano: crearla cuesta 1,875 dólares por millón de tokens si dura 5 minutos y 3 dólares si dura una hora, y leerla 0,075 dólares.
El precio por token no basta
Sobre el papel, Qwen4-Max es el más barato de la tabla. Pero lo que se paga de verdad es la tarea terminada, y ahí cuenta cuánto «habla» el modelo. Artificial Analysis también lo ha medido: para completar las pruebas de su índice, Qwen4-Max generó 127 millones de tokens, frente a un valor medio de 78,6 millones en los modelos comparables. Menos que los 150 millones de Qwen3.8-Max, así que el ahorro que anuncia Alibaba existe, pero sigue siendo un modelo que escribe mucho.
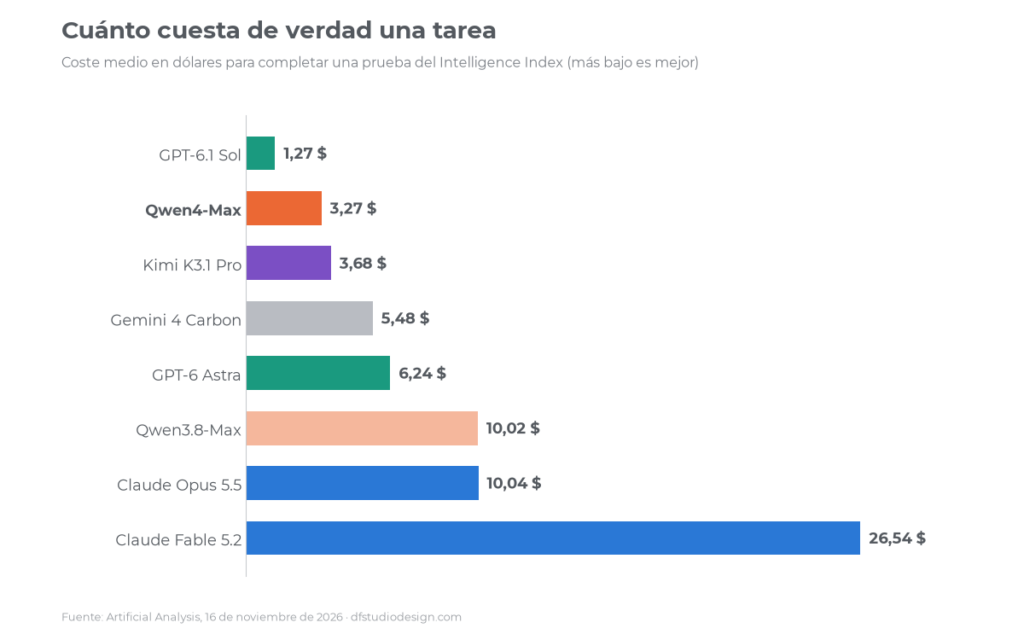
El resultado: 3,27 dólares por tarea, un tercio que Qwen3.8-Max (10,02) y que Claude Opus 5.5 (10,04), y algo menos que Kimi K3.1 Pro (3,68). Sin embargo, GPT-6.1 Sol hace el mismo trabajo por 1,27 dólares y saca 55 puntos en lugar de 43: cuesta menos de la mitad y es mejor. Llevado a la práctica, mil tareas como las de la prueba cuestan unos 1.270 dólares con GPT-6.1 Sol, 3.270 con Qwen4-Max y 10.040 con Opus 5.5.
El modelo adecuado, en resumen, no es el de la tarifa más baja, sino el que termina bien el trabajo con menos pasos. Y esa cuenta solo se puede hacer con las tareas propias, porque lo que «habla» un modelo cambia mucho de un tipo de trabajo a otro.
Dónde se usa y cómo probarlo
Qwen4-Max no se descarga. Se usa de cuatro maneras:
- Qwen Studio: el chat de Alibaba, desde el navegador o desde las apps. Es la forma más sencilla de probarlo sin escribir una línea de código.
- QwenWork y Qoder: el primero es la plataforma de Alibaba para el trabajo de oficina, que convierte una petición en documentos, presentaciones, páginas web, imágenes y vídeos; el segundo es un entorno de programación con agente, que también funciona dentro de VS Code y JetBrains. Alibaba dice que ha desarrollado el modelo junto a los equipos de estos productos, partiendo de cómo los usa la gente.
- API de QwenCloud: de pago por uso, con el nombre de modelo
qwen4-max. Es compatible con el formato de las API de OpenAI y de Anthropic, así que se conecta a los programas que ya las usan cambiando la dirección y la clave. Incluye herramientas como búsqueda web, lectura de páginas y ejecución de código. - Token Plan: una suscripción con créditos mensuales, con cuatro niveles para particulares (Lite, Essential, Standard y Pro) y puestos para equipos. Funciona dentro de Claude Code, Cursor, Codex, Qoder, Qwen Code y OpenClaw. Para los equipos, Alibaba garantiza que los datos no se usan para entrenar modelos.
Hay además una función nueva, Live Delivery: en lugar de desaparecer durante horas y volver con el trabajo terminado, el agente entrega pronto una primera versión que ya se puede usar y la va mejorando por etapas, mientras tú puedes corregir el rumbo en cualquier momento. Alibaba ha publicado el plugin Live Delivery en GitHub como código abierto.
Sobre los pesos: Qwen4-Max sigue cerrado. Alibaba ha dicho que los modelos más pequeños de la familia Qwen4 se publicarán como código abierto, pero sin fecha. Quien quiera un modelo Qwen para instalar en sus propios equipos, de momento tendrá que esperar.
A quién le puede servir de verdad
- A quien maneja mucho trabajo documental: contratos, due diligence, análisis financieros, historias clínicas. Es donde mejor rinde Qwen4-Max, y el anuncio trae un ejemplo concreto: 198 documentos desordenados que el modelo clasifica en 14 carpetas y convierte en un informe de 86 páginas, con cada conclusión enlazada al documento del que sale. La revisión de un profesional sigue siendo obligatoria, como dice la propia Alibaba.
- A quien ejecuta muchos agentes y mira los costes: con 3,27 dólares por tarea está en la franja económica, cerca de Kimi K3.1 Pro.
- No a quien programa sobre todo en terminal: ahí Kimi K3.1 Pro, Claude Opus 5.5 y Claude Fable 5.2 juegan en otra liga.
- No a quien quiere el modelo en casa: no hay pesos. Si los datos no pueden salir de la empresa, conviene esperar a los modelos Qwen4 pequeños o usar un modelo de pesos abiertos.
Para una empresa española hay además un aspecto práctico que no conviene olvidar: los datos pasan por los servidores de Alibaba Cloud. Antes de meter documentos de clientes, contratos o datos sanitarios, hay que comprobar con quien lleve la protección de datos en la empresa dónde se tratan y con qué garantías.
¿Merece la pena probarlo? Mi opinión
Llevo más de diez años en este oficio y, desde que sigo de cerca los modelos de IA, tengo una costumbre: no fiarme nunca de una sola tabla. Aquí la tabla de Alibaba y el ranking independiente cuentan dos historias algo distintas, y lo interesante está justo en esa diferencia.
El avance es real. Pasar de 34 a 43 puntos en Artificial Analysis y recortar dos tercios el coste por tarea en una sola generación es un resultado serio. El salto en Agents’ Last Exam, de 27,9 a 46,7, dice que el modelo aguanta trabajos largos mucho mejor que antes.
Pero el relato de que «supera a los modelos americanos» no se sostiene. Qwen4-Max gana donde las pruebas premian manejar muchos documentos y muchos pasos, y pierde con claridad donde hace falta precisión técnica: terminal, reconstrucción de software, lectura de gráficos. Y en los costes, que es su mejor argumento, GPT-6.1 Sol lo hace mejor tanto en calidad como en gasto por tarea.
Yo lo probaría en un caso concreto: análisis de documentos largos, donde el contexto de un millón de tokens y sus puntos fuertes en tareas legales y profesionales cuentan de verdad. Para programar no sería mi primera opción.
Conclusión
Con Qwen4-Max se ve todavía más claro un cambio que llevamos meses notando: la competición entre modelos ya no se juega en el precio por millón de tokens, sino en cuánto cuesta un trabajo terminado y bien hecho. Un modelo barato por token que escribe el doble, o que se equivoca y tiene que repetir, al final sale más caro.
Para quien usa la IA en un negocio, el consejo es el de siempre: antes de cambiar de modelo, coger veinte tareas reales del propio trabajo y medir tres cosas, es decir, la calidad del resultado, el tiempo y el gasto. Las tablas sirven para elegir qué probar, no para decidir. Y en los trabajos delicados, legales, financieros o médicos, la revisión humana sigue siendo parte del proceso, se use el modelo que se use.
Preguntas frecuentes
¿Qué es Qwen4-Max?
Es el modelo insignia de Alibaba, lanzado el 16 de noviembre de 2026. Es un modelo de expertos de 2,4 billones de parámetros, con 71.000 millones activos por token, contexto de 1 millón de tokens, y entiende texto, imágenes y vídeo. Está pensado sobre todo para trabajos largos como agente y para tareas profesionales.
¿Qwen4-Max es de código abierto?
No. Los pesos no se pueden descargar y el modelo solo se usa por API o en las apps de Alibaba. Alibaba ha anunciado que los modelos más pequeños de la familia Qwen4 serán de código abierto, sin dar una fecha.
¿Cuánto cuesta?
Por API cuesta 1,5 dólares por millón de tokens de entrada, 4,5 de salida y 0,075 por la entrada en caché. Según Artificial Analysis, el coste medio para completar una tarea de su índice es de 3,27 dólares. Como alternativa está el Token Plan, una suscripción con créditos mensuales.
¿Es mejor que Claude Opus 5.5?
En general, no. En la tabla de Alibaba Opus 5.5 gana 7 pruebas de 16 y Qwen4-Max 4, y en el ranking de Artificial Analysis Opus saca 59 puntos frente a 43. Qwen4-Max es más fuerte en tareas legales y en trabajos largos como agente, y cuesta más o menos un tercio por tarea.
¿Qué cambia frente a Qwen3.8-Max?
Nueva arquitectura, un 25% menos de parámetros activos, precios más bajos en todas las partidas y menos tokens para el mismo trabajo. En Artificial Analysis pasa de 34 a 43 puntos y el coste por tarea baja de 10,02 a 3,27 dólares.
¿Se puede usar con Claude Code o Cursor?
Sí. Las API de QwenCloud son compatibles con los formatos de OpenAI y Anthropic, y el Token Plan está pensado precisamente para herramientas como Claude Code, Cursor, Codex y Qoder.
¿Cómo se prueba sin programar?
Desde el chat Qwen Studio, en la web o en las apps, o desde QwenWork, la plataforma para documentos, presentaciones y otros trabajos de oficina.
Lee también:
Claude Opus 5.5, GPT-6 Sol y Luna: precios y benchmarks comparados ·
Gemini 4 Carbon: novedades, benchmarks y precios del modelo más potente de Google ·
MiniMax M3.1 Flash: novedades, precios y benchmarks del modelo chino para agentes de IA
Fuentes
- Qwen Team: Qwen4-Max, Your New Teammate Has Arrived (anuncio oficial, 16 de noviembre de 2026)
- QwenCloud: ficha y tarifa de Qwen4-Max y tarifa de Qwen3.8-Max
- Artificial Analysis: Qwen4 Max y Qwen3.8 Max: índice, coste por tarea y tokens usados
- QwenCloud: descripción del Token Plan
- EFE en Infobae: Alibaba presenta su nuevo modelo de IA, Qwen4-Max
- Tarifas oficiales de Anthropic, OpenAI y Kimi

GPT-6.2 Astra y Sol: qué cambia, cuánto cuestan y cómo
GPT-6.2 Astra y Sol: qué cambia, cuánto cuestan y cómo rinden de verdad en las pruebas Por Daniele Forciniti GPT-6.2 Astra y…

Qué es Browse de OpenCode y cómo instalarlo en tu
Qué es Browse de OpenCode y cómo instalarlo en tu PC Por Daniele Forciniti Browse de OpenCode es una herramienta gratuita y…
Plataformas gratuitas para aprender IA: las 10 academias oficiales de
Plataformas gratuitas para aprender IA: las 10 academias oficiales de OpenAI, Google, NVIDIA y las demás (guía 2026) Por Daniele Forciniti Las…
Businesses in ChatGPT: qué es el Business Hub y cómo
Businesses in ChatGPT: qué es el Business Hub y cómo reclamar tu empresa (guía 2026) Por Daniele Forciniti Businesses in ChatGPT es…
Claude Fable 5.2 y Mythos 5.2: benchmarks, precios y qué
Claude Fable 5.2 y Mythos 5.2: benchmarks, precios y qué cambia frente a Opus 5.5 Por Daniele Forciniti Claude Fable 5.2 y…
Gemini Notebook: qué es, cómo se usa y diferencias con
Gemini Notebook: qué es, cómo se usa y diferencias con NotebookLM y la app Gemini (guía 2026) Por Daniele Forciniti Gemini Notebook…