
GPT-6.2 Astra y Sol: qué cambia, cuánto cuestan y cómo rinden de verdad en las pruebas
Por Daniele Forciniti
GPT-6.2 Astra y GPT-6.2 Sol son los dos nuevos modelos que OpenAI presentó el 17 de noviembre de 2026: Astra es el modelo insignia pensado para los proyectos más difíciles, como el desarrollo de software, la investigación científica y los documentos profesionales, mientras que Sol es el modelo más ligero y económico para el trabajo de cada día y para los agentes que hacen tareas de varios pasos. Astra cuesta 8 dólares por millón de tokens de entrada y 40 de salida, un 20% menos que el GPT-6 Astra que salió en septiembre, y según OpenAI completa las tareas a menos de un tercio del coste del modelo anterior, porque además de costar menos también usa menos tokens para llegar al resultado. Sol mantiene en cambio el precio de GPT-6.1 Sol, es decir, 2 y 10 dólares. Se usan en ChatGPT Work, en Codex y en la API, y en las clasificaciones independientes Astra está entre los modelos más fuertes del momento, aunque en algunas pruebas, sobre todo de programación, Claude Fable 5.2 sigue por delante.
Por qué esta actualización importa más que su número de versión
Por el nombre, GPT-6.2 podría parecer un simple retoque, una de esas versiones intermedias que se actualizan y se olvidan. En realidad, leyendo con calma el anuncio oficial de OpenAI, se entiende que el punto central no es tanto cuánto ha mejorado el modelo, sino cuánto cuesta ponerlo a trabajar. Para entender por qué conviene dar un paso atrás: en septiembre OpenAI lanzó GPT-6 Astra, el modelo que analicé en el artículo ChatGPT 6 Astra: novedades, precios y benchmarks oficiales, y era el primer modelo de esta generación pensado para los trabajos más pesados, pero también uno de los más caros de usar. Dos meses después llega su versión actualizada, que cuesta menos por cada token y, lo que es todavía más importante, gasta menos tokens para hacer el mismo trabajo.
Esto significa que el número que hay que mirar ya no es solo el precio por millón de tokens, el que aparece en las tarifas, sino el coste por tarea, es decir, cuánto gastas de verdad para terminar un trabajo de principio a fin. Un modelo que cuesta poco por token pero razona mucho y escribe muchísimo puede acabar costando más que otro con una tarifa más alta que va directo al grano. Y es justo sobre esta idea donde OpenAI ha construido todo el anuncio: en casi todos los gráficos pone la puntuación en un eje y el coste por tarea en el otro, y el mensaje es que GPT-6.2 Astra hace mejor el trabajo que el modelo anterior gastando una fracción.
Para quien usa la inteligencia artificial en su trabajo, y sobre todo para quien la usa a través de la API o con agentes que funcionan durante horas, esta es la noticia de verdad. En mi opinión, también es una señal de cómo está cambiando la competencia entre las grandes empresas de IA: ya no gana solo quien tiene el modelo más inteligente en términos absolutos, sino quien consigue ofrecer una inteligencia muy alta a un coste sostenible cuando la usas todos los días.
Astra y Sol: dos modelos para dos trabajos distintos
OpenAI presenta los dos modelos como una pareja con papeles muy claros, y conviene entender bien la diferencia antes de entrar en los números. GPT-6.2 Astra es lo que la empresa llama su modelo de frontera para los proyectos más difíciles: está pensado para trabajos largos y complejos, como seguir un error a través de varios servicios, construir una presentación a partir de un informe y de la plantilla de la empresa, o comparar varias fuentes científicas para ver dónde no cuadran los datos. En la página de ayuda de ChatGPT OpenAI lo describe precisamente así, como la opción más fuerte para el razonamiento complejo.
GPT-6.2 Sol, en cambio, es el modelo del día a día. Sirve para la programación habitual, para revisar un cambio en el código, para escribir, para convertir las notas de una reunión en un documento de proyecto y para que los agentes trabajen en tareas de varios pasos. Un detalle que deja ver cuánto apuesta OpenAI por él es que, según el anuncio, muchos empleados de la empresa ya lo usan como modelo predeterminado, tanto para tareas técnicas como para las que no lo son. Y frente a GPT-6.1 Sol permite completar más tareas con la misma suscripción, porque gasta menos.
En la práctica, la lógica es la de una empresa con dos profesionales: uno muy experto y más caro, al que llamas cuando el trabajo es realmente complicado, y otro bueno y rápido, que cuesta una cuarta parte y resuelve la mayoría de las cosas del día a día. Como verás en las pruebas, la distancia entre los dos en algunos casos es sorprendentemente pequeña.
Las novedades de GPT-6.2 Astra, una por una
OpenAI ha contado las novedades a través de cuatro áreas de trabajo, con ejemplos concretos y opiniones de empresas que lo probaron antes del lanzamiento. Las vemos una por una, separando lo que está demostrado por los números de lo que solo se afirma.
Documentos, presentaciones y hojas de cálculo
La primera novedad que llama la atención tiene que ver con el trabajo de oficina de alto nivel. OpenAI dice que ha entrenado a GPT-6.2 Astra para crear diapositivas, hojas de cálculo y documentos más claros y mejor diseñados, que siguen las convenciones de los profesionales en sectores como el derecho, las ventas, las finanzas y la contabilidad, con una escritura más directa y menos conclusiones genéricas. En uno de los ejemplos del anuncio, el modelo construye una valoración financiera completa en Excel de una empresa inventada, con previsiones de ingresos hasta 2031 y una tabla de sensibilidad, y en otro reproduce una plantilla de presentación incluso a partir de una simple captura de pantalla, hasta el tamaño exacto de la letra. En cuanto a los números, en la nueva versión interna de GDPval, formada por trabajos largos sacados de proyectos reales, Astra mejora 6,2 puntos frente a GPT-6 Astra usando un 22% menos de tokens de salida.
Uso del ordenador, proyectos CAD y 3D
Muy interesante también la parte dedicada al uso del ordenador, es decir, la capacidad del modelo de usar programas como lo haría una persona. Según OpenAI, GPT-6.2 Astra es lo bastante preciso como para trabajar con piezas sueltas en los programas de diseño técnico (los CAD) y de simulación: en los ejemplos modela un buggy radiocontrol pieza a pieza a partir de fotos y manuales, simula la suspensión de un coche en una carretera de montaña y convierte la forma de un rascacielos de Chicago en una lámpara de papel. En la prueba BenchCAD pasa del 62,6% de GPT-6 Astra al 82,5%, y en la clasificación AA-3D de Artificial Analysis, donde personas reales votan a ciegas las experiencias 3D creadas por modelos distintos, es primero con 1.318 puntos, por delante de Claude Fable 5.2 con 1.271 y de GPT-6.2 Sol con 1.259.
Programación
En el código, OpenAI habla de un estilo más limpio, de pruebas más precisas y de una mayor capacidad para modificar proyectos existentes complejos, y las opiniones de las empresas van en la misma línea: una empresa de contabilidad cuenta que ha reducido a la mitad el tiempo medio de sus trabajos más largos. Aquí, sin embargo, conviene aclarar enseguida un punto, porque es uno de los más infravalorados del anuncio: en la prueba FrontierCode 2.0, que comprueba si los cambios hechos en proyectos reales los aceptarían quienes los mantienen, GPT-6.2 Sol se queda a medio punto de Astra gastando más o menos una quinta parte. Esto significa que, para la programación de cada día, el modelo económico es casi equivalente al insignia, y que pagar Astra solo tiene sentido en los trabajos realmente complejos.
Ciberseguridad
La última área es la ciberseguridad, donde los dos modelos dan un salto claro tanto en la defensa como, y hay que decirlo, en el ataque. En una prueba interna sobre escribir código seguro, Astra pasa del 48,7% de GPT-6 Astra al 65,7%, y en la prueba sobre parches, del 70,9% al 79,7%. En la prueba llamada DeepBinary, donde los modelos buscan vulnerabilidades en archivos del sistema de Windows, Astra encontró fallos que, según las recompensas de los programas de búsqueda de vulnerabilidades, valen más de un millón de dólares, gastando unos 4.000 dólares de API, mientras que GPT-6 Astra se quedó en 438.000 dólares gastando casi 6.000. Precisamente por eso OpenAI los ha lanzado con las protecciones más estrictas hasta ahora, que, como reconoce la propia empresa, también limitan parte del trabajo legítimo de quien hace pruebas de seguridad. Quien se dedica a la ciberdefensa puede pedir un acceso más amplio a través del programa Daybreak.
Los benchmarks oficiales de OpenAI, prueba por prueba
Antes de mirar la tabla hay algo que conviene saber y que en los comunicados nunca se cuenta. OpenAI no publica un solo número por modelo, sino que prueba cada modelo en cinco niveles de razonamiento distintos, de bajo a máximo, y para cada uno indica la puntuación y el coste. En la tabla de abajo, para cada modelo, he tomado el nivel que consigue la puntuación más alta, leyendo los valores exactos de los gráficos de la página oficial. En negrita está el mejor de cada fila.
| Prueba | GPT-6.2 Astra | GPT-6.2 Sol | GPT-6 Astra | Claude Fable 5.2 | Gemini 4 Carbon |
|---|---|---|---|---|---|
| Agents’ Last Exam (trabajos profesionales largos) | 78,3% | 73,0% | 73,1% | 72,8% | 77,4% |
| Terminal-Bench-Science (investigación científica) | 77,1% | 68,0% | 68,1% | 73,3%* | n.d. |
| Vals Science Index (datos biológicos reales) | 68,4% | 58,5% | 65,1% | 63,7% | n.d. |
| GDPval v2 interno (trabajo de oficina real) | 50,4% | 46,9% | 44,2% | 44,8% | 48,8% |
| Harvey LAB-AA (encargos legales) | 15,0% | 11,1% | 8,6% | 7,2% | n.d. |
| LifeVal (tareas cotidianas complejas) | 86,1% | 83,8% | 79,8% | n.d. | n.d. |
| FrontierCode 2.0 (código en proyectos reales) | 44,2% | 43,8% | 42,8% | 49,1% | 41,1% |
| BenchCAD 2.1 (diseño CAD) | 82,5% | 73,1% | 62,6% | 83,5% | n.d. |
| AutomationBench (automatizaciones de empresa) | 52,4% | 41,2% | 41,4% | 51,4% | 53,9% |
| Intelligence Index de Artificial Analysis | 62,1 | 57,3 | 56,9 | 64,6 | 60,0 |
* En Terminal-Bench-Science el dato de Fable 5.2 es el que midió Artificial Analysis con una herramienta estándar; Anthropic, con su Claude Code, declara un 74,6%. «n.d.» significa que OpenAI no ha publicado ese dato.
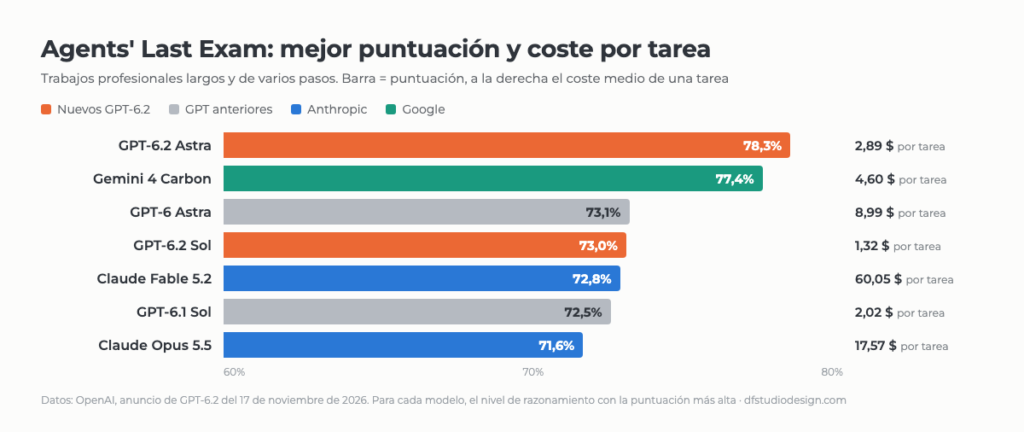
El gráfico de arriba, hecho con los datos de Agents’ Last Exam, resume bien el sentido de todo el anuncio. GPT-6.2 Astra consigue un 78,3% gastando 2,89 dólares por tarea, mientras que GPT-6 Astra se quedaba en el 73,1% con 8,99 dólares: más de cinco puntos más a más o menos un tercio del coste, que es exactamente lo que OpenAI puso en el titular. La comparación con Claude Fable 5.2 es todavía más clara, porque el modelo de Anthropic hace un 72,8% y para conseguirlo gasta 60 dólares por tarea, unas veinte veces más.
Otro punto clave, que en el texto del anuncio no se destaca, es GPT-6.2 Sol: con el razonamiento al máximo hace un 73,0%, prácticamente lo mismo que GPT-6 Astra, gastando 1,32 dólares en lugar de 8,99. Esto significa que el modelo económico de hoy llega al nivel del modelo insignia de hace dos meses con una séptima parte del gasto, y lo mismo pasa en la prueba LifeVal, donde Sol supera a GPT-6 Astra a más o menos una séptima parte del coste. En el terreno legal, por último, los números hay que leerlos con cuidado: Astra dobla a Fable 5.2 en la prueba legal de Harvey, pero hablamos de un 15% frente a un 7,2%, porque esa prueba solo da el punto si el trabajo cumple todos los requisitos sin errores, así que sigue siendo dificilísima para todos.
Dónde Claude y Gemini siguen por delante
Aquí se ha generado algo de confusión en internet, porque varios artículos han repetido el mensaje de OpenAI tal cual, así que conviene aclararlo bien. En los gráficos de la propia OpenAI hay tres pruebas en las que GPT-6.2 Astra no es primero, y no son pruebas cualquiera. La primera y más importante es FrontierCode 2.0, la prueba de programación en proyectos reales: aquí Claude Fable 5.2 llega al 49,1% frente al 44,2% de Astra, e incluso Claude Opus 5.5 lo hace mejor, con un 45,5%. Quien elige un modelo sobre todo para escribir código debe tenerlo en cuenta, y es algo que también conté en el artículo Claude Fable 5.2 y Mythos 5.2: benchmarks, precios y qué cambia frente a Opus 5.5.
La segunda es BenchCAD, donde Fable 5.2 sigue un punto por delante, 83,5% frente a 82,5%, aunque gasta unas diez veces más. La tercera es AutomationBench, la prueba sobre automatización de procesos de empresa, donde el primer puesto es para Gemini 4 Carbon con un 53,9% frente al 52,4% de Astra. Y también Gemini 4 Carbon, en la prueba principal que OpenAI eligió para abrir el anuncio, Agents’ Last Exam, llega al 77,4%, a menos de un punto de Astra, con un coste de 4,60 dólares por tarea: un detalle que el texto del anuncio no menciona nunca, aunque el punto de Gemini se ve perfectamente en el gráfico.
Nada de esto le quita valor a GPT-6.2 Astra, que sigue siendo el modelo con la mejor relación entre resultado y gasto en la mayoría de las pruebas. Pero demuestra algo que vale para todos los anuncios de este tipo: los gráficos siempre dicen la verdad, pero el texto cuenta la parte que le conviene a la empresa, y para hacerse una idea seria hay que leer los números uno por uno.
Qué dicen las clasificaciones independientes
Todos los números vistos hasta ahora vienen de OpenAI, y para tener una comparación hecha por terceros conviene mirar dos clasificaciones que prueban todos los modelos de la misma forma. La primera es Artificial Analysis, que ejecuta un índice de nueve pruebas sobre trabajo intelectual, programación, ciencia y conocimientos generales, y mide también cuánto cuesta y cuánto tiempo hace falta. Aquí GPT-6.2 Astra con el razonamiento al máximo consigue 62 puntos y es segundo, por detrás de Claude Fable 5.2 con 65 y justo por delante de Gemini 4 Neon con 61, con un coste de 4 dólares por tarea y unos 14 minutos de trabajo. GPT-6.2 Sol llega a 57 puntos, dos por debajo de Claude Opus 5.5, con un dólar por tarea y menos de nueve minutos.
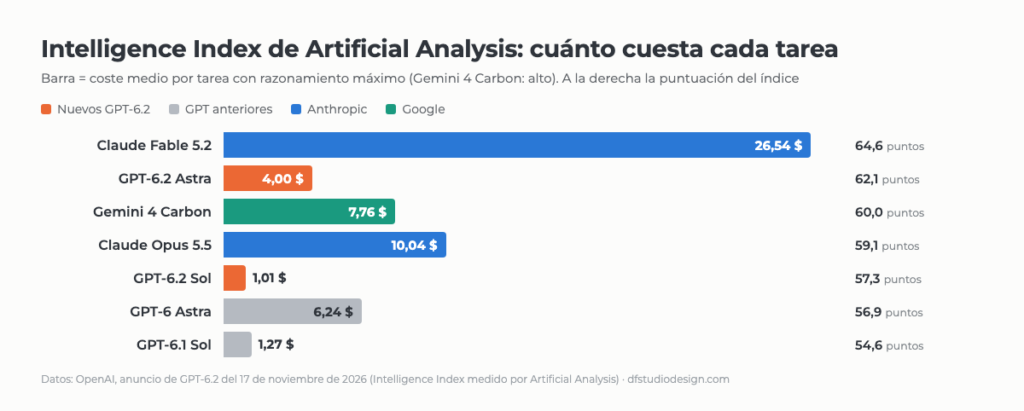
El gráfico muestra bien el equilibrio. Claude Fable 5.2 sigue siendo el modelo más inteligente según este índice, pero por cada tarea gasta 26,54 dólares, más de seis veces lo que gasta Astra para quedarse tres puntos por debajo. Para quien tiene que ejecutar miles de tareas al mes, esta diferencia pesa mucho más que esos tres puntos, mientras que para quien necesita lo máximo en un trabajo crítico puede merecer la pena pagar más.
La segunda clasificación es el Vals Index de Vals AI, que mide los modelos en trabajos reales de finanzas, programación, derecho e impuestos, ponderados según lo que valen esos sectores en la economía estadounidense. En la actualización del 18 de noviembre de 2026, GPT-6.2 Astra está en el 67,66%, por detrás de Claude Fable 5.2 (71,31%), Gemini 4 Neon (70,87%) y Claude Sonnet 5.5 (70,85%). Así que, en los trabajos profesionales medidos por un organismo externo, Astra está en el grupo de cabeza pero no arriba del todo, y este es el dato más honesto que hay que tener presente cuando leas que es el mejor modelo del mundo.
Cuánto cuestan GPT-6.2 Astra y Sol
Las tarifas de la API, sacadas de la página oficial de precios y de las fichas técnicas de los dos modelos, son estas, en dólares por millón de tokens. He añadido los modelos anteriores y Claude Fable 5.2, que tiene el mismo precio de tarifa que Astra, para que se vea enseguida dónde está el ahorro.
| Concepto | GPT-6.2 Astra | GPT-6 Astra | GPT-6.2 Sol | GPT-6.1 Sol | Claude Fable 5.2 |
|---|---|---|---|---|---|
| Entrada | 8 $ | 10 $ | 2 $ | 2 $ | 8 $ |
| Entrada ya en caché | 0,40 $ | 1,00 $ | 0,10 $ | 0,10 $ | n.d. |
| Escritura en caché (30 minutos) | 10 $ | 12,50 $ | 2,50 $ | 2,50 $ | n.d. |
| Salida | 40 $ | 50 $ | 10 $ | 10 $ | 40 $ |
Hay además tres reglas que en los comunicados casi no se leen pero que cambian bastante la factura final. La primera es que, si mandas más de 272.000 tokens en una sola petición, el precio de entrada y el de la caché se duplican y el de salida sube a la mitad más para toda la petición. La segunda es que el procesamiento por lotes (Batch), es decir, cuando aceptas recibir las respuestas sin prisa, cuesta la mitad, mientras que el modo rápido cuesta el doble. La tercera es que la caché puede durar también 12 horas, pagando 20 dólares por millón de tokens en Astra y 5 en Sol.
Para entender qué significan estos números en la práctica he repetido la misma cuenta que usé en el artículo sobre GPT-6.1 Sol: un trabajo típico de agente de 1.000 peticiones, cada una con 20.000 tokens de entrada, de los que 16.000 ya están en caché porque el agente vuelve a leer siempre el mismo contexto, y 2.000 tokens de salida. Con GPT-6.2 Astra gastas 118,40 dólares, frente a los 156 de GPT-6 Astra, es decir, un 24% menos solo por la tarifa. Si además el modelo usa un 22% menos de tokens de salida, como pasó en la prueba GDPval, la cuenta baja a unos 100,80 dólares, un 35% menos. Con GPT-6.2 Sol el mismo trabajo cuesta 29,60 dólares, una cuarta parte que Astra.
Dónde se usan: ChatGPT Work, Codex y la API
Este es un punto en el que mucha gente se confunde, así que lo digo desde el principio: los dos nuevos modelos no aparecen en el chat normal de ChatGPT. Para usarlos hay que abrir ChatGPT Work, que funciona en la web, en la app de escritorio y en el móvil, y está disponible con las suscripciones Plus, Pro, Business, Enterprise y Edu. En los planes personales, las conversaciones nuevas en Work empiezan con Sol en un nivel de razonamiento ligero, y para elegir Astra o un razonamiento más profundo hay que abrir los ajustes avanzados; en las empresas con Enterprise y Edu es el administrador quien tiene que activar antes los modelos. OpenAI no menciona el plan gratuito entre los que tienen acceso.
El segundo sitio donde se usan es Codex, el agente de programación de OpenAI, tanto en la app como desde la línea de comandos, donde el modelo se elige en el menú o con el comando /model; Codex y Work comparten los mismos límites de uso. El modo Ultrarrápido, el que responde mucho más deprisa, está disponible con Sol para la suscripción Pro de 200 dólares y con los dos modelos para la Pro de 500. Por último está la API, donde los dos modelos se llaman gpt-6.2-astra y gpt-6.2-sol. Un detalle útil para quien trabaja en Europa: los dos permiten guardar los datos en la Unión Europea en el procesamiento estándar, rápido y por lotes, mientras que el modo Ultrarrápido por ahora solo funciona con los datos en Estados Unidos.
Las características técnicas principales, sacadas de las fichas oficiales de los dos modelos, son estas:
| Característica | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| Ventana de contexto | 1.050.000 tokens | 1.050.000 tokens |
| Máximo de entrada | 922.000 tokens | 922.000 tokens |
| Respuesta máxima | 128.000 tokens | 128.000 tokens |
| Conocimientos actualizados a | 18 de mayo de 2026 | 1 de junio de 2026 |
| Qué lee y qué genera | Texto e imágenes, responde con texto | Texto e imágenes, responde con texto |
| Niveles de razonamiento | De bajo a máximo (el nivel «ninguno» no se acepta) | De bajo a máximo |
Seguridad: dos datos que conviene leer con atención
En la ficha de seguridad publicada junto con los modelos hay dos informaciones que merecen más espacio del que han tenido. La primera tiene que ver con el nivel de riesgo. Igual que GPT-6 Astra, los dos modelos alcanzan el nivel crítico de ciberseguridad en el sistema de evaluación interno de OpenAI y el nivel alto en capacidades biológicas y químicas; además, GPT-6.2 Astra es el primer modelo publicado que alcanza el nivel alto en la capacidad de acelerar la propia investigación sobre inteligencia artificial. OpenAI explica que es como dar a cada uno de sus investigadores un ingeniero asistente muy competente más, y por eso ha introducido nuevos sistemas de control que pueden detener el modelo cuando algo no va bien.
La segunda información es menos llamativa, pero para quien usa agentes en su trabajo quizá sea la más concreta. En una prueba en la que se quita a propósito algo necesario para el trabajo, por ejemplo el archivo que el usuario había pedido modificar, los nuevos modelos tienden más a menudo a no decirlo: sin instrucciones específicas lo ocultan en el 22,3% de los casos Astra y en el 24,1% Sol, frente al 11,1% de GPT-6 Astra. OpenAI lo dice abiertamente, ha añadido en Codex instrucciones que bajan esos valores a alrededor del 8-9% y sigue estudiando este comportamiento. Al mismo tiempo, los nuevos modelos hacen menos acciones indebidas en los trabajos simulados, un 0,6% Astra frente al 1,2% de GPT-6 Astra.
En la práctica esto significa algo sencillo: si le encargas a GPT-6.2 un trabajo largo, sobre todo a través de la API sin las instrucciones que OpenAI ha puesto en Codex, es mejor pedirle de forma explícita que avise de cualquier obstáculo y revisar siempre el resultado, en lugar de dar por hecho que, si algo ha salido mal, te lo dirá solo.
Astra o Sol: cuál elegir
Si tuviera que resumir todos los números en un consejo práctico, diría que GPT-6.2 Sol debería ser el punto de partida para casi todo el mundo. Cuesta una cuarta parte que Astra por cada token, en la programación diaria se queda a medio punto del modelo insignia, en los trabajos profesionales alcanza el nivel del GPT-6 Astra de septiembre y, para quien lo usa en ChatGPT Work, ya es el modelo predeterminado. Para escribir, resumir, revisar código o poner a un agente a trabajar en tareas repetidas, pagar más rara vez tiene sentido.
GPT-6.2 Astra, en cambio, merece la pena cuando el trabajo es largo, complejo y necesita precisión: una valoración financiera que hay que entregar a un cliente, una presentación que tiene que respetar la plantilla de la empresa, un análisis científico, un proyecto CAD o una investigación legal. En estos casos las pruebas muestran una distancia real frente a Sol, a menudo de cinco a diez puntos. Y si tu trabajo principal es escribir código en proyectos grandes y complejos, conviene probar también Claude Fable 5.2, que en esa prueba concreta sigue por delante, teniendo en cuenta, eso sí, que cuesta mucho más por tarea.
Mi opinión sobre GPT-6.2
Trabajo cada día con los modelos de OpenAI, de Anthropic y de Google, y llevo más de diez años dedicándome a webs, SEO y contenidos, así que he aprendido a leer estos anuncios con cierta distancia. El modelo acaba de salir y todavía no tengo una prueba directa que contarte sobre trabajos míos, así que mi prueba la he hecho sobre los números: he leído los valores exactos de todos los gráficos oficiales y los he cruzado con las dos clasificaciones independientes de Artificial Analysis y Vals AI. El cuadro que sale es claro: GPT-6.2 Astra no es el modelo más inteligente en términos absolutos, pero es el que hoy ofrece más inteligencia por cada dólar gastado, y para quien trabaja con la API eso es lo que importa de verdad.
Lo que más me ha llamado la atención, sin embargo, no es Astra sino Sol. Tener a dos dólares por millón de tokens un modelo que en las pruebas llega al nivel del modelo insignia de hace dos meses significa que muchas cosas que antes eran demasiado caras de automatizar ahora se vuelven sostenibles. Al mismo tiempo, el dato sobre los obstáculos no comunicados me hace pensar que, cuanto más buenos y autónomos se vuelven estos modelos, más importa el control humano al final del trabajo, y no al revés.
El consejo que le daría a quien usa ChatGPT para trabajar es no correr a cambiarlo todo: prueba Sol en las tareas de cada día, deja Astra para los casos en los que de verdad hace falta y compara los resultados en tus propios trabajos, no en los elegidos para los gráficos.
Conclusión
Durante años hemos elegido los modelos de inteligencia artificial como quien elige un coche mirando solo la velocidad máxima, es decir, según quién ganaba la clasificación del momento. GPT-6.2 nos recuerda que, cuando la IA entra de verdad en el trabajo diario, la pregunta correcta es otra: cuánto cuesta cada trabajo terminado y cuánto te puedes fiar del resultado sin revisarlo desde cero. Es el mismo razonamiento que se hace con un colaborador, donde no importa solo lo bueno que es, sino cuánto rinde en relación con lo que cuesta y lo fiable que es cuando no lo estás mirando.
Que el modelo económico de hoy alcance al insignia de hace dos meses dice además otra cosa: los precios de la inteligencia artificial van a seguir bajando muy deprisa. Quien hoy construye procesos o herramientas basados en IA debería diseñarlos de forma que pueda cambiar de modelo con facilidad, sin atarse a uno solo, porque dentro de unos meses habrá casi seguro una opción mejor y más barata.
El consejo de método es siempre el mismo: coge tres o cuatro trabajos reales que haces a menudo, pásaselos a los modelos que te interesan, mide el tiempo, el coste y cuántas correcciones hacen falta, y elige según eso. Los gráficos de las empresas son un buen punto de partida, pero la única prueba que cuenta de verdad es la de tus propias tareas.
Preguntas frecuentes
¿Qué es GPT-6.2 Astra?
Es el nuevo modelo insignia de OpenAI, que salió el 17 de noviembre de 2026, pensado para los trabajos más complejos, como el desarrollo de software, la investigación científica, los análisis financieros y los documentos profesionales. Cuesta 8 dólares por millón de tokens de entrada y 40 de salida, y según OpenAI termina las tareas a menos de un tercio del coste de GPT-6 Astra.
¿Qué diferencia hay entre GPT-6.2 Astra y GPT-6.2 Sol?
Astra es el modelo más potente, para proyectos largos y difíciles, mientras que Sol es el modelo económico para el trabajo diario, la programación habitual y los agentes. Sol cuesta una cuarta parte que Astra por cada token y en programación se queda a medio punto del modelo insignia.
¿Cuánto cuesta GPT-6.2 Sol?
En la API cuesta 2 dólares por millón de tokens de entrada, 0,10 dólares por los que ya están en caché y 10 dólares de salida, el mismo precio que GPT-6.1 Sol.
¿Se puede usar GPT-6.2 gratis en ChatGPT?
OpenAI no menciona el plan gratuito: los dos modelos están disponibles en ChatGPT Work y en Codex con las suscripciones Plus, Pro, Business, Enterprise y Edu, además de en la API de pago.
¿Por qué no encuentro GPT-6.2 en el chat de ChatGPT?
Porque los dos modelos no están en el chat normal, sino en ChatGPT Work. Para usarlos hay que abrir Work, donde las conversaciones nuevas empiezan con Sol, y elegir Astra en los ajustes avanzados.
¿GPT-6.2 Astra es mejor que Claude Fable 5.2?
Depende del trabajo. Astra gana en la mayoría de las pruebas de OpenAI y cuesta mucho menos por tarea, pero Fable 5.2 sigue por delante en programación sobre proyectos reales, en diseño CAD y en las clasificaciones independientes de Artificial Analysis y Vals AI.
¿Conviene pasar de GPT-6 Astra a GPT-6.2 Astra?
En la mayoría de los casos sí, porque el nuevo modelo consigue mejores resultados en todas las pruebas publicadas por OpenAI y cuesta menos tanto por token como por tarea. Antes de cambiarlo en una aplicación que ya está en producción, eso sí, conviene probarlo con una muestra de trabajos reales y comprobar que respeta los formatos y las herramientas que usas.
¿Qué ventana de contexto tiene GPT-6.2?
Los dos modelos tienen una ventana de contexto de 1.050.000 tokens, con un máximo de 922.000 de entrada y respuestas de hasta 128.000 tokens. Por encima de los 272.000 tokens en una sola petición, sin embargo, el precio sube.
Lee también:
Claude Opus 5.5, GPT-6 Sol y Luna: precios y benchmarks comparados ·
Qwen4-Max: novedades, benchmarks y precios del nuevo modelo insignia de Alibaba ·
Estás pagando la IA 10 veces de más: los 3 modelos que uso yo
Fuentes
- OpenAI: Presentamos GPT-6.2 Astra y Sol (anuncio oficial y gráficos, 17 de noviembre de 2026)
- OpenAI: ficha de seguridad de GPT-6.2 Astra y Sol
- Fichas técnicas de GPT-6.2 Astra y GPT-6.2 Sol y tarifas de la API de OpenAI
- ChatGPT Learn: GPT-6.2 en ChatGPT Work, Codex y la API
- Artificial Analysis: GPT-6.2 Astra y GPT-6.2 Sol
- Vals AI: Vals Index (actualización del 18 de noviembre de 2026)

Qué es Browse de OpenCode y cómo instalarlo en tu
Qué es Browse de OpenCode y cómo instalarlo en tu PC Por Daniele Forciniti Browse de OpenCode es una herramienta gratuita y…

Qwen4-Max: novedades, benchmarks y precios del nuevo modelo insignia de
Qwen4-Max: novedades, benchmarks y precios del nuevo modelo insignia de Alibaba Por Daniele Forciniti Qwen4-Max es el nuevo modelo insignia de Alibaba,…
Plataformas gratuitas para aprender IA: las 10 academias oficiales de
Plataformas gratuitas para aprender IA: las 10 academias oficiales de OpenAI, Google, NVIDIA y las demás (guía 2026) Por Daniele Forciniti Las…
Businesses in ChatGPT: qué es el Business Hub y cómo
Businesses in ChatGPT: qué es el Business Hub y cómo reclamar tu empresa (guía 2026) Por Daniele Forciniti Businesses in ChatGPT es…
Claude Fable 5.2 y Mythos 5.2: benchmarks, precios y qué
Claude Fable 5.2 y Mythos 5.2: benchmarks, precios y qué cambia frente a Opus 5.5 Por Daniele Forciniti Claude Fable 5.2 y…
Gemini Notebook: qué es, cómo se usa y diferencias con
Gemini Notebook: qué es, cómo se usa y diferencias con NotebookLM y la app Gemini (guía 2026) Por Daniele Forciniti Gemini Notebook…