
Claude Haiku 5.5 vs Gemini 4: prezzi, benchmark e chi conviene davvero
Di Daniele Forciniti
Claude Haiku 5.5 vs Gemini 4 è un confronto tra due modelli di fascia diversa. Haiku 5.5 è il modello piccolo di Anthropic, uscito il 7 ottobre 2026: costa 0,10 dollari per milione di token in entrata e 0,50 in uscita ed è fatto per i lavori veloci e ripetitivi. Gemini 4 Argon è il modello di punta di Google: nei test indipendenti è molto più intelligente (53 punti contro 38 a pari livello di ragionamento), ma costa circa 25 volte di più per attività e oggi lo usano solo i partner del programma Fairwind. Il vero rivale di Haiku 5.5, in casa Google, è Gemini 3.8 Flash, e fuori da Google è GPT-6 Luna di OpenAI.
In questo articolo trovi le due schede a confronto, i benchmark indipendenti (anche quelli dove Haiku perde), i prezzi veri con la soglia dei 100.000 token che quasi nessuno spiega, il confronto con Gemini 3.8 Flash e GPT-6 Luna e tre conti fatti su lavori reali. Alla fine c’è una guida pratica per capire quale modello usare, caso per caso.
Perché questo confronto è importante
Chi cerca “Haiku contro Gemini” di solito vuole sapere una cosa sola: quale costa meno a parità di lavoro fatto. La domanda è giusta, ma va fatta sui modelli giusti. Gemini 4 Argon e Haiku 5.5 sono usciti a una settimana di distanza e per questo finiscono spesso nello stesso titolo, però giocano due partite diverse: Argon è pensato per i progetti lunghi e difficili, Haiku per fare migliaia di piccoli lavori al minuto senza far esplodere la bolletta.
La notizia vera è un’altra. Con Haiku 5.5 Anthropic ha portato il suo modello piccolo allo stesso prezzo di GPT-6 Luna, e lo ha fatto tagliando del 90% il listino di Haiku 4.5 per le richieste fino a 100.000 token. Secondo Artificial Analysis, Haiku 5.5 al ragionamento massimo è oggi il modello più capace della sua fascia di prezzo, poco sopra Gemini 3.8 Flash e GPT-6 Luna. Per chi costruisce chatbot, automazioni o agenti AI, è la fascia dove si spende davvero, perché è quella che si chiama di più.
Le due schede a confronto
Prima di guardare i numeri, ecco le caratteristiche di base, prese dalle pagine ufficiali di Anthropic e Google.
| Caratteristica | Claude Haiku 5.5 | Gemini 4 Argon |
|---|---|---|
| Uscita | 7 ottobre 2026 | 30 settembre 2026 |
| Fascia | modello piccolo, il più veloce di Anthropic | modello di punta di Google DeepMind |
| Prezzo in entrata (per milione di token) | 0,10 $ fino a 100.000 token, 0,50 $ oltre | 2 $ al lancio, poi 4 $ |
| Prezzo in uscita (per milione di token) | 0,50 $ fino a 100.000 token, 2,50 $ oltre | 10 $ al lancio, poi 20 $ |
| Memoria di lavoro (contesto) | 1 milione di token | 1 milione di token |
| Risposta massima | 128.000 token | 1 milione di token |
| Cosa legge | testo e immagini | testo, immagini, documenti e video |
| Ragionamento regolabile | sì, da low a max (predefinito medium) | high, il livello più alto disponibile |
| Chi può usarlo oggi | tutti: app Claude (anche gratis), API, AWS, Google Cloud, Microsoft | solo programma Fairwind e team interni di Google |
L’ultima riga è quella che pesa di più. Haiku 5.5 lo puoi provare adesso su Claude.ai, anche con il piano gratuito, mentre Argon arriva per ora solo ai difensori informatici del programma Fairwind. Ho controllato oggi, 12 ottobre, il listino delle API Gemini: Argon ancora non c’è. Per chi lavora con Google, quindi, l’alternativa reale a Haiku 5.5 resta Gemini 3.8 Flash.
Cosa c’è di nuovo in Haiku 5.5
Haiku 4.5 era uscito un anno fa e nel frattempo il mercato dei modelli piccoli è cambiato molto. Ecco le novità, spiegate in modo semplice, dall’annuncio ufficiale e dalla documentazione per sviluppatori.
- Prezzo tagliato del 90% sotto i 100.000 token: da 1 e 5 dollari si passa a 0,10 e 0,50. Anthropic dice che il 90% delle richieste fatte a Haiku 4.5 stava sotto questa soglia. Oltre i 100.000 token il taglio è del 50% (0,50 e 2,50 dollari).
- Il risparmio medio è del 75%, non del 90%: il motivo è il nuovo tokenizer, cioè il sistema che divide il testo in pezzetti da pagare. Secondo la documentazione lo stesso testo conta circa il 30% di token in più rispetto a Haiku 4.5. Anthropic ha già fatto il conto e parla di un risparmio medio intorno al 75%.
- Livello di ragionamento regolabile: è il primo Haiku con il parametro effort. Puoi chiedergli di pensare poco (più veloce ed economico) o tanto (più preciso). Il valore predefinito è medium.
- Memoria da 1 milione di token: Haiku 4.5 si fermava a 200.000. Vuol dire che può leggere documenti molto lunghi, o lo stesso materiale che legge un modello più grande quando lavora come suo aiutante.
- Uso del computer e del browser: insieme al modello Anthropic ha aggiornato gli SDK per Python e TypeScript con il supporto in beta per l’uso del computer e del browser. Haiku 5.5 è pensato anche per compilare moduli, inserire dati e spostare informazioni tra un’app e l’altra.
- Il modello più veloce di Anthropic: lo è alla velocità standard; solo Opus in modalità Fast va più forte. Artificial Analysis misura 235 token al secondo al ragionamento massimo.
- Regole di sicurezza più strette: secondo l’annuncio le protezioni sulla sicurezza informatica sono più restrittive di Haiku 4.5 e bloccano, per esempio, i test di penetrazione. I dettagli sono nella scheda di sicurezza ufficiale.
C’è anche una novità che non riguarda Haiku ma chi lo paga: dalla settimana del lancio gli abbonati Max e Team ricevono un credito mensile per le API (100 dollari con Max 5x, 200 con Max 20x, fino a 500 condivisi per i team), utilizzabile su qualunque modello Claude.
Benchmark: Haiku 5.5 contro Gemini 4 Argon
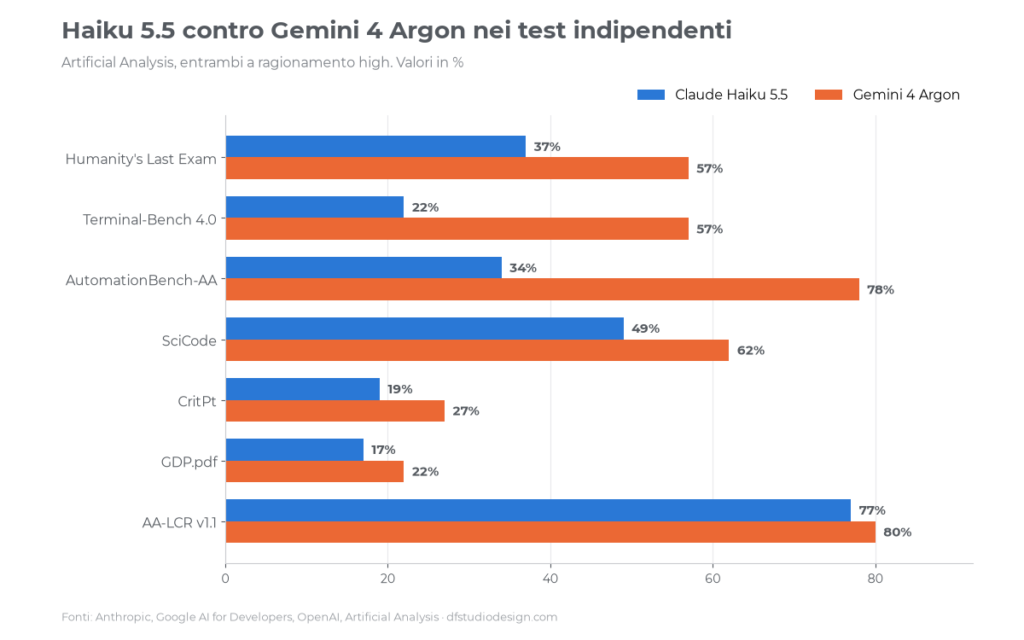
I numeri che seguono vengono da Artificial Analysis, un laboratorio indipendente che rifà gli stessi test su tutti i modelli. Per essere onesti nel confronto li ho presi con lo stesso livello di ragionamento, high, per tutti e due.
| Test | Cosa misura | Haiku 5.5 (high) | Gemini 4 Argon (high) |
|---|---|---|---|
| Intelligence Index v4.3.2 | media di 10 test | 38 | 53 |
| Humanity’s Last Exam | domande da esperti in tante materie | 37% | 57% |
| Terminal-Bench 4.0 | lavori di programmazione dal terminale | 22% | 57% |
| AutomationBench-AA | processi aziendali completi su software online | 34% | 78% |
| SciCode | codice per problemi scientifici | 49% | 62% |
| GDPval-AA v2.1 | lavori professionali reali (punteggio Elo) | 1418 | 1624 |
| AA-Briefcase v1.1 | lavoro d’ufficio da agente (punteggio Elo) | 1442 | 1488 |
| GDP.pdf | ragionamento su documenti professionali | 17% | 22% |
| AA-LCR v1.1 | ragionamento su testi molto lunghi | 77% | 80% |
| AA-Omniscience | conoscenza dei fatti, al netto delle risposte inventate | 6 | 42 |
| Costo per attività | media dell’indice | 0,08 $ | 1,99 $ |
| Costo dell’indice completo | tutti i 10 test | 94 $ | 2.407 $ |
Argon vince tutti i test, e non c’è da stupirsi: è un modello di un’altra categoria. La cosa interessante è dove il distacco è piccolo e dove è enorme.
Dove Haiku resta vicino
Sui testi molto lunghi (AA-LCR) Haiku perde di soli 3 punti, e sul lavoro d’ufficio da agente (AA-Briefcase) la distanza è di 46 punti Elo, poca cosa per due modelli che costano così diversamente. Anche sui documenti professionali (GDP.pdf) i due sono vicini, con punteggi bassi per entrambi. Tradotto: per leggere, riassumere e tirare fuori informazioni da documenti lunghi, Haiku fa un lavoro simile spendendo molto meno.
Lo conferma anche Vals AI su un test diverso: nel Vibe Code Bench, dove i modelli devono costruire da zero un’applicazione web completa partendo da una descrizione scritta, Haiku 5.5 è terzo su 110 con il 90,44%, dietro solo a Sonnet 5.5 (92,39%) e proprio a Gemini 4 Argon (91,91%).
Dove Argon stacca tutti
Sui processi aziendali completi (AutomationBench), sulla programmazione dal terminale e sulle domande da esperti la differenza è di 20-45 punti. Sono i lavori lunghi, con tanti passaggi, dove un errore all’inizio rovina tutto il resto: è esattamente il terreno per cui Argon è stato costruito.
Due precisazioni importanti. La prima: secondo Artificial Analysis il risultato di Haiku su AutomationBench è probabilmente sottostimato, perché durante i test prima del lancio un problema nei filtri di sicurezza gli faceva rifiutare troppe richieste; Anthropic lo sta correggendo e il test sarà rifatto. La seconda: su AA-Omniscience Haiku sa meno fatti a memoria, ma è più disposto ad ammettere quando non sa una cosa, e questo nei lavori veri conta.
I costi: qui Haiku non ha rivali
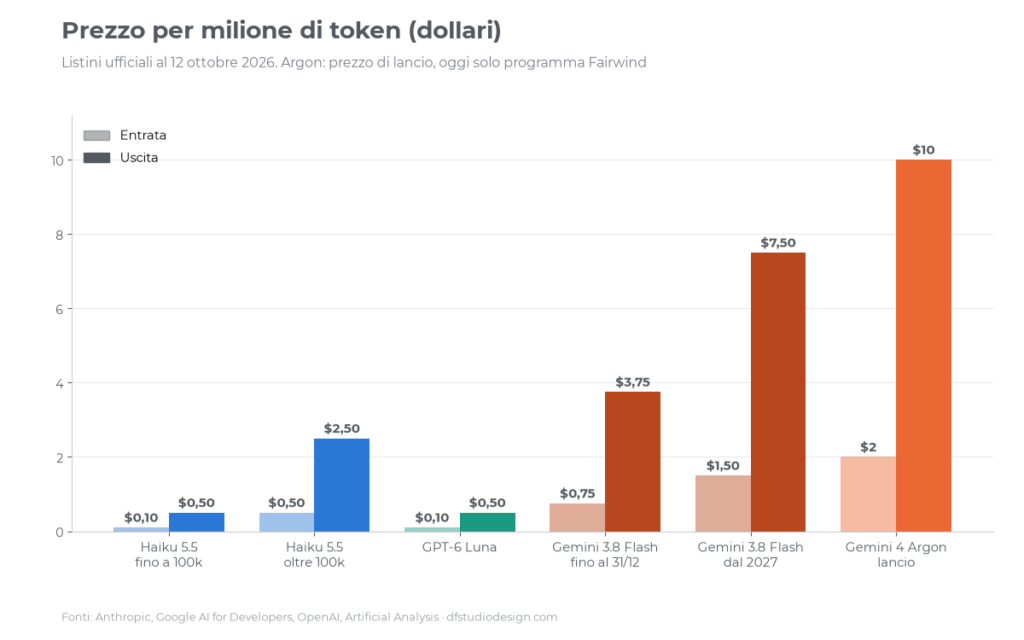
Se Argon vince sull’intelligenza, Haiku vince sul portafoglio, e con un margine molto più largo. A pari livello di ragionamento, un’attività media dell’indice costa 0,08 dollari con Haiku e 1,99 con Argon: circa 25 volte di più. Per far girare tutti i 10 test servono 94 dollari con Haiku e 2.407 con Argon.
| Modello | Entrata (per milione) | Uscita (per milione) | Note |
|---|---|---|---|
| Claude Haiku 5.5 | 0,10 $ | 0,50 $ | richieste fino a 100.000 token |
| Claude Haiku 5.5 | 0,50 $ | 2,50 $ | richieste oltre 100.000 token |
| GPT-6 Luna | 0,10 $ | 0,50 $ | prezzo base |
| Gemini 3.8 Flash | 0,75 $ | 3,75 $ | fino al 31 dicembre 2026 |
| Gemini 3.8 Flash | 1,50 $ | 7,50 $ | dal 1° gennaio 2027 |
| Gemini 4 Argon | 2 $ | 10 $ | prezzo di lancio, poi 4 e 20 $ |
Il prezzo di Haiku si abbassa ancora con due sconti ufficiali: fino al 90% sul testo già letto e messo in memoria (la cache, 0,01 dollari per milione di token) e il 50% con l’elaborazione in differita (Batch API), utile quando la risposta non serve subito. Sono riportati sulla pagina di Haiku.
Attenzione però a un dettaglio che Artificial Analysis segnala in modo esplicito: i suoi costi per attività di Haiku sono provvisori, perché il sito non applica ancora il prezzo più alto oltre i 100.000 token. Sulle richieste brevi i conti tornano, su quelle lunghe la spesa reale sarà un po’ più alta.
Il vero rivale: Gemini 3.8 Flash (e GPT-6 Luna)
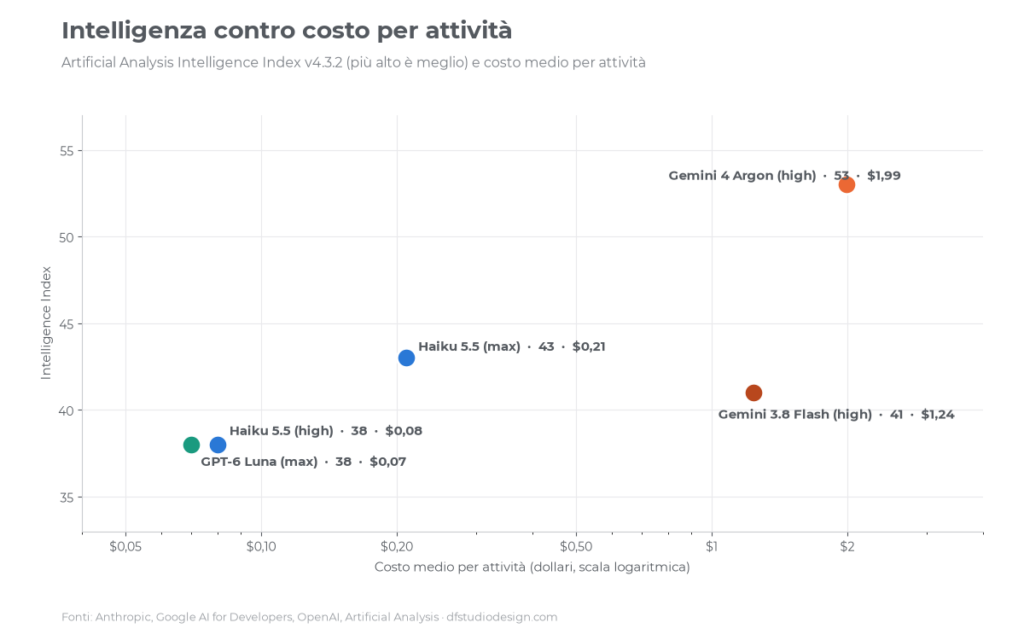
Se vuoi confrontare Haiku 5.5 con un modello della stessa fascia, i nomi giusti sono Gemini 3.8 Flash, il modello veloce di Google, e GPT-6 Luna, il modello piccolo di OpenAI che costa esattamente come Haiku. Qui il confronto è molto più combattuto. I dati sono di Artificial Analysis, con ogni modello al suo livello di ragionamento migliore (Haiku contro Flash, Haiku contro Luna).
| Test | Haiku 5.5 (max) | Gemini 3.8 Flash (high) | GPT-6 Luna (max) |
|---|---|---|---|
| Intelligence Index | 43 | 41 | 38 |
| AA-Briefcase v1.1 (Elo) | 1577 | 1203 | 1336 |
| GDPval-AA v2.1 (Elo) | 1618 | 1436 | 1432 |
| Terminal-Bench 4.0 | 33% | 20% | 13% |
| AutomationBench-AA | 35% | 60% | 53% |
| Humanity’s Last Exam | 44% | 48% | 39% |
| SciCode | 55% | 57% | 55% |
| AA-LCR v1.1 (testi lunghi) | 83% | 81% | 83% |
| AA-Omniscience | 11 | 30 | 1 |
| Prezzo entrata / uscita | 0,10 / 0,50 $ | 0,75 / 3,75 $ | 0,10 / 0,50 $ |
| Costo per attività | 0,21 $ | 1,24 $ | 0,07 $ |
| Token in uscita per attività | 162.000 | 71.000 | 50.000 |
| Velocità | 235 token/s | 132 token/s | 138 token/s |
Haiku 5.5 contro Gemini 3.8 Flash
Sull’intelligenza generale sono quasi pari (43 contro 41), ma vincono in cose diverse. Haiku è nettamente più forte nel lavoro d’ufficio da agente e nella programmazione dal terminale. Flash va meglio nei processi aziendali completi, nelle domande da esperti e soprattutto nella conoscenza dei fatti, dove ha quasi il triplo del punteggio.
Anche Vals AI li vede appaiati: nel suo indice sul lavoro professionale Haiku 5.5 fa 54,31% e Gemini 3.8 Flash 54,83%, mezzo punto di differenza. A fare la differenza sono il prezzo e quello che sanno leggere. Flash costa 7,5 volte di più per token e quasi 6 volte di più per attività, ma legge anche audio, video e PDF, mentre Haiku si ferma a testo e immagini. In compenso Haiku scrive risposte fino a 128.000 token, Flash fino a 65.536.
Un’ultima cosa su Flash: il prezzo attuale è una promozione. Dal 1° gennaio 2027 Google lo raddoppia, a 1,50 e 7,50 dollari. Se stai facendo un preventivo per un progetto che dura un anno, è un dettaglio da mettere nel conto.
Haiku 5.5 contro GPT-6 Luna
Qui il listino è identico al centesimo, anche sulla cache. Nella tabella ufficiale di Anthropic Haiku batte Luna in tutti i test che hanno in comune: 72,4% contro 48,9% sull’uso del computer (OSWorld 2.1), 39,2% contro 16,4% su Terminal-Bench 4.0, 46,4% contro 29,1% sulla lettura dei grafici. Sono però numeri dichiarati da Anthropic.
I test indipendenti confermano il vantaggio sull’intelligenza (43 contro 38), ma mostrano anche il rovescio: Haiku al massimo ragionamento usa circa 162.000 token in uscita per attività, più del triplo di Luna. Siccome i token di ragionamento si pagano come quelli della risposta, il costo per attività di Haiku (0,21 dollari) è tre volte quello di Luna (0,07). Allo stesso livello di intelligenza, cioè Haiku a high contro Luna a max, fanno entrambi 38 punti e costano quasi uguale: 0,08 contro 0,07 dollari.
Il prezzo per token, insomma, conta meno di quanti token un modello consuma per finire il lavoro. Vale anche per i modelli grandi come Claude Opus 5.5 e GPT-6 Sol, e con Haiku 5.5 si vede ancora di più.
Quanto costa davvero: tre conti su lavori veri
I benchmark dicono chi è più bravo, la fattura dice chi conviene. Ho rifatto i conti sui listini ufficiali per tre lavori tipici. Sono stime: ogni azienda divide il testo in token in modo diverso e i modelli che ragionano di più consumano più token in uscita, quindi i numeri vanno presi come ordine di grandezza.
1. Classificare 100.000 email o recensioni al mese
Ipotesi: ogni messaggio pesa circa 1.500 token in entrata (il testo più le istruzioni) e la risposta circa 300 token. In un mese fanno 150 milioni di token in entrata e 30 milioni in uscita.
| Modello | Costo mensile stimato |
|---|---|
| Claude Haiku 5.5 | 30 $ |
| GPT-6 Luna | 30 $ |
| Gemini 3.8 Flash | 225 $ (450 $ dal 2027) |
| Gemini 4 Argon | 600 $ al lancio (1.200 $ a prezzo pieno) |
È il lavoro perfetto per un modello piccolo: compiti brevi, tutti uguali, tanti. Usare Argon qui sarebbe come prendere un camion per portare una lettera.
2. Leggere un contratto da 300.000 token
Ipotesi: un documento molto lungo (centinaia di pagine) e una risposta di 5.000 token. Qui Haiku supera la soglia dei 100.000 token e paga la tariffa alta.
| Modello | Costo per documento |
|---|---|
| Claude Haiku 5.5 (tariffa oltre 100.000 token) | circa 0,16 $ |
| Gemini 3.8 Flash | circa 0,24 $ |
| Gemini 4 Argon | circa 0,65 $ al lancio |
Haiku resta il più economico, ma il vantaggio su Flash scende da 7,5 volte a circa 1,5. Se il lavoro lo permette c’è un trucco semplice: dividere il documento in tre parti da poco meno di 100.000 token. Così ogni richiesta resta sotto la soglia e la spesa con Haiku scende a circa 0,04 dollari, quattro volte meno. Non va bene quando il modello deve vedere tutto il documento insieme (per esempio per trovare contraddizioni tra un capitolo e l’altro).
3. Il livello di ragionamento cambia il conto
Lo stesso modello può costare il triplo a seconda di quanto lo fai pensare. Haiku 5.5 al massimo ragionamento fa 43 punti e costa 0,21 dollari per attività; a high fa 38 punti e costa 0,08. E i tempi cambiano ancora di più: al massimo, nei test di Artificial Analysis, il primo pezzo di risposta arriva dopo circa 5 minuti di ragionamento, a high dopo circa 25 secondi.
Secondo VentureBeat, che ha letto i grafici ufficiali, su Terminal-Bench Haiku arriva al 39% solo al massimo, mentre al livello predefinito (medium) si ferma intorno al 20%. Per una chat con i clienti serve una risposta in pochi secondi, quindi meglio low o medium. Per un lavoro notturno su migliaia di documenti, dove la precisione conta più del tempo, ha senso alzarlo.
Quale scegliere: la guida pratica
- Classificare, estrarre dati, riassumere in grandi quantità: Haiku 5.5 o GPT-6 Luna. Costano uguale; Haiku è più bravo sul lavoro d’ufficio, Luna consuma meno token.
- Aiutante di un modello più grande (subagente): Haiku 5.5. È il ruolo per cui Anthropic l’ha pensato: Opus 5.5 o Sonnet 5.5 pianificano, Haiku fa le ricerche e i pezzi di lavoro più semplici. Se costruisci agenti AI per un cliente, è il modo più semplice per tagliare la spesa.
- Automatizzare il browser o il computer (moduli, inserimento dati): Haiku 5.5, che nei test di Anthropic va molto meglio di Luna sull’uso del computer.
- Chat e assistenza clienti in tempo reale: Haiku 5.5 con ragionamento basso o medio. È il più veloce dei tre.
- Audio, video o PDF da analizzare direttamente: Gemini 3.8 Flash, che li legge tutti. Haiku legge solo testo e immagini.
- Domande sui fatti senza fare ricerche online: Gemini 3.8 Flash, che nei test sa molte più cose. Se però il modello lavora sui tuoi documenti, questa differenza pesa poco.
- Progetti lunghi e complessi, codice difficile, finanza e legale: Gemini 4 Argon quando arriverà per tutti. Oggi, tra i modelli che si possono usare, Claude Opus 5.5 o Sonnet 5.5. Su Argon trovi tutti i dettagli nel mio articolo su novità, costi e benchmark di Gemini 4 Argon.
- Provare gratis prima di pagare: Haiku 5.5 è nel piano gratuito di Claude; Gemini 3.8 Flash ha un piano gratuito nelle API e si prova anche in Google AI Studio.
Cose da controllare prima di cambiare modello
Se oggi usi Haiku 4.5 o un altro modello piccolo e pensi di passare a Haiku 5.5, questi sono i controlli che farei prima di toccare un sistema che funziona.
- Quanto sono lunghe le tue richieste: se superano spesso i 100.000 token, rifai i conti con la tariffa alta (0,50 e 2,50 dollari).
- Il nuovo tokenizer: lo stesso testo conta circa il 30% di token in più. Se hai dei limiti di spesa o di lunghezza, vanno ritarati.
- Alcuni parametri non si usano più: la documentazione chiede di non inviare temperature, top_p e top_k, che con valori diversi da quelli predefiniti danno errore. Il ragionamento si regola con effort. La lista completa è nella guida ufficiale di Haiku 5.5.
- Il livello di ragionamento predefinito è medium: se non lo imposti tu, paghi e aspetti come a medium. Provalo su low per i compiti più semplici.
- I rifiuti: i filtri di sicurezza sono più severi di Haiku 4.5 e all’inizio rifiutavano troppe richieste. Prova i tuoi casi reali prima di metterlo in produzione.
- Se scegli Gemini 3.8 Flash: ricordati che dal 1° gennaio 2027 il prezzo raddoppia.
Cosa ne penso
Lavoro con siti web, SEO e contenuti da oltre dieci anni, e negli ultimi due anni gran parte dei progetti che mi chiedono ha dentro un pezzo di AI: un assistente che risponde ai clienti sul sito, un sistema che smista le richieste del modulo contatti, schede prodotto da riscrivere a centinaia. In questi lavori il modello più intelligente quasi mai è la scelta giusta. Serve un modello affidabile, veloce e abbastanza economico da poterlo chiamare tutto il giorno senza pensarci.
Per questo trovo Haiku 5.5 più interessante di quanto dicano i titoli. Non batte Argon e non deve farlo. Arriva allo stesso prezzo di Luna con più capacità nel lavoro d’ufficio, e tiene testa a Gemini 3.8 Flash costando molto meno. Il punto debole va detto chiaramente: se lo lasci ragionare al massimo consuma tantissimi token e diventa lento, quindi va regolato, non usato con le impostazioni di serie.
Su Gemini 4 Argon il mio giudizio resta quello di dieci giorni fa: i numeri sono i migliori in circolazione, ma finché non arriva nelle API resta una promessa. Nel frattempo, una cosa vale per tutti questi modelli: le AI rispondono usando quello che trovano online. Se vuoi che citino la tua azienda quando qualcuno chiede un consiglio, conta come è scritto il tuo sito, ed è il lavoro che faccio con la consulenza SEO e GEO.
Conclusione
Haiku 5.5 e Gemini 4 Argon non si fanno concorrenza: Argon è più intelligente in tutti i test indipendenti, Haiku costa circa 25 volte meno per attività e lo può usare chiunque, oggi. Il confronto che conta davvero è con Gemini 3.8 Flash, con cui è quasi pari sull’intelligenza ma molto più economico, e con GPT-6 Luna, che ha lo stesso listino, è un po’ meno capace e consuma meno token.
Il consiglio pratico è sempre lo stesso: scegli il modello in base al lavoro, non alla classifica. Per i compiti brevi e ripetuti un modello piccolo regolato bene costa una frazione e fa quasi lo stesso lavoro. Per i progetti lunghi e difficili serve un modello grande. E prima di decidere, prova i tuoi casi reali e guarda la fattura, non solo il listino.
FAQ
Qual è la differenza tra Claude Haiku 5.5 e Gemini 4 Argon?
Haiku 5.5 è il modello piccolo ed economico di Anthropic, fatto per i lavori veloci e ripetitivi. Gemini 4 Argon è il modello di punta di Google, fatto per i progetti lunghi e complessi. Argon è più intelligente in tutti i test indipendenti, Haiku costa circa 25 volte meno per attività.
Quanto costa Claude Haiku 5.5?
Nelle API costa 0,10 dollari per milione di token in entrata e 0,50 in uscita per le richieste fino a 100.000 token. Oltre questa soglia costa 0,50 e 2,50 dollari. Con la cache si risparmia fino al 90% sul testo già letto e con la Batch API il 50%. Nell’app Claude si può usare anche con il piano gratuito.
Posso già usare Gemini 4 Argon?
No, a meno che la tua organizzazione non faccia parte del programma Fairwind di Google. Dopo arriverà ai clienti a pagamento delle API Gemini e agli abbonati Google AI Ultra, ma Google non ha dato date. Al 12 ottobre 2026 non compare nel listino delle API.
Haiku 5.5 è meglio di Gemini 3.8 Flash?
Sull’intelligenza generale sono quasi pari: 43 punti contro 41 nell’indice di Artificial Analysis. Haiku è più forte nel lavoro d’ufficio da agente e nella programmazione dal terminale, Flash nelle domande sui fatti e nei processi aziendali completi. Haiku costa 7,5 volte meno per token, Flash legge anche audio, video e PDF.
Haiku 5.5 o GPT-6 Luna?
Hanno lo stesso prezzo. Haiku è più capace nei test (43 contro 38 al massimo ragionamento) ma consuma più token, quindi al massimo costa circa tre volte di più per attività. Allo stesso livello di intelligenza costano quasi uguale. Per l’uso del computer e il lavoro d’ufficio Haiku è avanti, per spendere il minimo possibile Luna è un’ottima scelta.
Perché Haiku 5.5 costa il 75% in meno e non il 90%?
Il listino scende del 90% sotto i 100.000 token, ma il nuovo tokenizer conta lo stesso testo con circa il 30% di token in più, e sopra la soglia il taglio è solo del 50%. Facendo la media sulle richieste reali, Anthropic stima un risparmio intorno al 75% rispetto a Haiku 4.5.
Quale livello di ragionamento conviene usare con Haiku 5.5?
Dipende dal lavoro. Per chat e assistenza in tempo reale conviene low o medium, che rispondono in pochi secondi. Per lavori in differita dove conta la precisione si può salire a high o max, sapendo che al massimo il modello consuma circa il triplo dei token e può impiegare minuti prima di rispondere.
Leggi anche:
GPT-6 Astra e Gemini 3.8 Flash: benchmark ufficiali, prezzi veri e quale conviene ·
Gemini 4 Pro in prova su Arena sotto il nome Gemini 3.8 Flash: cosa sappiamo davvero ·
Claude Fable 5.1 e Mythos 5.1: benchmark, prezzi e taglio del 75%
Fonti
- Anthropic, Introducing Claude Haiku 5.5, 7 ottobre 2026: prezzi, benchmark ufficiali e confronto con GPT-6 Luna.
- Claude Platform Docs, Claude Haiku 5.5: scheda tecnica, tariffe oltre i 100.000 token, tokenizer e parametri.
- Artificial Analysis, analisi di Claude Haiku 5.5: test indipendenti, consumo di token e note sui costi provvisori.
- Artificial Analysis, Haiku 5.5 contro Gemini 4 Argon: il confronto a pari livello di ragionamento.
- Google AI for Developers, prezzi delle API Gemini: listino di Gemini 3.8 Flash e aumento dal 2027.
- Google, Gemini 4 Argon: novità e disponibilità del modello di punta.
- Vals AI, Claude Haiku 5.5: Vals Index e Vibe Code Bench.
- Punto Informatico, 8 ottobre 2026: la presentazione di Haiku 5.5 in italiano.

7 risorse gratuite per sviluppatori: API di AI, database, email
7 risorse gratuite per sviluppatori: API di AI, database, email e monitoraggio Di Daniele Forciniti Queste sono 7 risorse gratuite per sviluppatori…

Gemini 4 Argon: tutte le novità, costi e benchmark
Gemini 4 Argon: tutte le novità, costi e benchmark Di Daniele Forciniti Gemini 4 Argon è il nuovo modello di punta di…
GPT-6.1 Sol: novità, benchmark e costi
GPT-6.1 Sol: novità, benchmark e costi Di Daniele Forciniti GPT-6.1 Sol è il nuovo modello di OpenAI presentato ieri, 29 settembre 2026,…
Gemini 4 Pro in prova su Arena sotto il nome
Gemini 4 Pro in prova su Arena sotto il nome Gemini 3.8 Flash: cosa sappiamo davvero Di Daniele Forciniti Secondo diversi sviluppatori,…
Ricerca multimodale: ora Search Console mostra chi ti trova con
Ricerca multimodale: ora Search Console mostra chi ti trova con una foto Di Daniele Forciniti Dal 24 settembre 2026 Google Search Console…
SEO, AEO, GEO, AIO e SXO: le 5 sigle della
SEO, AEO, GEO, AIO e SXO: le 5 sigle della SEO moderna spiegate in modo semplice Di Daniele Forciniti SEO, AEO, GEO,…