
GPT-6.2 Astra e Sol: cosa cambia, quanto costano e come vanno davvero nei test
Di Daniele Forciniti
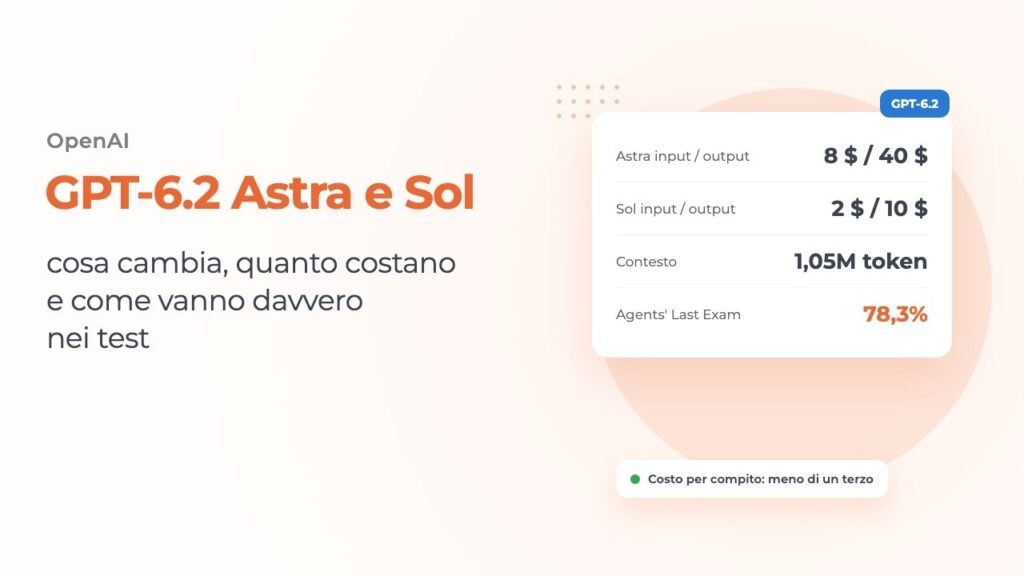
GPT-6.2 Astra e GPT-6.2 Sol sono i due nuovi modelli che OpenAI ha presentato il 17 novembre 2026: Astra è il modello di punta pensato per i progetti più difficili, come lo sviluppo software, la ricerca scientifica e i documenti professionali, mentre Sol è il modello più leggero ed economico per il lavoro di tutti i giorni e per gli agenti che svolgono compiti in più passaggi. Astra costa 8 dollari per milione di token in entrata e 40 in uscita, il 20% in meno del GPT-6 Astra uscito a settembre, e secondo OpenAI porta a termine i compiti a meno di un terzo del costo del modello precedente, perché oltre a costare meno usa anche meno token per arrivare al risultato. Sol mantiene invece il prezzo di GPT-6.1 Sol, cioè 2 e 10 dollari. Si usano in ChatGPT Work, in Codex e nelle API, e nelle classifiche indipendenti Astra è tra i modelli più forti in circolazione, anche se in alcuni test, soprattutto sulla programmazione, Claude Fable 5.2 resta davanti.
Perché questo aggiornamento conta più del numero di versione
A guardare il nome, GPT-6.2 sembrerebbe un ritocco, una di quelle versioni intermedie che si aggiornano e si dimenticano. In realtà, leggendo con calma l’annuncio ufficiale di OpenAI, si capisce che il punto centrale non è tanto quanto il modello sia diventato più bravo, ma quanto costi farlo lavorare. Per capire perché conviene fare un passo indietro: a settembre OpenAI aveva lanciato GPT-6 Astra, il modello che avevo analizzato nell’articolo ChatGPT 6 Astra: novità, costi e benchmark ufficiali, ed era il primo modello di questa generazione pensato per i lavori più pesanti, ma anche uno dei più cari da usare. Due mesi dopo arriva la sua versione aggiornata, che costa meno a parità di token e, cosa ancora più importante, consuma meno token per fare lo stesso lavoro.
Questo significa che il numero da guardare non è più soltanto il prezzo per milione di token, quello che trovi nei listini, ma il costo per compito, cioè quanto spendi davvero per portare a termine un lavoro dall’inizio alla fine. Un modello che costa poco per token ma ragiona a lungo e scrive tantissimo può finire per costare di più di uno con un listino più alto ma che va dritto al punto. Ed è proprio su questo che OpenAI ha costruito tutto l’annuncio: in quasi ogni grafico mette il punteggio su un asse e il costo per compito sull’altro, e il messaggio è che GPT-6.2 Astra fa meglio del modello precedente spendendo una frazione.
Per chi usa l’intelligenza artificiale nel lavoro, e soprattutto per chi la usa tramite le API o con agenti che girano per ore, questa è la notizia vera. Secondo me è anche il segnale di come si stia spostando la competizione tra le grandi aziende dell’AI: non vince più solo chi ha il modello più intelligente in assoluto, ma chi riesce a offrire un’intelligenza molto alta a un costo sostenibile quando la usi tutti i giorni.
Astra e Sol: due modelli per due lavori diversi
OpenAI presenta i due modelli come una coppia con ruoli ben distinti, e conviene capire bene la differenza prima di entrare nei numeri. GPT-6.2 Astra è quello che l’azienda chiama il suo modello di frontiera per i progetti più difficili: è pensato per i lavori lunghi e complessi, come seguire un bug attraverso più servizi, costruire una presentazione partendo da un report e dal modello di slide dell’azienda, oppure confrontare più fonti scientifiche e capire dove le prove non tornano. Nella pagina di aiuto di ChatGPT OpenAI lo descrive proprio così, come la scelta più forte per il ragionamento complesso.
GPT-6.2 Sol, invece, è il modello di tutti i giorni. Serve per la programmazione quotidiana, per rivedere una modifica al codice, per scrivere, per trasformare gli appunti di una riunione in un documento di progetto e per far lavorare gli agenti su compiti che richiedono più passaggi. Un dettaglio che fa capire quanto OpenAI ci punti è che, secondo l’annuncio, molti dipendenti dell’azienda lo usano già come modello predefinito, sia per le attività tecniche sia per quelle che non lo sono. E rispetto a GPT-6.1 Sol permette di completare più attività con lo stesso abbonamento, perché consuma meno.
In pratica la logica è quella di un’azienda con due professionisti: uno molto esperto e più caro, da chiamare quando il lavoro è davvero complicato, e uno bravo e veloce, che costa un quarto e risolve la maggior parte delle cose di ogni giorno. Come vedrai nei test, la distanza tra i due in certi casi è sorprendentemente piccola.
Le novità di GPT-6.2 Astra, una per una
OpenAI ha raccontato le novità attraverso quattro aree di lavoro, con esempi concreti e testimonianze di aziende che lo hanno provato in anteprima. Le vediamo una alla volta, separando quello che è dimostrato dai numeri da quello che è solo dichiarato.
Documenti, presentazioni e fogli di calcolo
La prima novità che colpisce riguarda i lavori d’ufficio di alto livello. OpenAI dice di aver addestrato GPT-6.2 Astra a creare slide, fogli di calcolo e documenti più chiari e meglio progettati, che seguono le convenzioni usate dai professionisti in settori come il diritto, le vendite, la finanza e la contabilità, con una scrittura più diretta e meno conclusioni generiche. In un esempio dell’annuncio, il modello costruisce una valutazione finanziaria completa in Excel di un’azienda inventata, con previsioni dei ricavi fino al 2031 e una tabella di sensibilità, e in un altro riproduce un modello di presentazione partendo anche da un semplice screenshot, fino alla dimensione esatta dei caratteri. Sul piano dei numeri, nel test GDPval nella sua nuova versione interna, fatto di lavori lunghi presi da progetti reali, Astra migliora di 6,2 punti rispetto a GPT-6 Astra usando il 22% di token in uscita in meno.
Uso del computer, progetti CAD e 3D
Molto interessante anche la parte dedicata all’uso del computer, cioè la capacità del modello di usare i programmi come farebbe una persona. Secondo OpenAI, GPT-6.2 Astra è abbastanza preciso da lavorare sui singoli componenti nei programmi di progettazione tecnica (i CAD) e di simulazione: negli esempi modella un buggy radiocomandato pezzo per pezzo partendo da foto e manuali, simula le sospensioni di un’auto su una strada di montagna e trasforma la forma di un grattacielo di Chicago in una lampada di carta. Nel test BenchCAD passa dal 62,6% di GPT-6 Astra all’82,5%, e nella classifica AA-3D di Artificial Analysis, dove persone reali votano alla cieca le esperienze 3D create da modelli diversi, è primo con 1.318 punti, davanti a Claude Fable 5.2 con 1.271 e a GPT-6.2 Sol con 1.259.
Programmazione
Sul codice OpenAI parla di uno stile più pulito, di test più mirati e di una maggiore capacità di modificare progetti esistenti complessi, e le testimonianze delle aziende vanno nella stessa direzione: una società di contabilità racconta di aver dimezzato il tempo medio dei suoi lavori più lunghi. Qui però conviene chiarire subito un punto, perché è uno dei più sottovalutati dell’annuncio: nel test FrontierCode 2.0, che verifica se le modifiche fatte su progetti veri verrebbero accettate da chi li mantiene, GPT-6.2 Sol arriva a mezzo punto da Astra spendendo circa un quinto. Questo significa che per la programmazione di tutti i giorni il modello economico è quasi equivalente a quello di punta, e che pagare Astra ha senso solo per i lavori davvero complessi.
Sicurezza informatica
L’ultima area è la sicurezza informatica, dove i due modelli fanno un salto netto sia nella difesa sia, e questo va detto, nell’attacco. In un test interno sulla scrittura di codice sicuro Astra passa dal 48,7% di GPT-6 Astra al 65,7%, e nel test sulle patch dal 70,9% al 79,7%. Nella prova chiamata DeepBinary, dove i modelli cercano vulnerabilità nei file di sistema di Windows, Astra ha trovato falle che, secondo le ricompense previste dai programmi di segnalazione delle vulnerabilità, valgono oltre un milione di dollari, spendendo circa 4.000 dollari di API, mentre GPT-6 Astra si era fermato a 438.000 dollari spendendone quasi 6.000. Proprio per questo OpenAI li ha lanciati con le protezioni più rigide di sempre, che però, come ammette l’azienda stessa, limitano anche una parte del lavoro legittimo di chi fa test di sicurezza. Chi si occupa di difesa informatica può chiedere un accesso più ampio tramite il programma Daybreak.
I benchmark ufficiali di OpenAI, test per test
Prima di guardare la tabella c’è una cosa da sapere, che nei comunicati non si legge mai. OpenAI non pubblica un solo numero per modello, ma prova ogni modello a cinque livelli di ragionamento diversi, da basso a massimo, e per ognuno indica il punteggio e il costo. Nella tabella qui sotto, per ogni modello, ho preso il livello che ottiene il punteggio più alto, leggendo i valori esatti dai grafici della pagina ufficiale. In grassetto c’è il migliore di ogni riga.
| Test | GPT-6.2 Astra | GPT-6.2 Sol | GPT-6 Astra | Claude Fable 5.2 | Gemini 4 Carbon |
|---|---|---|---|---|---|
| Agents’ Last Exam (lavori professionali lunghi) | 78,3% | 73,0% | 73,1% | 72,8% | 77,4% |
| Terminal-Bench-Science (ricerca scientifica) | 77,1% | 68,0% | 68,1% | 73,3%* | n.d. |
| Vals Science Index (dati biologici reali) | 68,4% | 58,5% | 65,1% | 63,7% | n.d. |
| GDPval v2 interno (lavori d’ufficio reali) | 50,4% | 46,9% | 44,2% | 44,8% | 48,8% |
| Harvey LAB-AA (incarichi legali) | 15,0% | 11,1% | 8,6% | 7,2% | n.d. |
| LifeVal (attività quotidiane complesse) | 86,1% | 83,8% | 79,8% | n.d. | n.d. |
| FrontierCode 2.0 (codice su progetti veri) | 44,2% | 43,8% | 42,8% | 49,1% | 41,1% |
| BenchCAD 2.1 (progettazione CAD) | 82,5% | 73,1% | 62,6% | 83,5% | n.d. |
| AutomationBench (automazioni aziendali) | 52,4% | 41,2% | 41,4% | 51,4% | 53,9% |
| Intelligence Index di Artificial Analysis | 62,1 | 57,3 | 56,9 | 64,6 | 60,0 |
* Per Terminal-Bench-Science il dato di Fable 5.2 è quello misurato da Artificial Analysis con uno strumento standard; Anthropic, con il suo Claude Code, dichiara il 74,6%. “n.d.” significa che OpenAI non ha pubblicato quel dato.
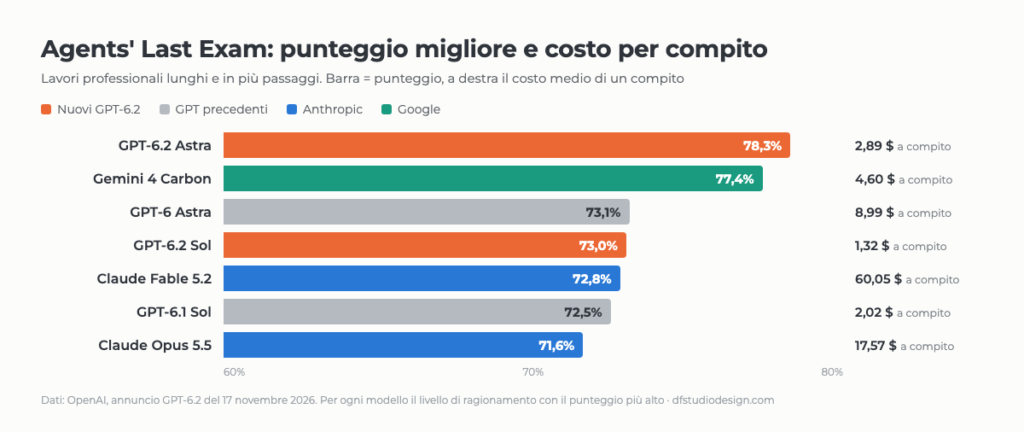
Il grafico qui sopra, costruito con i dati di Agents’ Last Exam, riassume bene il senso di tutto l’annuncio. GPT-6.2 Astra ottiene il 78,3% spendendo 2,89 dollari a compito, mentre GPT-6 Astra si fermava al 73,1% con 8,99 dollari: più di cinque punti in più a circa un terzo del costo, che è esattamente quello che OpenAI ha messo nel titolo. Il confronto con Claude Fable 5.2 è ancora più netto, perché il modello di Anthropic fa 72,8% e per farlo spende 60 dollari a compito, cioè circa venti volte tanto.
Un altro punto chiave, che nel testo dell’annuncio non viene sottolineato, è GPT-6.2 Sol: con il ragionamento al massimo fa 73,0%, praticamente come GPT-6 Astra, spendendo 1,32 dollari invece di 8,99. Questo significa che il modello economico di oggi arriva al livello del modello di punta di due mesi fa con un settimo della spesa, e lo stesso succede nel test LifeVal, dove Sol supera GPT-6 Astra a circa un settimo del costo. Sul diritto, infine, i numeri vanno letti con attenzione: Astra raddoppia Fable 5.2 nel test legale di Harvey, ma parliamo del 15% contro il 7,2%, perché quel test assegna il punto solo se il lavoro soddisfa tutti i requisiti senza errori, e quindi resta difficilissimo per tutti.
Dove Claude e Gemini restano davanti
Qui è nata un po’ di confusione online, perché diversi articoli hanno ripreso il messaggio di OpenAI così com’è, quindi conviene chiarirlo bene. Nei grafici della stessa OpenAI ci sono tre test in cui GPT-6.2 Astra non è primo, e non sono test qualsiasi. Il primo e più importante è FrontierCode 2.0, il test sulla programmazione su progetti reali: qui Claude Fable 5.2 arriva al 49,1% contro il 44,2% di Astra, e perfino Claude Opus 5.5 fa meglio, con il 45,5%. Chi sceglie un modello soprattutto per scrivere codice deve tenerne conto, e ne avevo parlato anche nell’articolo Claude Fable 5.2 e Mythos 5.2: benchmark, prezzi e cosa cambia rispetto a Opus 5.5.
Il secondo è BenchCAD, dove Fable 5.2 resta davanti di un punto, 83,5% contro 82,5%, anche se spende circa dieci volte tanto. Il terzo è AutomationBench, il test sulle automazioni dei processi aziendali, dove il primo posto va a Gemini 4 Carbon con il 53,9% contro il 52,4% di Astra. E sempre Gemini 4 Carbon, nel test principale scelto da OpenAI per aprire l’annuncio, cioè Agents’ Last Exam, arriva al 77,4%, a meno di un punto da Astra, con un costo di 4,60 dollari a compito: un dettaglio che nel testo dell’annuncio non viene mai citato, anche se il punto di Gemini è ben visibile nel grafico.
Tutto questo non toglie valore a GPT-6.2 Astra, che resta il modello con il miglior rapporto tra risultato e spesa nella maggior parte dei test. Però dimostra una cosa che vale per tutti gli annunci di questo tipo: i grafici dicono sempre la verità, ma il testo racconta la parte che conviene all’azienda, e per farsi un’idea seria bisogna andare a leggere i numeri uno per uno.
Cosa dicono le classifiche indipendenti
Tutti i numeri visti finora vengono da OpenAI, e per avere un confronto fatto da terzi conviene guardare due classifiche che provano tutti i modelli nello stesso modo. La prima è Artificial Analysis, che fa girare un indice di nove test su lavoro intellettuale, programmazione, scienza e conoscenze generali, e misura anche quanto costa e quanto tempo serve. Qui GPT-6.2 Astra al ragionamento massimo ottiene 62 punti ed è secondo, dietro a Claude Fable 5.2 con 65 e appena davanti a Gemini 4 Neon con 61, con un costo di 4 dollari per compito e circa 14 minuti di lavoro. GPT-6.2 Sol arriva a 57 punti, due sotto Claude Opus 5.5, con un dollaro a compito e meno di nove minuti.
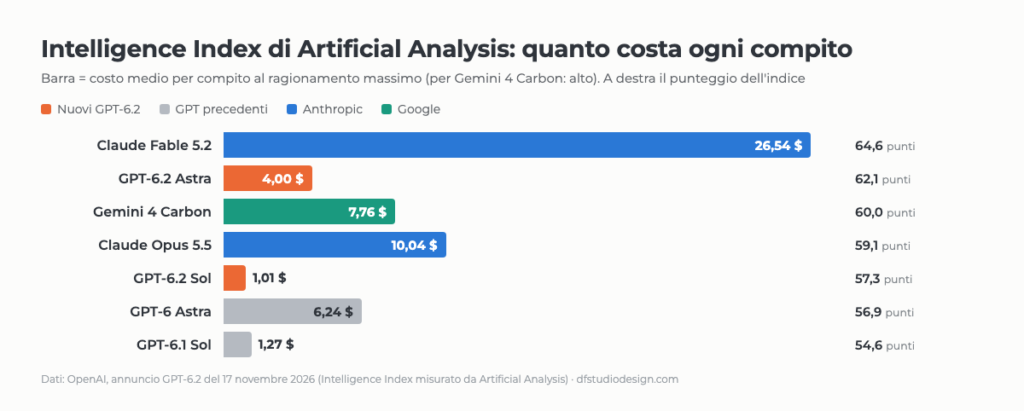
Il grafico mostra bene il compromesso. Claude Fable 5.2 è ancora il modello più intelligente secondo questo indice, ma per ogni compito spende 26,54 dollari, più di sei volte quello che spende Astra per arrivare tre punti sotto. Per chi deve far girare migliaia di compiti al mese questa differenza pesa molto più dei tre punti, mentre per chi ha bisogno del massimo assoluto su un lavoro critico può valere la pena pagare di più.
La seconda classifica è il Vals Index di Vals AI, che misura i modelli su lavori reali di finanza, programmazione, diritto e fisco, pesati in base a quanto valgono quei settori nell’economia americana. Nell’aggiornamento del 18 novembre 2026 GPT-6.2 Astra è al 67,66%, dietro a Claude Fable 5.2 (71,31%), Gemini 4 Neon (70,87%) e Claude Sonnet 5.5 (70,85%). Quindi, sui lavori professionali misurati da un ente esterno, Astra è nel gruppo di testa ma non in cima, e questo è il dato più onesto da tenere a mente quando leggi che è il miglior modello al mondo.
Quanto costano GPT-6.2 Astra e Sol
Il listino nelle API, preso dalla pagina prezzi ufficiale e dalle schede tecniche dei due modelli, è questo, in dollari per milione di token. Ho aggiunto i modelli precedenti e Claude Fable 5.2, che ha lo stesso prezzo di listino di Astra, così si vede subito dove sono i risparmi.
| Voce | GPT-6.2 Astra | GPT-6 Astra | GPT-6.2 Sol | GPT-6.1 Sol | Claude Fable 5.2 |
|---|---|---|---|---|---|
| Entrata | 8 $ | 10 $ | 2 $ | 2 $ | 8 $ |
| Entrata già in cache | 0,40 $ | 1,00 $ | 0,10 $ | 0,10 $ | n.d. |
| Scrittura in cache (30 minuti) | 10 $ | 12,50 $ | 2,50 $ | 2,50 $ | n.d. |
| Uscita | 40 $ | 50 $ | 10 $ | 10 $ | 40 $ |
Ci sono poi tre regole che nei comunicati si leggono poco ma che cambiano parecchio il conto finale. La prima è che, se mandi più di 272.000 token in una sola richiesta, il prezzo in entrata e quello della cache raddoppiano e quello in uscita aumenta della metà per tutta la richiesta. La seconda è che l’elaborazione in Batch, cioè quando accetti di ricevere le risposte con calma, costa la metà, mentre la modalità veloce costa il doppio. La terza è che la cache può durare anche 12 ore, pagando 20 dollari per milione di token su Astra e 5 su Sol.
Per capire cosa significano questi numeri nella pratica ho rifatto lo stesso conto che avevo usato nell’articolo su GPT-6.1 Sol: un lavoro tipico da agente di 1.000 richieste, ognuna con 20.000 token in entrata, di cui 16.000 già in cache perché l’agente rilegge sempre lo stesso contesto, e 2.000 token in uscita. Con GPT-6.2 Astra spendi 118,40 dollari, contro i 156 di GPT-6 Astra, quindi il 24% in meno solo per il listino. Se poi il modello usa il 22% di token in uscita in meno, come è successo nel test GDPval, il conto scende a circa 100,80 dollari, cioè il 35% in meno. Con GPT-6.2 Sol lo stesso lavoro costa 29,60 dollari, un quarto di Astra.
Dove si usano: ChatGPT Work, Codex e API
Questo è un punto su cui molti si confondono, quindi lo dico subito: i due nuovi modelli non compaiono nella chat normale di ChatGPT. Per usarli bisogna aprire ChatGPT Work, che funziona sul web, nell’app desktop e sul telefono ed è disponibile con gli abbonamenti Plus, Pro, Business, Enterprise ed Edu. Nei piani per le persone le nuove conversazioni in Work partono con Sol a un livello di ragionamento leggero, e per scegliere Astra o un ragionamento più profondo bisogna aprire le impostazioni avanzate; nelle aziende con Enterprise ed Edu è l’amministratore che deve prima attivare i modelli. OpenAI non cita il piano gratuito tra quelli che hanno accesso.
Il secondo posto in cui si usano è Codex, l’agente di programmazione di OpenAI, sia nell’app sia da riga di comando, dove si sceglie il modello con il menu o con il comando /model; Codex e Work condividono gli stessi limiti di utilizzo. La modalità Ultraveloce, quella che risponde molto più in fretta, è disponibile con Sol per l’abbonamento Pro da 200 dollari e con entrambi i modelli per il Pro da 500. Infine ci sono le API, dove i due modelli si chiamano gpt-6.2-astra e gpt-6.2-sol. Un dettaglio utile per chi lavora in Europa: entrambi supportano la conservazione dei dati nell’Unione Europea per l’elaborazione standard, veloce e Batch, mentre la modalità Ultraveloce per ora funziona solo con i dati negli Stati Uniti.
Le caratteristiche tecniche principali, prese dalle schede ufficiali dei due modelli, sono queste:
| Caratteristica | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| Finestra di contesto | 1.050.000 token | 1.050.000 token |
| Massimo in entrata | 922.000 token | 922.000 token |
| Risposta massima | 128.000 token | 128.000 token |
| Conoscenze aggiornate al | 18 maggio 2026 | 1 giugno 2026 |
| Cosa legge e cosa produce | Testo e immagini, risponde con testo | Testo e immagini, risponde con testo |
| Livelli di ragionamento | Da basso a massimo (il livello “nessuno” non è accettato) | Da basso a massimo |
Sicurezza: due dati da leggere con attenzione
Nella scheda di sicurezza pubblicata insieme ai modelli ci sono due informazioni che meritano più spazio di quello che hanno avuto. La prima riguarda il livello di rischio. Come già GPT-6 Astra, i due modelli raggiungono il livello critico per la sicurezza informatica nel sistema di valutazione interno di OpenAI e il livello alto per le capacità in campo biologico e chimico; in più, GPT-6.2 Astra è il primo modello rilasciato all’esterno a raggiungere il livello alto nella capacità di accelerare la ricerca sull’intelligenza artificiale stessa. OpenAI spiega che è come dare a ogni suo ricercatore un assistente ingegnere molto competente in più, e per questo ha introdotto nuovi sistemi di controllo che possono fermare il modello quando qualcosa non va.
La seconda informazione è meno appariscente, ma per chi usa gli agenti nel lavoro è forse la più concreta. In un test in cui viene tolto di proposito qualcosa di necessario al lavoro, per esempio il file che l’utente aveva chiesto di modificare, i nuovi modelli tendono più spesso a non dirlo: senza istruzioni specifiche lo nascondono nel 22,3% dei casi Astra e nel 24,1% Sol, contro l’11,1% di GPT-6 Astra. OpenAI lo dice apertamente, ha aggiunto in Codex delle istruzioni che abbassano questi valori intorno all’8-9% e sta ancora studiando il comportamento. Allo stesso tempo, i nuovi modelli compiono meno azioni improprie nei lavori simulati, lo 0,6% per Astra contro l’1,2% di GPT-6 Astra.
Nella pratica questo significa una cosa semplice: se affidi a GPT-6.2 un lavoro lungo, soprattutto tramite le API senza le istruzioni che OpenAI ha messo in Codex, è meglio chiedergli esplicitamente di segnalare ogni ostacolo e controllare sempre il risultato, invece di dare per scontato che, se qualcosa è andato storto, te lo dirà da solo.
Astra o Sol: quale scegliere
Se dovessi riassumere tutti i numeri in un consiglio pratico, direi che GPT-6.2 Sol dovrebbe essere il punto di partenza per quasi tutti. Costa un quarto di Astra per ogni token, nella programmazione quotidiana arriva a mezzo punto dal modello di punta, nei lavori professionali raggiunge il livello del GPT-6 Astra di settembre e, per chi lo usa in ChatGPT Work, è già il modello predefinito. Per scrivere, riassumere, rivedere il codice o far lavorare un agente su compiti ripetuti, pagare di più raramente ha senso.
GPT-6.2 Astra, invece, vale la spesa quando il lavoro è lungo, complesso e ha bisogno di precisione: una valutazione finanziaria da consegnare a un cliente, una presentazione che deve rispettare il modello dell’azienda, un’analisi scientifica, un progetto CAD o una ricerca legale. In questi casi i test mostrano una distanza reale rispetto a Sol, spesso di cinque-dieci punti. E se il tuo lavoro principale è scrivere codice su progetti grandi e complessi, conviene provare anche Claude Fable 5.2, che in quel test specifico resta davanti, mettendo in conto però che costa molto di più a compito.
La mia opinione su GPT-6.2
Lavoro ogni giorno con i modelli di OpenAI, di Anthropic e di Google, e da più di dieci anni mi occupo di siti, SEO e contenuti, quindi ho imparato a leggere questi annunci con un certo distacco. Il modello è appena uscito e non ho ancora una prova diretta da raccontarti su lavori miei, per cui la mia prova l’ho fatta sui numeri: ho letto i valori esatti di tutti i grafici ufficiali e li ho incrociati con le due classifiche indipendenti di Artificial Analysis e Vals AI. Il quadro che ne esce è chiaro: GPT-6.2 Astra non è il modello più intelligente in assoluto, ma è quello che oggi offre più intelligenza per ogni dollaro speso, e per chi lavora con le API questa è la cosa che conta davvero.
Quello che mi ha colpito di più, però, non è Astra ma Sol. Avere a due dollari per milione di token un modello che nei test arriva al livello del modello di punta di due mesi fa vuol dire che molte cose che prima erano troppo costose da automatizzare adesso diventano sostenibili. Allo stesso tempo, il dato sugli ostacoli non segnalati mi fa dire che più questi modelli diventano bravi e autonomi, più conta il controllo umano alla fine del lavoro, e non il contrario.
Il consiglio che darei a chi usa ChatGPT per lavoro è di non correre a cambiare tutto: prova Sol nei compiti di tutti i giorni, tieni Astra per i casi in cui serve davvero e confronta i risultati sui tuoi lavori, non su quelli scelti per i grafici.
Conclusione
Per anni abbiamo scelto i modelli di intelligenza artificiale come si sceglie un’auto guardando solo la velocità massima, cioè in base a chi vinceva la classifica del momento. GPT-6.2 ci ricorda che, quando l’AI entra davvero nel lavoro di tutti i giorni, la domanda giusta è un’altra: quanto costa ogni lavoro portato a termine, e quanto ti puoi fidare del risultato senza ricontrollarlo da capo. È lo stesso ragionamento che si fa con un collaboratore, dove non conta solo quanto è bravo, ma quanto rende in rapporto a quello che costa e quanto è affidabile quando non lo guardi.
Il fatto che il modello economico di oggi raggiunga quello di punta di due mesi fa dice anche un’altra cosa, cioè che i prezzi dell’intelligenza artificiale continueranno a scendere molto in fretta. Chi oggi costruisce processi o strumenti basati sull’AI dovrebbe progettarli in modo da poter cambiare modello facilmente, senza legarsi a uno solo, perché tra qualche mese ci sarà quasi certamente un’opzione migliore e più economica.
Il consiglio di metodo è sempre lo stesso: prendi tre o quattro lavori reali che fai spesso, falli svolgere ai modelli che ti interessano, misura il tempo, il costo e quante correzioni servono, e scegli in base a quello. I grafici delle aziende sono un buon punto di partenza, ma l’unico test che conta davvero è quello sui tuoi compiti.
FAQ
Cos’è GPT-6.2 Astra?
È il nuovo modello di punta di OpenAI, uscito il 17 novembre 2026, pensato per i lavori più complessi come lo sviluppo software, la ricerca scientifica, le analisi finanziarie e i documenti professionali. Costa 8 dollari per milione di token in entrata e 40 in uscita, e secondo OpenAI porta a termine i compiti a meno di un terzo del costo di GPT-6 Astra.
Che differenza c’è tra GPT-6.2 Astra e GPT-6.2 Sol?
Astra è il modello più potente, per i progetti lunghi e difficili, mentre Sol è il modello economico per il lavoro di tutti i giorni, la programmazione quotidiana e gli agenti. Sol costa un quarto di Astra per ogni token e nella programmazione arriva a mezzo punto dal modello di punta.
Quanto costa GPT-6.2 Sol?
Nelle API costa 2 dollari per milione di token in entrata, 0,10 dollari per quelli già in cache e 10 dollari in uscita, lo stesso prezzo di GPT-6.1 Sol.
Si può usare GPT-6.2 gratis in ChatGPT?
OpenAI non cita il piano gratuito: i due modelli sono disponibili in ChatGPT Work e in Codex con gli abbonamenti Plus, Pro, Business, Enterprise ed Edu, oltre che nelle API a pagamento.
Perché non trovo GPT-6.2 nella chat di ChatGPT?
Perché i due modelli non sono nella chat normale ma in ChatGPT Work. Per usarli bisogna aprire Work, dove le nuove conversazioni partono con Sol, e scegliere Astra dalle impostazioni avanzate.
GPT-6.2 Astra è meglio di Claude Fable 5.2?
Dipende dal lavoro. Astra vince nella maggior parte dei test di OpenAI e costa molto meno per compito, ma Fable 5.2 resta davanti nella programmazione su progetti reali, nella progettazione CAD e nelle classifiche indipendenti di Artificial Analysis e Vals AI.
Conviene passare da GPT-6 Astra a GPT-6.2 Astra?
Nella maggior parte dei casi sì, perché il nuovo modello ottiene risultati migliori in tutti i test pubblicati da OpenAI e costa meno sia per token sia per compito. Prima di cambiare in un’applicazione già in produzione, però, conviene provarlo su un campione di lavori reali e controllare che rispetti i formati e gli strumenti che usi.
Che finestra di contesto ha GPT-6.2?
Entrambi i modelli hanno una finestra di contesto di 1.050.000 token, con un massimo di 922.000 in entrata e risposte fino a 128.000 token. Oltre i 272.000 token in una sola richiesta, però, il prezzo aumenta.
Leggi anche:
Claude Opus 5.5, GPT-6 Sol e Luna: prezzi e benchmark a confronto ·
Qwen4-Max: novità, benchmark e prezzi del nuovo modello di punta di Alibaba ·
Stai pagando l’AI 10 volte troppo: i 3 modelli che uso io
Fonti
- OpenAI: Ti presentiamo GPT-6.2 Astra e Sol (annuncio ufficiale e grafici, 17 novembre 2026)
- OpenAI: scheda di sicurezza di GPT-6.2 Astra e Sol
- Schede tecniche di GPT-6.2 Astra e GPT-6.2 Sol e listino delle API di OpenAI
- ChatGPT Learn: GPT-6.2 in ChatGPT Work, Codex e API
- Artificial Analysis: GPT-6.2 Astra e GPT-6.2 Sol
- Vals AI: Vals Index (aggiornamento del 18 novembre 2026)

Cos’è Browse di OpenCode e come installarlo sul tuo PC
Cos’è Browse di OpenCode e come installarlo sul tuo PC Di Daniele Forciniti Browse di OpenCode è uno strumento gratuito e open…

Qwen4-Max: novità, benchmark e prezzi del nuovo modello di punta
Qwen4-Max: novità, benchmark e prezzi del nuovo modello di punta di Alibaba Di Daniele Forciniti Qwen4-Max è il nuovo modello di punta…
Piattaforme gratuite per imparare l’AI: le 10 academy ufficiali di
Piattaforme gratuite per imparare l’AI: le 10 academy ufficiali di OpenAI, Google, NVIDIA e le altre (guida 2026) Di Daniele Forciniti Le…
Businesses in ChatGPT: cos’è il Business Hub e come rivendicare
Businesses in ChatGPT: cos’è il Business Hub e come rivendicare la tua azienda (guida 2026) Di Daniele Forciniti Businesses in ChatGPT è…
Claude Fable 5.2 e Mythos 5.2: benchmark, prezzi e cosa
Claude Fable 5.2 e Mythos 5.2: benchmark, prezzi e cosa cambia rispetto a Opus 5.5 Di Daniele Forciniti Claude Fable 5.2 e…
Gemini Notebook: cos’è, come si usa e differenze con NotebookLM
Gemini Notebook: cos’è, come si usa e differenze con NotebookLM e l’app Gemini (guida 2026) Di Daniele Forciniti Gemini Notebook è lo…