
Qwen4-Max: novità, benchmark e prezzi del nuovo modello di punta di Alibaba
Di Daniele Forciniti
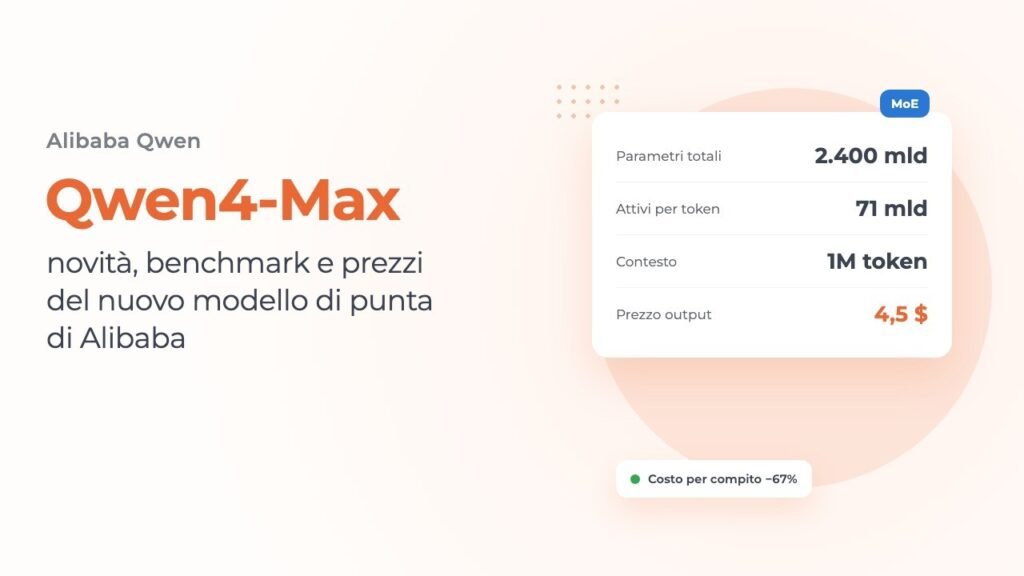
Qwen4-Max è il nuovo modello di punta di Alibaba, uscito il 16 novembre 2026: un modello a esperti (MoE) da 2.400 miliardi di parametri, di cui 71 miliardi attivi per ogni token, che legge testo, immagini e video e lavora con un contesto da 1 milione di token. Non è open-weight: si usa via API su QwenCloud o dentro le app di Alibaba. Costa 1,5 dollari per milione di token in input e 4,5 in output, meno del modello precedente, e secondo i test indipendenti di Artificial Analysis porta a termine un compito con 3,27 dollari, il 67% in meno di Qwen3.8-Max. Nei benchmark è molto forte nel lavoro da agente e nei compiti legali, ma resta dietro a Claude Opus 5.5 e ai modelli di OpenAI in parecchi test, soprattutto di programmazione.
Cosa porta di nuovo rispetto a Qwen3.8-Max
Alibaba lo presenta come un “collega AI” che lavora 24 ore su 24 e porta avanti i progetti da solo. Al di là dello slogan, il blog ufficiale del team Qwen descrive un cambio vero: Qwen4-Max è il primo modello costruito sulla nuova architettura della serie Qwen4, e non una versione allenata di più della generazione precedente.
La dimensione totale è la stessa di Qwen3.8-Max, 2.400 miliardi di parametri, ma per ogni parola da scrivere il modello ne usa 71 miliardi invece di circa 95: il 25% in meno. Un modello a esperti funziona così: dentro ci sono tanti “specialisti” e per ogni token ne vengono chiamati solo alcuni. Meno parametri attivi vuol dire risposte più economiche da produrre, ed è da qui che arriva buona parte del taglio dei prezzi.
Le novità tecniche sono tre, e provo a dirle in modo semplice:
- Un nuovo modo di leggere i testi lunghi. Invece di rileggere tutto il contesto a ogni parola, alcuni strati (Gated DeltaNet) riassumono la storia in uno spazio fisso, e un sistema di attenzione sparsa (Qwen Sparse Attention) va a prendere solo i pezzi che servono. È quello che permette di reggere 1 milione di token senza far esplodere i costi.
- Collegamenti interni più robusti. Quattro “corsie” parallele fanno passare le informazioni da uno strato all’altro e rendono l’addestramento più stabile. Alibaba dice che in tutto l’allenamento a 2.400 miliardi di parametri non ci sono stati picchi anomali nella curva di apprendimento, cosa rara a questa scala.
- Una memoria delle sequenze frequenti. Ci sono altri 328 miliardi di parametri (N-gram Embedding) che funzionano come un dizionario di combinazioni di parole ricorrenti, consultato quasi a costo zero.
| Caratteristica | Qwen4-Max |
|---|---|
| Architettura | Mixture-of-Experts (modello a esperti), nuova generazione Qwen4 |
| Parametri totali | 2.400 miliardi, più 328 miliardi di N-gram Embedding |
| Parametri attivi per token | 71 miliardi (Qwen3.8-Max circa 95) |
| Contesto | 1 milione di token (fino a 991.000 in input) |
| Risposta massima | 393.000 token |
| Cosa legge | Testo, immagini e video |
| Cosa scrive | Testo e codice |
| Pesi | Non scaricabili, modello chiuso |
| Uscita | 16 novembre 2026 |
Meno token per lo stesso lavoro
Il punto su cui Alibaba insiste di più è l’efficienza. I modelli di ragionamento “pensano” scrivendo, e ogni parola pensata è un token che si paga. Qwen4-Max ha diversi livelli di impegno (Low, High, Xhigh): sul test interno Work360 usa il 24% di token in meno a livello Xhigh e il 35% in meno a livello High rispetto a Qwen3.8-Max, e su Terminal-Bench 4.0 il risparmio arriva al 48-49%. Con prezzi più bassi e meno token, il costo medio per compito su Work360 scende da 4,43 a 1,67 dollari secondo Alibaba.
Work360 è un test costruito da Alibaba stessa: copre 26 grandi settori, 182 sottosettori e 721 specializzazioni professionali, e misura quanto il modello sa portare a termine lavori reali di quei mestieri. Qwen4-Max fa 52,69 punti contro i 47,74 della versione precedente. È un buon segnale, ma resta un test di casa: per questo più sotto guardo anche i numeri di chi il modello non lo vende.
Sicurezza: codice più sicuro e dati filtrati
Una parte dell’annuncio è dedicata alla sicurezza. Alibaba dice di aver tolto dai dati di addestramento il materiale che serve ad attaccare sistemi informatici, tenendo quello utile alla difesa (trovare e correggere vulnerabilità). Sul codice i numeri sono concreti: nel test Last Secure Code Bench la quota di funzioni scritte in modo corretto e sicuro sale dal 22,0% al 31,8%, e il codice sicuro a tutti i livelli (funzione, file e progetto) passa dall’8% al 14,7%. Quasi il doppio, ma vuol dire anche che la grande maggioranza del codice generato va ancora controllata.
I benchmark: dove vince e dove resta indietro
La tabella dell’annuncio mette Qwen4-Max contro Qwen3.8-Max, Claude Opus 5.5, GPT-6.1 Sol, GPT-6 Astra e Kimi K3.1 Pro su 16 test. Un dettaglio che conta: non tutti i numeri li ha misurati Alibaba. Quelli di AA-Briefcase e AutomationBench vengono da Artificial Analysis, CodeArena e AgentArena dalle classifiche di Arena, HLAB dal Vals Index, APEX-Agents dalla classifica di Mercor. Per una tabella di un produttore è una scelta più trasparente del solito.
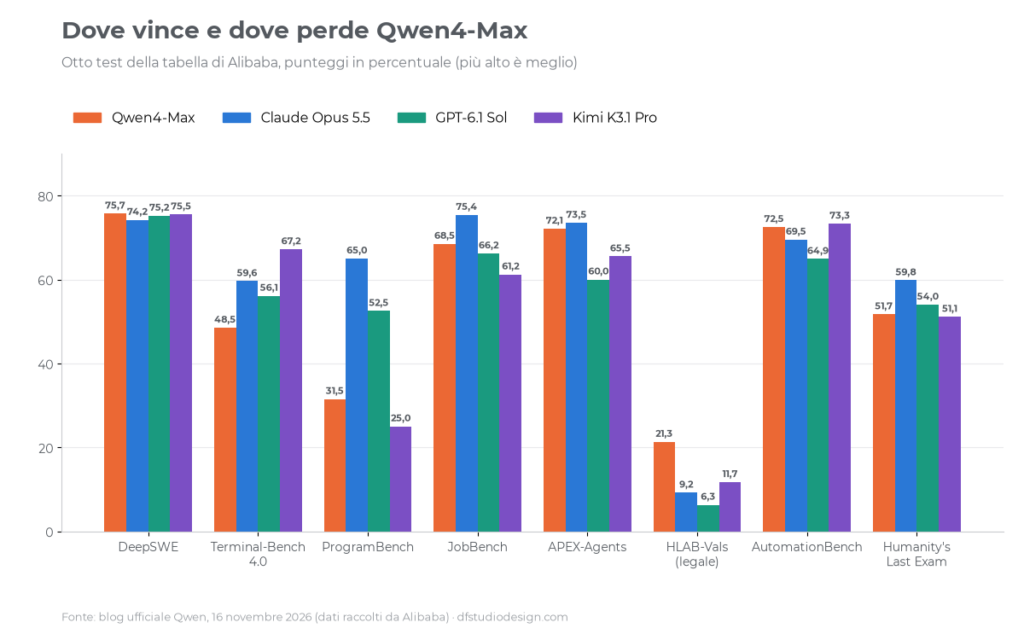
Ecco tutti i 16 test, con il miglior risultato in grassetto. CodeArena e AA-Briefcase sono punteggi Elo, quelli delle classifiche a confronto diretto: più alto è meglio, ma non sono percentuali.
| Test | Qwen4-Max | Claude Opus 5.5 | GPT-6.1 Sol | GPT-6 Astra | Kimi K3.1 Pro |
|---|---|---|---|---|---|
| DeepSWE v1.1 programmazione da agente | 75,7 | 74,2 | 75,2 | 74,1 | 75,5 |
| CodeArena (Elo) sviluppo web | 1750 | 1816 | 1742 | 1763 | 1686 |
| Terminal-Bench 4.0 lavoro al terminale | 48,5 | 59,6 | 56,1 | 59,1 | 67,2 |
| ProgramBench ricostruire un software | 31,5 | 65,0 | 52,5 | 55,0 | 25,0 |
| AA-Briefcase (Elo) lavoro d’ufficio da agente | 1686 | 1801 | 1555 | 1569 | 1674 |
| Agents’ Last Exam compiti lunghi e di valore | 46,7 | 43,4 | n.d. | 42,6 | 43,4 |
| JobBench compiti di lavoro reali | 68,5 | 75,4 | 66,2 | 66,1 | 61,2 |
| APEX-Agents servizi professionali | 72,1 | 73,5 | 60,0 | 64,7 | 65,5 |
| HLAB-Vals lavoro legale da agente | 21,3 | 9,2 | 6,3 | 7,1 | 11,7 |
| AutomationBench flussi su software aziendali | 72,5 | 69,5 | 64,9 | 68,5 | 73,3 |
| AgentArena compiti reali, miglioramento netto | 7,5 | 18,2 | 11,8 | 13,9 | 3,9 |
| BioMysteryBench ricerca bioinformatica | 85,0 | 81,9 | 84,4 | 78,9 | 80,6 |
| HealthBench Professional ragionamento clinico | 60,0 | 59,9 | 65,1 | 66,0 | 57,2 |
| Humanity’s Last Exam domande difficilissime | 51,7 | 59,8 | 54,0 | 53,6 | 51,1 |
| Chartography leggere grafici | 54,2 | 66,3 | 67,8 | 71,1 | 50,0 |
| Video-Index capire i video | 68,1 | 74,8 | 73,8 | 76,7 | 63,2 |
Nella tabella originale, per Agents’ Last Exam c’è un solo modello OpenAI: dal colore della barra è GPT-6 Astra, quindi per GPT-6.1 Sol ho lasciato “n.d.”. Fatti i conti, Claude Opus 5.5 è primo in 7 test su 16, Qwen4-Max in 4, i modelli OpenAI in 3 e Kimi K3.1 Pro in 2.
Dove è davvero forte
- Lavoro legale da agente (HLAB-Vals): 21,3 contro l’11,7 di Kimi e il 9,2 di Opus 5.5, quasi il doppio del secondo. Attenzione però ai valori assoluti: anche il migliore risolve circa un compito su cinque, quindi nessun modello è pronto a fare l’avvocato da solo.
- Compiti lunghi (Agents’ Last Exam): 46,7, primo davanti a Opus 5.5 e Kimi (43,4). Rispetto a Qwen3.8-Max (27,9) è il salto più grande di tutta la tabella.
- Ricerca scientifica (BioMysteryBench): 85,0, primo con un margine piccolo.
- Programmazione da agente (DeepSWE): primo con 75,7, ma i sei modelli stanno tutti tra 74 e 75,7. È un pareggio, non una vittoria.
Dove resta indietro
- Lavoro al terminale (Terminal-Bench 4.0): 48,5 contro il 67,2 di Kimi K3.1 Pro e il 59,6 di Opus 5.5. È il test più vicino al lavoro quotidiano di chi programma con un agente, e qui il distacco è grande.
- Ricostruire un software (ProgramBench): 31,5 contro il 65,0 di Opus 5.5, cioè meno della metà.
- Vista: nonostante la “visione nativa”, su grafici e video è dietro a tutti i modelli occidentali della tabella.
- Compiti reali giudicati dalle persone (AgentArena): 7,5 di miglioramento netto contro il 18,2 di Opus 5.5.
Per avere un’idea di dove si colloca, il confronto più utile è con Kimi K3.1 Pro: novità, benchmark e prezzi del modello open-weight che sfida Opus 5.5, l’altro grande modello cinese uscito a ottobre: Kimi è nettamente più forte al terminale, Qwen4-Max nei compiti professionali e legali.
Il voto di chi non lo vende
La verifica che faccio sempre è guardare una classifica indipendente. Artificial Analysis ha già misurato Qwen4-Max con il suo Intelligence Index, che mette insieme nove test di agenti, programmazione, conoscenza e scienza. Il risultato è 43 punti: un salto netto rispetto ai 34 di Qwen3.8-Max, sopra il valore medio dei modelli della stessa fascia di prezzo (41), ma lontano dai primi.
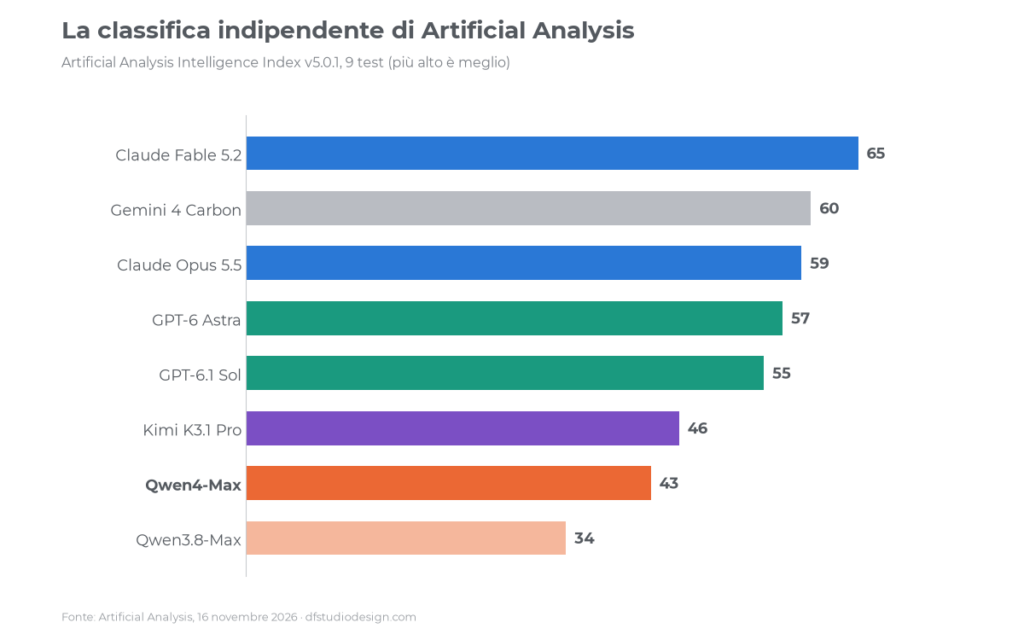
In questa classifica Claude Fable 5.2 fa 65, Gemini 4 Carbon 60, Claude Opus 5.5 59, GPT-6 Astra 57, GPT-6.1 Sol 55 e Kimi K3.1 Pro 46. Qwen4-Max è quindi un modello di fascia media alta, non uno che gioca alla pari con i migliori. Il messaggio di alcuni titoli (“batte Opus 5.5 nella programmazione”) regge solo su DeepSWE, dove la differenza è di un punto e mezzo.
Prezzi di Qwen4-Max: il listino e il costo reale per compito
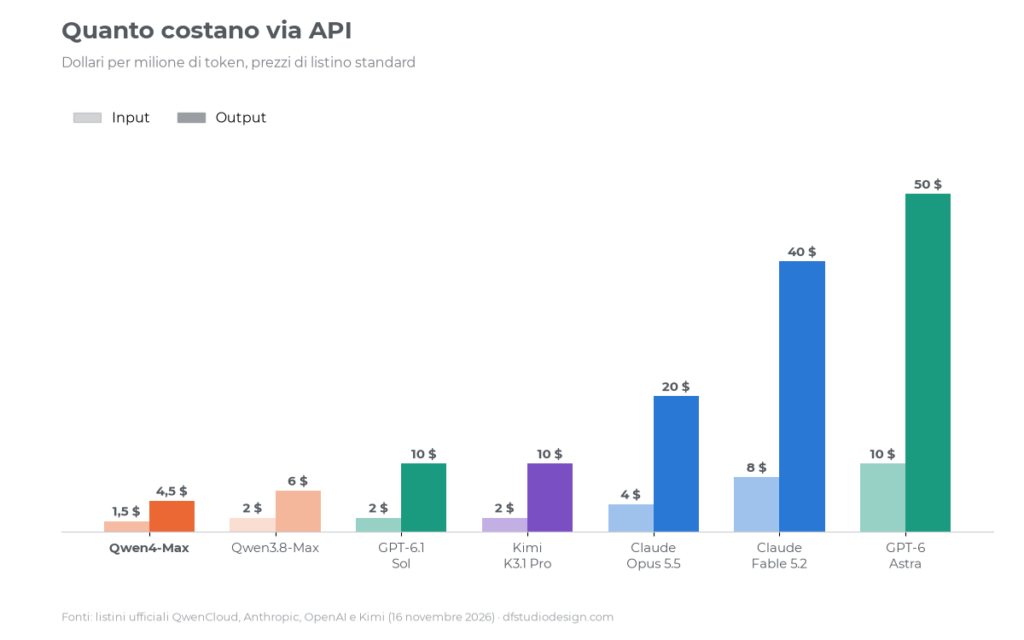
Sul listino ufficiale di QwenCloud i prezzi sono più bassi di quelli di Qwen3.8-Max su tutte le voci, e la cache (lo sconto sulle parti del testo che si ripetono da una richiesta all’altra) scende del 70%.
| Modello | Input | Output | Input in cache |
|---|---|---|---|
| Qwen4-Max | 1,5 $ | 4,5 $ | 0,075 $ |
| Qwen3.8-Max | 2 $ | 6 $ | 0,25 $ |
| GPT-6.1 Sol | 2 $ | 10 $ | 0,10 $ |
| Kimi K3.1 Pro | 2 $ | 10 $ | 0,20 $ |
| Claude Opus 5.5 | 4 $ | 20 $ | 0,20 $ |
| Claude Fable 5.2 | 8 $ | 40 $ | 0,20 $ |
| GPT-6 Astra | 10 $ | 50 $ | 1 $ |
Prezzi in dollari per milione di token, controllati sui listini ufficiali il 16 novembre 2026. Per Qwen4-Max c’è anche la cache esplicita, quella che si attiva a mano: creare la cache costa 1,875 dollari per milione di token se dura 5 minuti e 3 dollari se dura un’ora, rileggerla 0,075 dollari.
Il prezzo per token non basta
Sulla carta Qwen4-Max è il più economico della tabella. Ma quello che si paga davvero è il compito finito, e lì entra in gioco quanto il modello “parla”. Artificial Analysis ha misurato anche questo: per completare i test del suo indice Qwen4-Max ha prodotto 127 milioni di token, contro un valore medio di 78,6 milioni per i modelli comparabili. Meno dei 150 milioni di Qwen3.8-Max, quindi il risparmio dichiarato da Alibaba c’è, ma resta un modello che scrive molto.
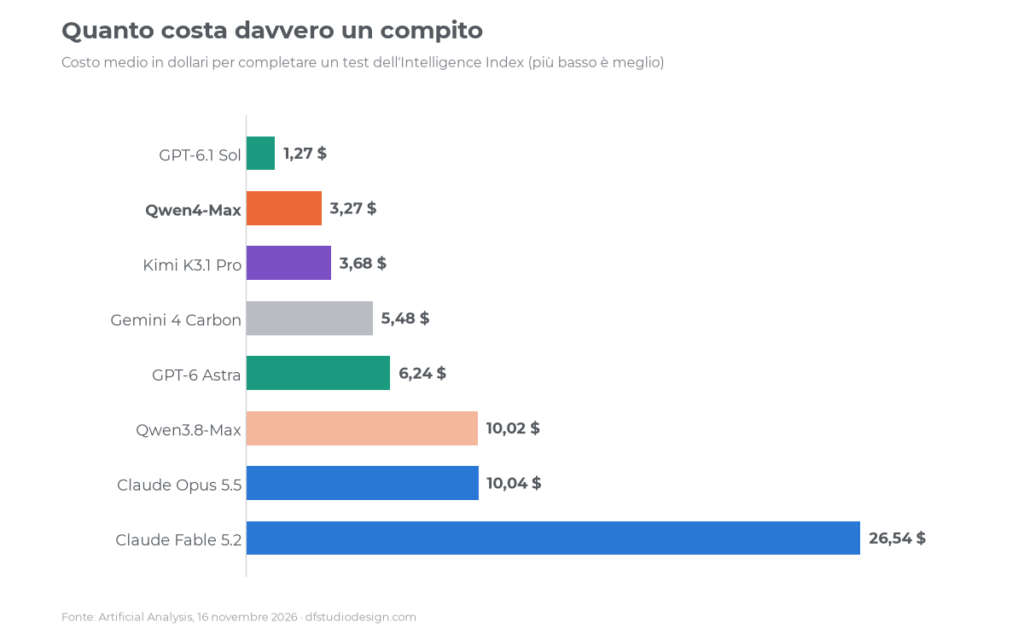
Il risultato è questo: 3,27 dollari per compito, un terzo di Qwen3.8-Max (10,02) e di Claude Opus 5.5 (10,04), poco meno di Kimi K3.1 Pro (3,68). Però GPT-6.1 Sol fa lo stesso lavoro con 1,27 dollari e prende 55 punti invece di 43: costa meno della metà ed è più bravo. Messo in pratica, mille compiti come quelli del test costano circa 1.270 dollari con GPT-6.1 Sol, 3.270 con Qwen4-Max e 10.040 con Opus 5.5.
Il modello giusto, insomma, non è quello con il listino più basso, ma quello che chiude il lavoro bene con meno passaggi. Ed è un conto che si può fare solo sui propri compiti, perché quanto un modello “parla” cambia molto da un tipo di lavoro all’altro.
Dove si usa e come provarlo
Qwen4-Max non si scarica. Si usa in quattro modi:
- Qwen Studio: la chat di Alibaba, dal browser o dalle app. È il modo più semplice per provarlo senza scrivere una riga di codice.
- QwenWork e Qoder: il primo è la piattaforma di Alibaba per il lavoro d’ufficio, che trasforma una richiesta in documenti, presentazioni, pagine web, immagini e video; il secondo è un ambiente di programmazione con agente, che funziona anche dentro VS Code e JetBrains. Alibaba dice di aver sviluppato il modello insieme ai team di questi prodotti, partendo dal modo in cui le persone li usano.
- API di QwenCloud: a consumo, con il nome di modello
qwen4-max. È compatibile con il formato delle API di OpenAI e di Anthropic, quindi si collega ai programmi che già le usano cambiando indirizzo e chiave. Ha strumenti integrati come ricerca web, lettura di pagine ed esecuzione di codice. - Token Plan: un abbonamento a crediti mensili, in quattro livelli per i singoli (Lite, Essential, Standard e Pro) e a postazioni per i team. Funziona dentro Claude Code, Cursor, Codex, Qoder, Qwen Code e OpenClaw. Per i team Alibaba garantisce che i dati non vengono usati per addestrare i modelli.
C’è poi una funzione nuova, Live Delivery: invece di sparire per ore e tornare con il lavoro finito, l’agente consegna presto una prima versione usabile e la migliora a tappe, mentre tu puoi correggere la rotta in qualsiasi momento. Alibaba ha pubblicato il plugin Live Delivery su GitHub come open source.
Sui pesi: Qwen4-Max resta chiuso. Alibaba ha detto che i modelli più piccoli della famiglia Qwen4 saranno pubblicati come open source, ma senza una data. Chi vuole un modello Qwen da installare sui propri computer per ora deve aspettare.
A chi può servire davvero
- A chi fa tanto lavoro documentale: contratti, due diligence, analisi finanziarie, cartelle cliniche. È l’area dove Qwen4-Max va meglio, e nell’annuncio c’è un esempio concreto: 198 documenti in disordine riordinati in 14 cartelle e trasformati in una relazione di 86 pagine, con ogni conclusione collegata al documento da cui viene. Il controllo di un professionista resta obbligatorio, come dice Alibaba stessa.
- A chi fa girare molti agenti e guarda i costi: con 3,27 dollari a compito è nella fascia economica, vicino a Kimi K3.1 Pro.
- Non a chi programma soprattutto da terminale: qui Kimi K3.1 Pro, Claude Opus 5.5 e Claude Fable 5.2 sono un’altra categoria.
- Non a chi vuole il modello in casa: i pesi non ci sono. Se i dati non possono uscire dall’azienda, conviene aspettare i modelli Qwen4 piccoli o usare un modello open-weight.
Per un’azienda italiana c’è anche un aspetto pratico da non dimenticare: i dati passano dai server di Alibaba Cloud. Prima di metterci dentro documenti di clienti, contratti o dati sanitari, va verificato con chi si occupa di privacy in azienda dove vengono trattati e con quali garanzie.
Vale la pena provarlo? La mia opinione
Faccio questo lavoro da più di dieci anni e, da quando seguo da vicino i modelli AI, ho preso un’abitudine: non fidarmi mai di una tabella sola. Qui la tabella di Alibaba e la classifica indipendente raccontano due storie un po’ diverse, ed è proprio la differenza la cosa interessante.
Il passo avanti è reale. Passare da 34 a 43 punti su Artificial Analysis e tagliare di due terzi il costo per compito in una sola generazione è un risultato serio. Il salto su Agents’ Last Exam, da 27,9 a 46,7, dice che il modello regge lavori lunghi molto meglio di prima.
Però il racconto “batte i modelli americani” non regge. Qwen4-Max vince dove i test premiano la gestione di tanti documenti e passaggi, e perde nettamente dove serve precisione tecnica: terminale, ricostruzione di software, lettura di grafici. E sul piano dei costi, che è il suo argomento più forte, GPT-6.1 Sol fa meglio sia come qualità sia come spesa per compito.
Io lo proverei su un caso preciso: analisi di documenti lunghi, dove il contesto da un milione di token e i punti forti legali e professionali contano davvero. Per programmare non sarebbe la mia prima scelta.
Conclusione
Con Qwen4-Max diventa ancora più chiaro un cambio che si vede da qualche mese: la gara tra modelli non si gioca più sul prezzo per milione di token, ma su quanto costa un lavoro finito e fatto bene. Un modello che costa poco a token ma scrive il doppio, o che sbaglia e deve rifare, alla fine costa di più.
Per chi usa l’AI in un’attività il consiglio è sempre lo stesso: prima di cambiare modello, prendere venti compiti veri del proprio lavoro e misurare tre cose, cioè qualità del risultato, tempo e spesa. Le tabelle servono a scegliere cosa provare, non a decidere. E per i lavori delicati, legali, finanziari o medici, il controllo umano resta parte del processo, qualunque modello si usi.
FAQ
Cos’è Qwen4-Max?
È il modello di punta di Alibaba, uscito il 16 novembre 2026. È un modello a esperti da 2.400 miliardi di parametri, con 71 miliardi attivi per token, contesto da 1 milione di token, e legge testo, immagini e video. È pensato soprattutto per lavori da agente lunghi e per compiti professionali.
Qwen4-Max è open source?
No. I pesi non sono scaricabili e il modello si usa solo via API o nelle app di Alibaba. Alibaba ha annunciato che i modelli più piccoli della famiglia Qwen4 saranno open source, senza indicare una data.
Quanto costa?
Via API costa 1,5 dollari per milione di token in input, 4,5 in output e 0,075 per l’input in cache. Secondo Artificial Analysis il costo medio per completare un compito del suo indice è di 3,27 dollari. In alternativa c’è il Token Plan, un abbonamento a crediti mensili.
È meglio di Claude Opus 5.5?
In generale no. Nella tabella di Alibaba Opus 5.5 vince 7 test su 16 e Qwen4-Max 4, e nella classifica di Artificial Analysis Opus fa 59 punti contro 43. Qwen4-Max è più forte nei compiti legali e nei lavori lunghi da agente, e costa circa un terzo per compito.
Cosa cambia rispetto a Qwen3.8-Max?
Nuova architettura, il 25% di parametri attivi in meno, prezzi più bassi su tutte le voci e meno token per lo stesso lavoro. Su Artificial Analysis passa da 34 a 43 punti e il costo per compito scende da 10,02 a 3,27 dollari.
Si può usare con Claude Code o Cursor?
Sì. Le API di QwenCloud sono compatibili con i formati di OpenAI e Anthropic, e il Token Plan è pensato proprio per strumenti come Claude Code, Cursor, Codex e Qoder.
Come si prova senza programmare?
Dalla chat Qwen Studio, sul sito o nelle app, oppure da QwenWork, la piattaforma per documenti, presentazioni e altri lavori d’ufficio.
Leggi anche:
Claude Opus 5.5, GPT-6 Sol e Luna: prezzi e benchmark a confronto ·
Gemini 4 Carbon: novità, benchmark e prezzi del modello più potente di Google ·
MiniMax M3.1 Flash: novità, prezzi e benchmark del modello cinese per agenti AI
Fonti
- Qwen Team: Qwen4-Max, Your New Teammate Has Arrived (annuncio ufficiale, 16 novembre 2026)
- QwenCloud: scheda e listino di Qwen4-Max e listino di Qwen3.8-Max
- Artificial Analysis: Qwen4 Max e Qwen3.8 Max: indice, costo per compito e token usati
- QwenCloud: panoramica del Token Plan
- Alibaba Qwen su X: annuncio del lancio
- Listini ufficiali di Anthropic, OpenAI e Kimi

GPT-6.2 Astra e Sol: cosa cambia, quanto costano e come
GPT-6.2 Astra e Sol: cosa cambia, quanto costano e come vanno davvero nei test Di Daniele Forciniti GPT-6.2 Astra e GPT-6.2 Sol…

Cos’è Browse di OpenCode e come installarlo sul tuo PC
Cos’è Browse di OpenCode e come installarlo sul tuo PC Di Daniele Forciniti Browse di OpenCode è uno strumento gratuito e open…
Piattaforme gratuite per imparare l’AI: le 10 academy ufficiali di
Piattaforme gratuite per imparare l’AI: le 10 academy ufficiali di OpenAI, Google, NVIDIA e le altre (guida 2026) Di Daniele Forciniti Le…
Businesses in ChatGPT: cos’è il Business Hub e come rivendicare
Businesses in ChatGPT: cos’è il Business Hub e come rivendicare la tua azienda (guida 2026) Di Daniele Forciniti Businesses in ChatGPT è…
Claude Fable 5.2 e Mythos 5.2: benchmark, prezzi e cosa
Claude Fable 5.2 e Mythos 5.2: benchmark, prezzi e cosa cambia rispetto a Opus 5.5 Di Daniele Forciniti Claude Fable 5.2 e…
Gemini Notebook: cos’è, come si usa e differenze con NotebookLM
Gemini Notebook: cos’è, come si usa e differenze con NotebookLM e l’app Gemini (guida 2026) Di Daniele Forciniti Gemini Notebook è lo…